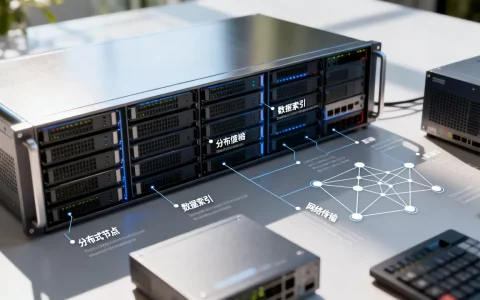
分层混合式存储系统通过将高频访问的热数据存储在高性能介质(如NVMe SSD)中,并将低频访问的冷数据自动迁移至低成本介质(如HDD或云存储),实现了存储性能、容量与成本之间的最优平衡。
混合存储与全闪存存储的区别及选型逻辑
在构建数据中心架构时,决策者经常面临性能与预算的博弈,理解混合存储与全闪存存储的区别是进行架构设计的首要前提。


介质响应速度与IOPS表现
全闪存存储系统(All-Flash Array, AFA)完全基于闪存介质,其核心优势在于极低的延迟和极高的IOPS(每秒输入/输出操作次数),在处理高并发、小文件随机读写业务(如核心交易数据库)时,全闪存能提供微秒级的响应。
相比之下,分层混合式存储系统引入了机械硬盘(HDD)作为容量层,虽然HDD的随机读写性能远低于SSD,但通过智能分层算法,系统可以将关键的元数据和热点数据保留在闪存层,从而在宏观上模拟出接近全闪存的性能表现,业内专家指出,对于数据分布极度不均(即80/20原则,即20%的热数据贡献了80%的访问量)的业务场景,混合存储的性价比远高于全闪存。
成本模型与容量扩展性
全闪存存储的单GB成本目前仍高于混合存储,当企业面临PB级甚至EB级的数据增长时,单纯依靠全闪存进行扩容会导致资本支出(CAPEX)呈指数级上升。
混合存储通过“性能层+容量层”的组合,利用廉价的大容量HDD来承载海量冷数据,这种架构允许企业在不牺牲核心业务性能的前提下,以较低的成本实现数据的长期留存。
存储介质性能对比参考
| 维度 | NVMe SSD (高性能层) | SAS/SATA SSD (中性能层) | 企业级 HDD (容量层) | 混合存储系统 (整体) |
|---|---|---|---|---|
| 典型延迟 | < 100 μs | 1-5 ms | 10-20 ms | 动态平衡 (取决于热度) |
| 随机读写性能 | 极高 | 中等 | 低 | 高 (针对热数据) |
| 单位容量成本 | 最高 | 中等 | 最低 | 极具竞争力 |
| 主要应用场景 | 核心数据库、AI训练 | 虚拟化、应用服务器 | 备份、归档、监控视频 | 通用企业级存储 |

分层混合式存储系统方案怎么选:从业务需求到架构设计
在面对复杂的业务环境时,分层混合式存储系统方案怎么选不能仅看品牌,而应从数据特征、算法能力和扩展性三个维度进行深度评估。
数据特征与访问模式分析
在设计方案前,必须对业务数据进行画像分析,通过对历史IO流的监测,可以识别出数据的“生命周期”。
- 热数据(Hot Data):频繁读写的业务数据,如当前的交易记录、实时分析流,这类数据必须驻留在闪存层。
- 温数据(Warm Data):访问频率中等的历史数据,如近一个月的报表数据。
- 冷数据(Cold Data):极少访问的归档数据,如三年前的审计日志。
如果业务数据呈现明显的周期性或长尾效应,分层存储方案将展现出巨大的价值。
自动化分层算法的实现机制
优秀的混合存储系统不应依赖人工干预,而应具备高度自动化的分层能力(Auto-tiering),行业共识认为,算法的智能化程度直接决定了系统的有效性。
高效的算法通常包含以下逻辑:
- 实时监控:持续跟踪每个数据块(Block)或文件(File)的访问频率。
- 阈值触发:当某个数据块的访问频率超过预设阈值时,系统自动将其从HDD层“提升”至SSD层。
- 降级策略:当数据长时间未被访问,系统自动执行“降级”操作,将其迁移至低成本介质。

硬件层级的构建标准
在实际部署中,建议采用多级分层架构,而非简单的两层结构,一个成熟的架构通常包含:
- 极速层(Performance Tier):使用NVMe SSD,负责承载元数据和极热数据。
- 平衡层(Capacity Flash Tier):使用SATA/SAS SSD,负责承载温数据。
- 容量层(Capacity Tier):使用大容量氦气驱动器(Helium HDD)或对象存储,负责承载冷数据。
企业级分层存储成本优化策略与性能调优
实现存储降本增效的核心在于通过精细化管理,提升每一分钱投入的产出比,以下是企业级分层存储成本优化策略的具体实施路径。
场景化应用:海量非结构化数据处理
在媒体、医疗或科研领域,存在大量非结构化数据(如高清视频、医学影像),这些数据在产生初期需要快速写入和检索,但随后会进入长期的静默期。
通过配置分层策略,可以实现:
- 写入加速:利用SSD层作为写入缓存(Write Buffer),吸收突发的高速写入流。
- 自动归档:在数据产生30天后,自动将原始文件从SSD迁移至HDD,仅在SSD保留索引信息。
解决分层存储性能瓶颈的实操步骤
虽然分层存储能平衡成本,但如果配置不当,可能会出现“数据迁移风暴”或“冷数据读取延迟过高”的问题,以下是分层存储性能瓶颈解决办法的标准化操作流程:
- 优化迁移窗口:避免在业务高峰期进行大规模的数据层级迁移,应通过调度策略,将数据重分布任务安排在业务低谷期(如凌晨2:00-5:00)。
- 调整分层粒度:如果分层粒度过大(如按文件分层),会导致小文件频繁迁移,增加系统开销;若粒度过小(如按Block分层),则会增加元数据管理的复杂度,建议根据业务类型选择合适的粒度。
- 预热机制配置:针对有规律的业务(如每周一早晨的报表生成),提前通过脚本或策略将相关数据从冷层“预热”到热层。

自动化策略配置示例
在现代软件定义存储(SDS)环境中,管理员通常通过命令行或管理界面配置策略,以下是一个模拟的逻辑配置路径:
# 步骤1:定义存储池层级
create-storage-pool --name DataPool_01 --tier-1 nvme_ssd --tier-2 sas_hdd
# 步骤2:设置热数据阈值(访问频率 > 50次/分钟)
set-tiering-policy --pool DataPool_01 --hot-threshold 50 --action promote
# 步骤3:设置冷数据迁移策略(30天未访问则降级)
set-tiering-policy --pool DataPool_01 --cold-threshold 30d --action demote
# 步骤4:验证当前分层分布情况
show-tiering-status --pool DataPool_01 --detail
通过上述配置,系统能够实现对数据生命周期的全自动闭环管理。
分层混合式存储系统常见问题解答
分层混合式存储系统如何处理数据迁移过程中的一致性问题?
在数据从低速介质向高速介质迁移的过程中,系统通常采用“先复制、后切换、再删除”的原子操作机制,在数据复制期间,所有的读写请求仍指向原始位置,只有当新位置的数据校验无误后,元数据才会指向新地址,从而确保业务层感知不到迁移过程,并保证数据的一致性。
混合存储的性能抖动是如何产生的?
性能抖动通常源于两个方面:一是大规模数据迁移占用了过多的后端总线带宽;二是大量冷数据突然被访问(即“热点突变”),导致系统需要从高延迟的HDD层实时读取数据,据统计,通过合理的迁移窗口设置和预热机制,可以将此类抖动对业务的影响降至最低。
如何评估分层存储方案的投资回报率(ROI)?
评估ROI时,不应仅对比硬件采购价格,而应计算“单位有效容量的综合拥有成本(TCO)”,计算公式可参考:TCO = (硬件采购成本 + 运维成本 + 电力与空间成本) / 有效存储容量,在同等容量需求下,混合存储方案由于大幅降低了高成本介质的占比,其TCO通常比全闪存方案低30%至60%。
分层混合式存储系统通过智能化的介质管理,为企业在性能需求与成本控制之间提供了一条科学的演进路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/491469.html