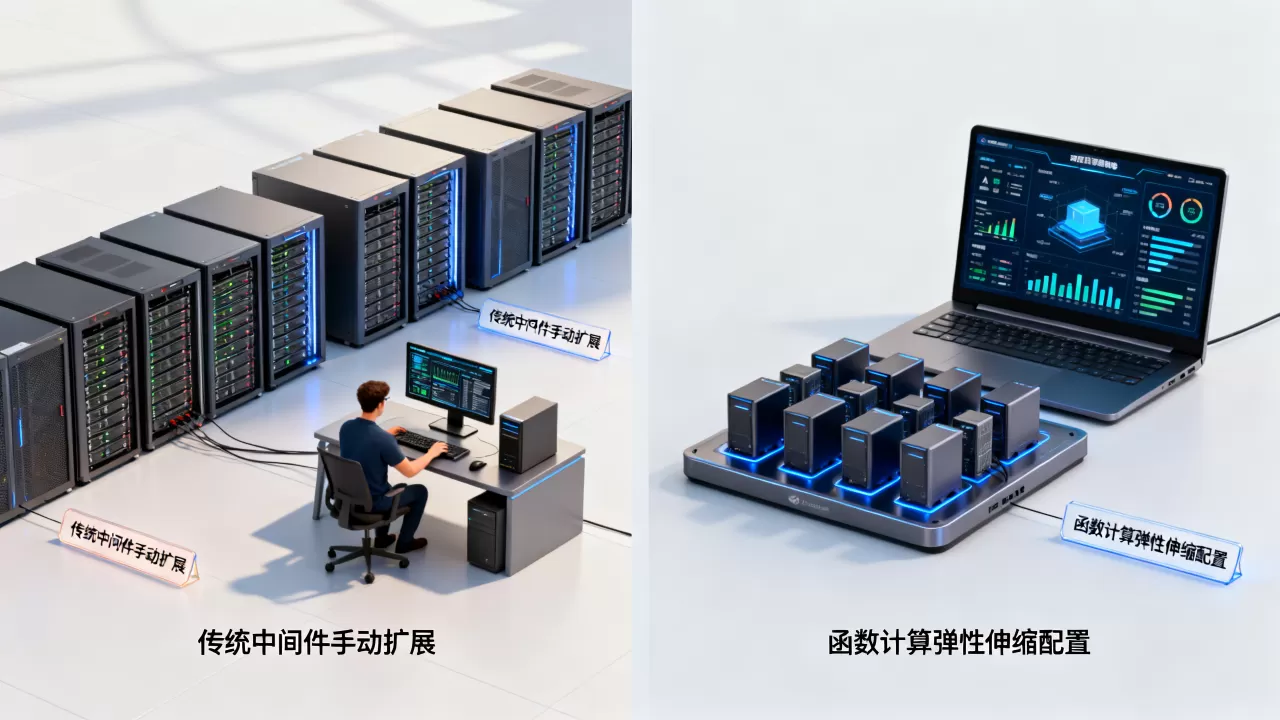
传统中间件靠手动扩展,函数计算靠自动弹性,两者的本质区别在于扩容的触发权掌握在运维手里还是掌握在系统手里。前者是人等流量,后者是流量等人,这也决定了它们在突发流量面前截然不同的命运。
传统中间件手动扩展到底难在哪
很多团队还在用传统中间件扛业务,不是因为它好用,而是因为迁移成本摆在那里,但手动扩展这件事,真实体验远没有想象中那么顺手。

扩容流程中最容易被卡住的三个环节
传统中间件的扩容,表面看只是“加机器”,实际操作却是一套完整链路:
- 资源申请环节:运维需要先确认机器库存、审批流程和预算归属,遇到大促或活动,提前一周就要报备资源,临时要机器基本不可能
- 环境部署环节:新机器到位后,要装JDK、配环境变量、同步配置文件、加入集群,一套流程走下来,熟练的运维也要一两个小时
- 流量接入环节:新节点要接入负载均衡,注册到服务中心,修改配置并重启部分应用,这一步操作不当,就会引发线上抖动
中间件集群的扩展是有“生命周期”的,从你决定扩容到流量真正打到新节点上,这个间隔通常以小时计,而流量高峰往往只持续几十分钟等扩完了,峰值也过去了。
近几年来,一种相当普遍的误判
行业共识认为,手动扩展的问题在于“人”,其实更准确地说,问题出在决策链路太长,流量涨到多少需要扩容?你无法确定,系统负载到哪个阈值必须扩?也不确定。
一个典型的场景:半夜十二点,运营活动上线,QPS从5000涨到15000,监控告警响了,运维爬起来,看一眼监控,判断需要加两台机器,然后走进机房或是打开云控制台,一步步操作,等一切就绪,已经过去四十分钟。
这四十分钟里,应用响应时间从200ms涨到2秒,用户体验已经受损,而更尴尬的是,第二天流量回落了,多出的机器还要手动缩掉,不然就得继续付资源费。
函数计算自动弹性扩容原理是什么
函数计算把扩展这件事从“操作流程”变成了“系统行为”,你不需要告诉它什么时候扩、扩多少,它自己会根据流量情况做实时调整。
从0到100的自动拉起逻辑
函数计算的弹性核心是一个调度器
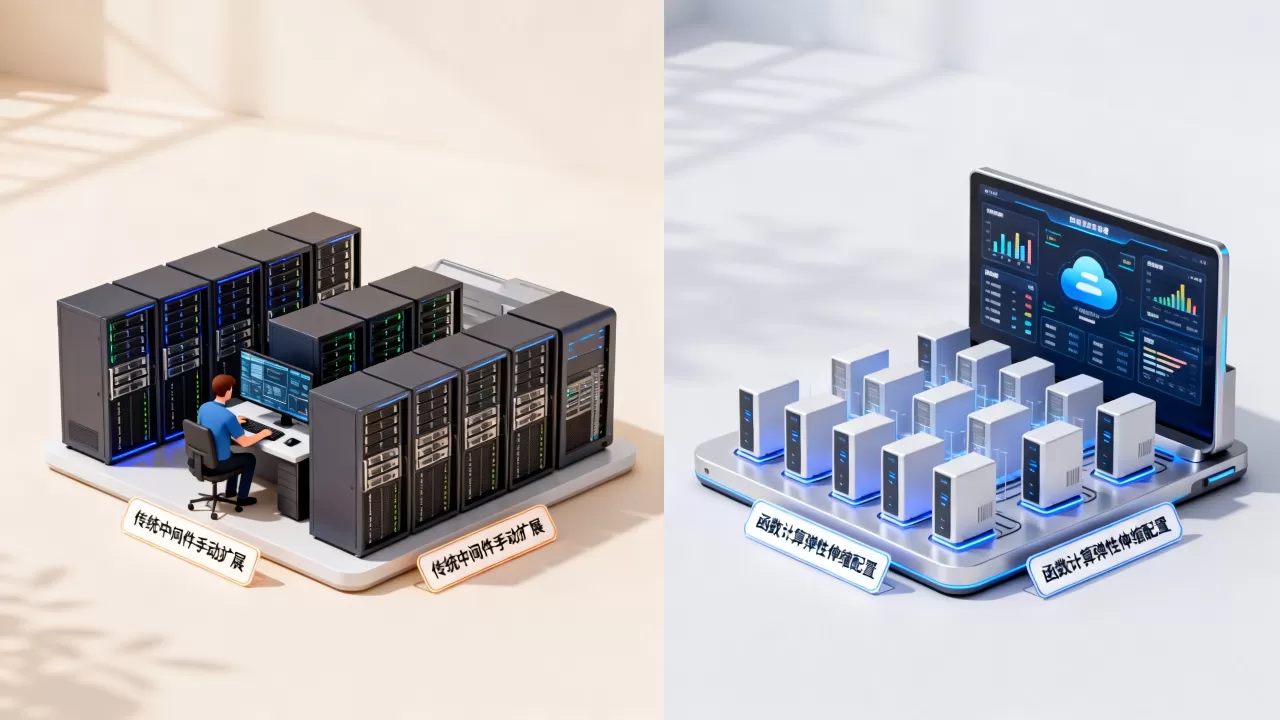
,它持续监控每个函数的并发请求量,当请求到达时,调度器会检查当前实例是否足够:
- 实例充足:直接分发请求到空闲实例,整个过程在毫秒级完成
- 实例不足:自动创建新实例,拉起代码运行时环境,执行初始化函数
- 实例空闲:超过设定时间(各云厂商通常为几分钟)没有请求,自动回收实例
这套机制让扩容响应时间从“小时级”缩短到了“秒级”,据公开技术资料,主流云厂商的函数计算可以在数秒内完成新实例的拉起,并且支持每秒数百甚至上千个实例的并发扩展。
高并发场景下函数计算并发实例数如何调整
并发实例数的调整,在传统中间件里是一项高风险操作,在函数计算里则只是配置项。
以常见的Web API为例,你可以设置单个实例的并发度,比如每个实例同时处理10个请求,当请求量上涨,调度器自动计算出需要的实例数,并快速拉起,这就意味着即使流量从1000跳到100000,函数计算也能在几十秒内完成弹性伸缩,而中间件此时可能还在等审批。
自动弹性带来的另一个隐性优势是缩容同样自动,流量下降,实例数跟着减少,不会出现“流量没了机器还在跑”的资源浪费。
横向对比:传统中间件手动扩展和函数计算自动弹性差在哪
为了更直观地看到差异,可以用一张表来对比关键维度:
| 对比维度 | 传统中间件 | 函数计算 |
|---|---|---|
| 扩展触发方式 | 人工决策,手动执行 | 系统自动检测流量并扩缩容 |
| 响应速度 | 分钟级到小时级 | 秒级 |
| 资源利用率 | 常驻资源池,低峰浪费严重 | 按需加载,空闲即回收 |
| 计量方式 | 按资源包月/包年付费 | 按实际调用次数和资源消耗计费 |
| 运维成本 | 需要专人维护集群 | 无需关心底层节点状态 |
成本核算方式完全不同
传统中间件的账单很好算你买了多少台机器,就付多少钱,和实际业务量没有直接关系,就算半夜一个请求都没有,机器也在计费。
函数计算按实际消耗计费,请求次数加资源使用时长
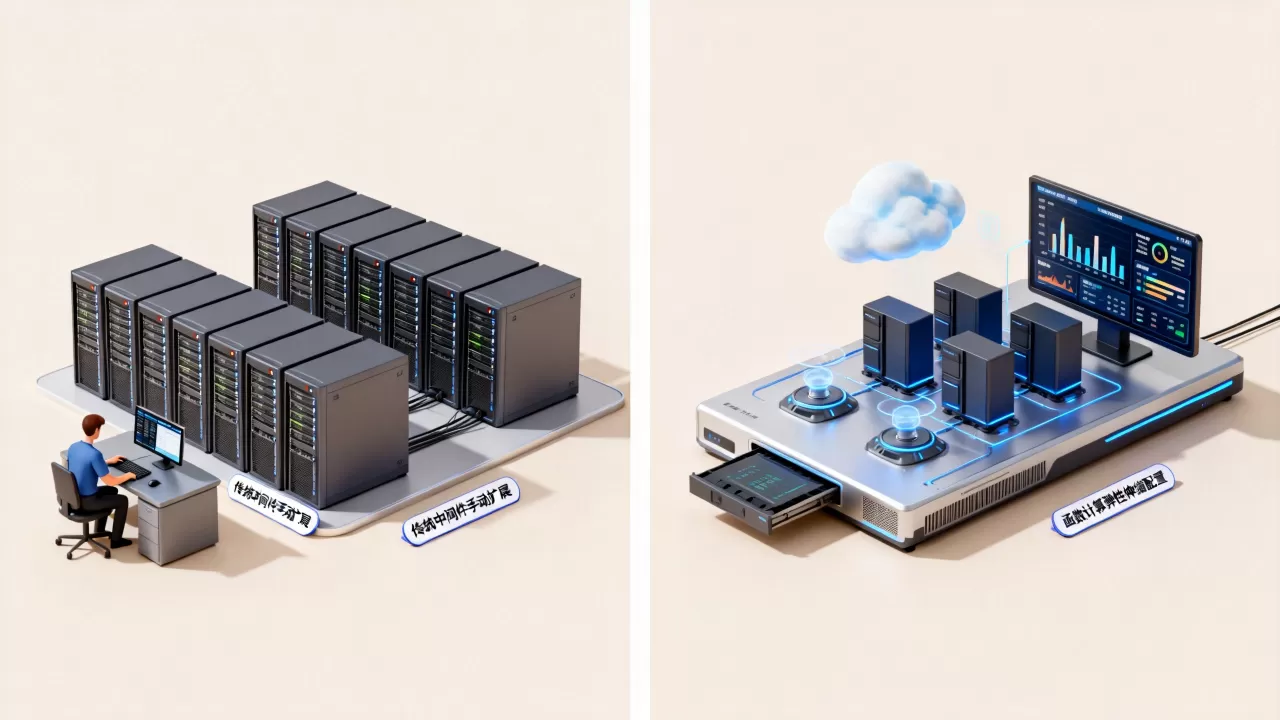
,高并发的时候费用随实例数量上涨,低峰期几乎不产生费用,两种模式的成本曲线差异很大:中间件是一条平稳的直线,函数计算则是一条跟随业务波动的水波纹。
业内专家指出,在业务流量波动明显的场景下,函数计算的实际成本通常低于自建集群,如果业务流量极其稳定且常年满负荷运行,传统中间件的包月模式反而更划算前提是这种“稳定”确实存在。
什么场景更适合选择自动弹性
不是所有业务都适合函数计算,判断标准不在于技术新旧,而在于业务本身的流量特征。
优先考虑函数计算的场景
- 流量有明显的波峰波谷:比如电商促销、证券开盘、直播开播,流量可能在几分钟内暴涨十倍,然后回落到正常水平
- 业务冷热交替明显:比如企业内部的定时任务、报表生成、数据清洗,每天只有固定时间段跑一次,其余时间完全空闲
- 多服务碎片化:业务由大量独立的小接口组成,每个接口的调用频次不高,但总数很大
传统中间件仍有存在必要的场景
- 长连接服务:如WebSocket网关、消息推送,这些服务需要长期维持连接状态,函数计算的按需拉起模型并不适用
- 有状态服务:需要持久化到本地磁盘或内存中的业务数据,函数计算的实例生命周期有限,不适合存放状态
- 追求极低延迟的实时交互:虽然函数计算冷启动已大幅优化,但常驻实例的延迟仍然低于按需拉起
很多团队的做法是混合架构核心交易链路继续跑在容器或虚拟机上,外围的弹性业务、定时任务、数据处理放到函数计算上,这样既不用推倒重来,也能把自动弹性的优势发挥出来。
实操:从传统中间件迁移到函数计算的关键步骤
如果你决定尝试验证自动弹性的效果,可以按下面的路径做一次小规模迁移。
第一步:梳理适合迁移的服务
优先选择无状态、独立部署、对外暴露HTTP接口的服务,典型的如用户注册通知、订单状态回调、文件处理任务,这类服务最容易迁移,也最容易体现效果。
第二步:改造为事件驱动模式
传统中间件通常是请求-响应模式,改造时把业务逻辑拆成两部分:
- 将接收请求的入口改为函数触发器的URL
- 把业务逻辑封装进函数体内
- 配置环境变量和依赖包,确保函数能独立运行
需要注意数据源连接的初始化,不要每次请求都创建数据库连接,而是利用全局变量做复用,降低连接开销。
第三步:配置弹性策略并压测
在函数计算控制台找到弹性伸缩设置,设置最大实例数和单实例并发度,建议先用较低的并发度跑一轮压测,观察实例拉起速度和响应时间的变化,再逐步调整参数。
比如某电商团队在杭州做了个实验,把一个商品详情接口迁移到函数计算上,双十一预热期间流量波动较大,自动弹性扛住了每秒超过两万次的调用,而运维零介入,这个案例说明,函数计算的弹性不是实验室数据,而是真实场景可用的能力。
函数计算自动弹性与传统中间件手动扩展的常见问题
函数计算实例的并发度设置多少合适?
并发度决定了一个实例能同时处理的请求数,并发度设置过高,单个请求排队时间变长;设置过低,实例数膨胀,费用上升,建议从较低值开始,比如单实例并发10,然后根据压测结果逐步上调,遇到耗时短的小接口,并发度可以设高一些;耗时长的计算型任务,要降低并发度。
在类似电商大促的流量高峰场景下,函数计算会不会冷启动失败?
函数计算的调度器会在流量突增时快速预置实例,多数云厂商的实测数据显示,突发扩缩容的实例初始化时间通常在几百毫秒到数秒之间,真正影响启动速度的不是平台,而是你的代码初始化逻辑依赖包加载、数据库连接建立、配置拉取,这三项做得越轻,冷启动就越快,建议把重的初始化逻辑放到懒加载里,而不是放在函数入口处。
传统中间件和函数计算的成本边界在哪里?
以月为维度估算,如果业务每天都有超过8小时处于满负荷运行且流量稳定,传统中间件的包月计费更有优势,如果业务流量集中在某几个时段,其余时间负载很低,函数计算的费用通常只有中间件模式的30%到50%,核心原因在于中间件的痛点不是“贵”,而是“浪费”你常备的资源池,大多数时候都在闲置,函数计算把闲置资源成本降到了零,这正是自动弹性最直接的财务价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/636387.html