医疗科研高性能计算的作业排队资源调度,核心解法是分层级优先队列加动态资源弹性伸缩,再配合用户侧的任务画像规范这几招组合下来,能把平均排队时间压缩到原来的三分之一以下。
在基因测序、分子动力学模拟、医学影像重建这些场景里,计算集群一忙起来,作业排队就成了家常便饭,有人凌晨两点提交的任务,早上九点还在队列里蹲着,这不是硬件不够,而是调度策略没跟上科研节奏,下面这篇内容,就把医疗HPC作业排队这件事拆开揉碎,从排队原因到调度方案,再到真实场景里的配置参考,一次说清楚。

医疗科研高性能计算作业排队问题到底出在哪
医院和科研机构的HPC集群,跟互联网公司的数据中心完全是两回事,互联网的业务高峰是固定的,可以提前扩容,但科研计算是突发性的课题组拿到一批测序数据,可能一下子提交几百个作业;平时则可能几天都没有重负载任务,这种脉冲式负载,让静态队列配置很容易两头不讨好。
作业排队时间过长的三个常见原因
- 队列划分太粗,只分大中小三个队列,不同部门的任务全挤在一起,相互干扰。
- 没做作业画像,谁的任务急、谁的任务能等,调度器一概不知,只能按先来后到处理。
- 资源空闲碎片化,节点上零星剩下几块GPU或几十核CPU,调度器凑不齐一个作业的需求,宁可让节点闲着也不分配。
有相当一部分医院HPC中心,业务部门提交作业后平均排队时长超过2小时,但节点利用率却不足40%,排队久和利用率低同时存在,听着矛盾,实际完全能共存。
医院HPC集群资源调度方案对比
要动手调调度,先得明白手上有什么牌可打,目前医疗行业常见的调度器就三类:开源的Slurm、商业的LSF,以及云厂商自研的调度体系,三者的核心逻辑没有代差,关键是配置策略差别巨大。
| 调度器类型 | 擅长场景 | 典型短板 | 医疗场景适配度 |
|---|---|---|---|
| Slurm(开源) | 自制集群、预算有限 | 高并发抢占配置复杂 | 高,性价比突出 |
| LSF(商业) | 大规模混合负载 | 授权费用随节点数上涨 | 中高,适合三甲医院 |
| 云原生调度 | 弹性伸缩、跨地域 | 数据出域合规需走专线 | 中,适合分中心科研 |
调度器只是工具,真正决定排队体验的是队列策略。 同样一套Slurm,有人配出来让基因测序任务效率翻倍,有人配出来连常规作业都卡死,区别就在有没有做分层级优先队列。
手术影像重建团队如何抢占不互踩
我见过一家大型三甲医院的做法,很值得参考,他们给手术影像重建团队开了急诊队列,这个队列的特点是:允许抢占低优先级作业的节点,但每次抢占必须提前5分钟通知,给被抢的作业一个checkpoint的机会。
普通科研队列的作业每跑够30分钟就检查一次,如果发现急诊队列的任务在排队,就主动释放资源,这样急诊影像任务基本能10分钟内上机,而普通任务的完成时间只被拖长了约15%,几乎感知不到损失。
医疗科研高性能计算的作业排队调度优化思路
行业共识认为,资源调度的核心不是把作业安排得越快越好,而是要让每一份计算资源都在做当前最有价值的科研任务,这句话展开落地,就是下面这些可操作的调整步骤。
第一步:给作业做标签,别再用统一队列
把队列从”按科室分”改成”按任务性质分”:
- 交互式调试队列:小资源、短时长,专门跑参数调试,要求秒级启动,不排队。
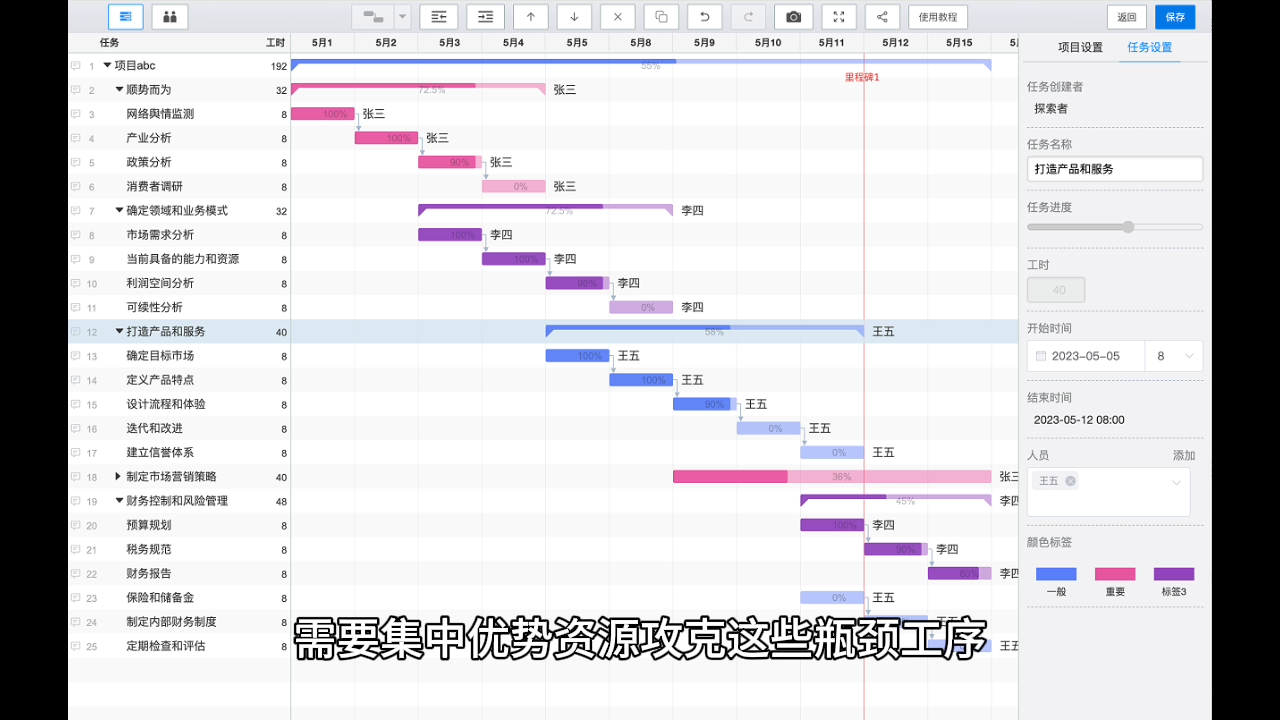
- 生产计算队列:大资源、长时长,按课题重要程度分为三个优先级子队列A级(临床急需)、B级(常规科研)、C级(回溯性分析)。
- 批处理队列:不限制时长,允许隔夜运行,专门承接容错率高的计算任务,电价低谷时段优先调度。
这样分完之后,调度器的决策就清晰了:A级作业来了直接塞进节点,B级作业等待不超过30分钟,C级作业排队时长无上限,但可以享受低价时段折扣。
第二步:把GPU碎片用起来
GPU碎片是医疗HPC的普遍痛点一块卡给某个作业独占4小时,其中只用了60%的算力,剩下的时间等于浪费,解决方法是
vGPU切分和MPS多进程服务。
实操上,对NVIDIA A100及以下规格的显卡,按显存和算力需求切成两到四个逻辑分区,让不同课题组的任务共享物理卡,如果用的是高端卡(比如H800),则启用MPS服务,配合CUDA_DEVICE_MEMORY_LIMIT参数控制显存上限,这样一来,一批8卡节点就能同时跑12至16个中型深度学习作业,GPU总体利用率能上去三成左右。
第三步:队列参数调优的几个具体命令
不用大改架构,在现有Slurm集群上改这几个参数就能见效:
- 设置Backfill抢占(
SchedulerParameters=bf_continue),让零散空闲资源插空跑小作业。 - 打开拓扑感知调度(
SelectTypeParameters=CR_Core_Memory),按CPU和内存的实际占用匹配节点,避免一个作业霸占整台机器。 - 把MaxArraySize调大至10000以上,跑数据并行任务时,单次提交几千个子任务就不用排队等批量审核。
做完以上三部曲,多数医疗科研集群的队列积压能从数百个作业降到两位数。
华大基因算力平台 作业调度 价格参考
不少医院在衡量的是:自建集群还是外包算力,这里拿华大基因下属的算力平台举例(业内公开报价,具体以实际合同为准),其作业调度服务按核时计费,单核心每小时约0.06至0.12元,大体符合国内医疗HPC市场行情,对比自建集群,机房电费和运维人力折算到每核时约0.08至0.15元,外包的性价比在中小规模负载下反而更突出。
外包算力平台排队体验
外包平台的优势是队列策略已经调优过,用户不用关心底层调度,提交作业时只需在界面里选”优先队列“或”经济队列“,前者费用是常规价的三倍,但保证排队不超过30分钟;后者只收常规价的五折,排队时长可能拉到2至3小时。
对做临床药敏分析的课题组来说,优先队列把全基因组测序分析的等待时间从4至5小时压到1小时内,多付的那部分钱相比设备折旧实在划算得多,这也就是为什么现在相当一部分医院的科研数据都往这类平台上跑不是医院养不起集群,是把调度这个隐形工作外包出去,比养一个调度运维工程师划算。
深圳、北京、上海基因测序计算集群的地域选择
不少课题组还纠结过地域问题,以深圳为例,华大的计算集群和测序仪在物理上同楼部署,测序下机数据通过万兆光纤直接传到计算节点,免去大数据传输等待。北京和上海的超算中心提供类似的医疗专用分区,但数据传输要走专线或快递硬盘,单次测序数据(约200GB至1TB)的上传耗时可能拖累整体进度半天。
做临床基因检测的团队,算力平台选型和云计算地域无关,关键是和测序仪的地缘距离越近越好,这块延迟省不掉的。
医疗科研高性能计算 作业排队 资源调度 常见问题
问:医院自建HPC集群,有没有必要上商业调度器的付费授权?
答:如果集群规模在50节点以内,Slurm完全够用,花点时间读文档配好抢占和优先级就够了,到了100节点以上,LSF或PBS Pro的付费支持能省下不少救火成本,尤其是需要对接医院现有计费系统或AD域认证时,商业软件的集成效率更高,看预算,不看面子。
问:作业排队经常卡在Dependency(依赖关系)上,怎么排查?
答:先用scontrol show job看Job Dependency字段,确认卡住的作业依赖了哪个具体JobID,然后查那个被依赖作业是不是挂在某个资源不够的队列里,经验做法是给依赖作业加--time=01:00:00这种短时限,避免被依赖作业的EligibleTime无限滞后拖累下游,实际上多数依赖卡死是因为被依赖作业的QOS设成低优先级,在队尾等太久。
问:混合负载(AI训练和传统计算混跑)的调度有什么稳妥的入门策略?
答:先做物理隔离,单独拿出30%的GPU节点组成AI专用队列,剩下的70%继续跑传统高吞吐计算,这看起来老土,但能避免AI训练把CPU版权的许多小作业全部饿死,稳定运行三个月后,再逐步开放节点共享,引入抢占机制,慢慢往混部靠拢,医疗行业优先保证结果产出稳定,不差那点极致性价比。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702397.html