针对合同全文检索场景,服务器资源分配的核心原则是:内存优先于CPU,磁盘IOPS决定性能上限,搜索引擎集群架构优于单机堆配置。这意味着与其花重金买高主频CPU,不如把预算倾斜到大容量内存和高性能SSD上,同时做好分片规划。
先搞懂合同全文检索为什么会卡
合同检索和普通网页搜索完全是两码事,网页搜索对实时性容忍度高,但合同检索面对的是PDF、Word、扫描件混合的庞大数据集,而且用户往往用“合同编号+公司名称+金额区间”这种组合条件去过滤。
业内专家指出,多数企业合同系统的性能瓶颈不在数据库,而在全文检索引擎的索引构建速度和查询时的内存命中率,一个典型的场景是:法务人员输入关键词后,系统需要同时扫描倒排索引、过滤权限范围、高亮命中片段,这三个动作里任何一个环节资源不足,用户感知就是“转圈圈”。
相当一部分企业犯过的错误是:把合同检索服务和ERP、OA装在同一个应用服务器上,结果大促期间ERP的报表任务直接把检索服务的CPU抢光。合同检索必须独立部署,这是资源分配的第一条铁律。
核心资源分配逻辑:四层模型
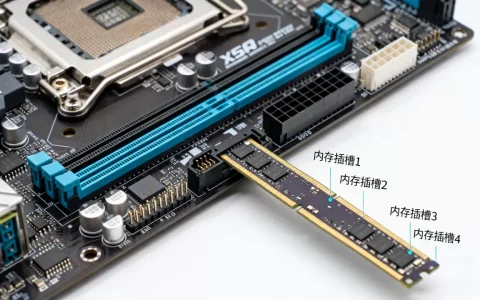
内存分配:撑起缓存命中的生命线
全文检索的黄金法则是热数据全内存,假设你有50万份合同,平均每份200KB(含OCR文本层),那么原文数据约100GB,倒排索引约为原文的30%-50%,也就是30-50GB。
| 数据类型 | 容量估算 | 建议内存分配 |
|---|---|---|
| 索引文件 | 原文量的30%-50% | 至少分配索引大小的1.5倍 |
| JVM堆内存 | 索引的50% | 不超过物理内存的50% |
| 操作系统页缓存 | 剩余全部 | 越多越好,喂给读取缓存 |
这里的实操要点是:给搜索引擎的JVM堆内存别超过32GB,因为超过32GB后JVM会关闭压缩指针,反而浪费内存,多余的内存全部留给操作系统页缓存,查询时直接从页缓存命中,速度比堆内缓存快一个数量级。
CPU选型:核数比主频重要
合同检索的查询是典型的并行分发-归并模式,一个查询会被拆成多个分片并行执行,如果CPU核数不够,分片任务只能排队,行业共识认为,每8GB索引对应1个物理核是安全起点,主频2.5GHz以上即可,不需要追求顶级主频。
实际部署中常见误区是采购双路高频CPU,但分片数只有一个,结果一半以上的核在空转,规范化做法是:先按合同总量预估分片数,再反推CPU核数,例如规划8个分片,至少给16核,留出归并排序的余量。
磁盘选型:IOPS决定索引重建效率
合同系统每年年初常有大批量合同归档导入,这时需要重建增量索引。机械硬盘的随机IOPS通常在100-200,而NVMe SSD轻松上万,如果用机械盘跑全量重建,50万份合同可能要跑十几个小时,期间检索服务几乎不可用。
建议方案是:
- 索引目录和一式多份的副本存放在独立NVMe SSD上,不与应用日志共享
- 每份合同至少保留1个副本在不同物理机上,避免磁盘故障导致全量重建
- 存储容量按索引大小的2.5倍预留(含merge临时空间和备份快照)
网络带宽:容易被忽视的延迟瓶颈
当检索集群超过3台节点,节点间的分片数据同步和聚合查询的中间结果传输会占用大量内网带宽,万兆内网是基础要求,否则一个复杂查询触达几十个分片时,网络往返延迟可能超过查询本身的计算时间。
不同规模场景的参考配置方案
小微规模:合同量在10万份以内
这种体量下,一台物理机或高配云主机就能扛住,配置参考:8核16GB内存起步,系统盘和数据盘分开,使用单节点模式,但务必关闭自动副本分配,因为单节点上副本没有任何意义,预计可以支撑每秒10-20次并发查询,足够50人以内的法律团队使用。
中等规模:合同量在10万到100万份之间
这是最常见的场景,推荐3节点集群,每节点配置16核32GB内存,数据盘使用1TB NVMe SSD,索引分片设置为节点数的2倍(6个分片),每个分片控制在20GB以内,此配置可承载约200个活跃用户,日均查询量5万次左右。
关键词“合同全文检索服务器配置”往往就是这类客户搜出来的,实际采购时记住一个原则:宁可多买内存,不要多买CPU核数。
大规模:合同量超过100万份
这个量级建议采用热温冷分层存储架构,热数据(近一年合同)放在SSD上,温数据(1-3年)放在SATA SSD或高性能机械盘,冷数据(3年以上)放到对象存储,通过索引快照方式延迟加载。
此时集群节点数建议5-7个,并引入协调节点、数据节点、主节点分离的角色划分,主节点不存数据,只管集群状态;数据节点专注索引和查询;协调节点负责合并结果,内存分配上,协调节点可以少给内存,数据节点给足。
资源分配的弹性伸缩策略
按合同周期性调整资源
合同系统的检索压力有明显的季节性特征:月初和年底是查询高峰(财务报表、审计需求集中),年中相对平缓,如果你的服务器在云上,可以设置定时伸缩策略,高峰期前30分钟扩容2个数据节点,结束后缩容,行业共识认为这样可以节约30%左右的计算成本。
索引预热与内存命中优化
系统启动后,第一次查询总会比较慢,因为索引还没加载到页缓存,实操做法是:配置定时任务在每天早8点前执行一次遍历查询(比如搜索一个绝对不存在的字符串),强制加载所有索引块到页缓存。这是零成本但效果立竿见影的调优手段。
容量水位监控
给服务器配置三个监控阈值:
- 堆内存使用率超过75%持续10分钟,触发GC日志分析和堆转储
- 磁盘IO等待时间超过200ms,说明IOPS已经饱和,需要扩容或迁移分片
- 查询延迟P99超过3秒,立即检查是否存在大分片或缓存命中率骤降
部署架构中容易踩的五个资源坑
- 坑一:JDK版本不匹配,全文检索引擎对JDK版本敏感,该用17却装了11,GC行为完全不同,内存再大也会频繁Full GC。
- 坑二:交换分区没关,Linux的swap会让JVM内存被换到磁盘,检索延迟瞬间飙升,部署时务必执行
swapoff -a并注释fstab条目。 - 坑三:分片数一锤定音,分片数在索引创建后不能修改,只能重建索引,规划时按未来3年合同增长量的1.5倍来设计分片数。
- 坑四:忽略merge线程的资源占用,大量小段合并时CPU会飙高,务必在非高峰时段执行
_forcemerge,将段数合并到个位数。 - 坑五:备份任务挤占IO,全量快照备份和索引重建同时执行,磁盘IO直接被打满,把备份窗口定在凌晨2点到4点,同业务低峰错开。
实测调参清单(可直接照抄)
安装部署完成后,按这个清单逐项设置:
indices.memory.index_buffer_size设为堆内存的15%indices.queries.cache.size设为堆内存的8%thread_pool.search.queue_size保持默认,不要盲目调大discovery.zen.fd.ping_timeout内网环境设为3秒即可- 关闭查询日志中的
explain输出,避免IO浪费 - 开启慢查询日志,阈值设为2秒,持续观察一周
执行一次基准压测,用公司真实合同数据的脱敏版跑混合查询(50%精确匹配+30%模糊检索+20%聚合统计),记录P99延迟和吞吐量,如果P99超过500ms,优先检查内存命中率命中率低于90%说明内存分配不足,加内存比加CPU更有效。
合同检索系统性能监控
很多运维人员部署完就不管了,但检索性能是渐进劣化的,建议每周检查三个指标:索引段数量(超过50个需要merge)、查询缓存命中率(跌到60%以下要找规律)、慢查询比例(超过5%需要优化查询语句或增加协调节点)。
合同全文检索的资源分配本质是拿内存换延迟、拿SSD换吞吐,先按合同总量和增长预估分片数和节点数,再Micro调整堆内存与页缓存比例,最后通过监控验证调整效果。
常见问题解答
合同全文检索很慢,直接加CPU有用吗?
多数情况下没有直接帮助,查询慢的核心原因是内存不足导致索引数据频繁从磁盘加载,或者分片过大导致单分片扫描时间不可控,先查看观测指标中的堆内存使用率和页缓存命中率,如果堆内存持续处于90%以上、页缓存命中率低于80%,优先增加内存而不是CPU,单一索引分片数据量超过40GB时,应重建索引拆分分片。
合同检索服务器能和文件服务器共用一台机器吗?
物理机上可行但强烈不推荐,容器环境下必须分拆部署,全文检索对内存分配的稳定性和磁盘IO的独占性要求很高,文件服务器的大文件读写会严重干扰页缓存结构,曾有案例显示两者共存时检索延迟增加近3倍,至少要做到数据目录、日志目录的IO完全隔离,用cgroup限制文件服务的IO权重,这样才能保证检索性能的基本原则。
云服务器和物理机怎么选?
合同数据敏感度较高,有合规要求首选物理机或私有云裸金属,如果选公有云,要注意云主机的突发性能模式会造成检索延迟抖动,务必选择无CPU积分限制的实例类型,存储方面,云盘性能是可突发性较强的持久化云盘,IOPS会有数值上限的限制,采购前需要在合同中关注单盘IOPS的性能承诺,用高IOPS云盘配合多副本分片,操作系统选型上,云服务器和物理机公认的选择都是Linux发行版,原因在于其内存管理机制和IO调度算法对检索负载更友好,Windows Server在处理高并发检索时的线程调度表现普遍存在差距。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/777032.html