租用GPU跑大模型微调,核心要盯紧显存容量、计算精度、互联带宽和成本结构,显存大小直接决定你能否跑起目标模型,而精度和带宽则影响训练效率和最终效果。
西安GPU租用:显存容量是首要门槛
显存就像你的工作台,台面不够大,工具都摆不开,微调大模型时,模型参数、梯度、优化器状态以及中间激活都塞在显存里。显存不足直接导致OOM(内存溢出),训练中断,业内共识是,对于7B级别模型,全参微调至少需要32GB以上显存,而使用LoRA等参数高效微调方法,16GB显存也能跑起来。
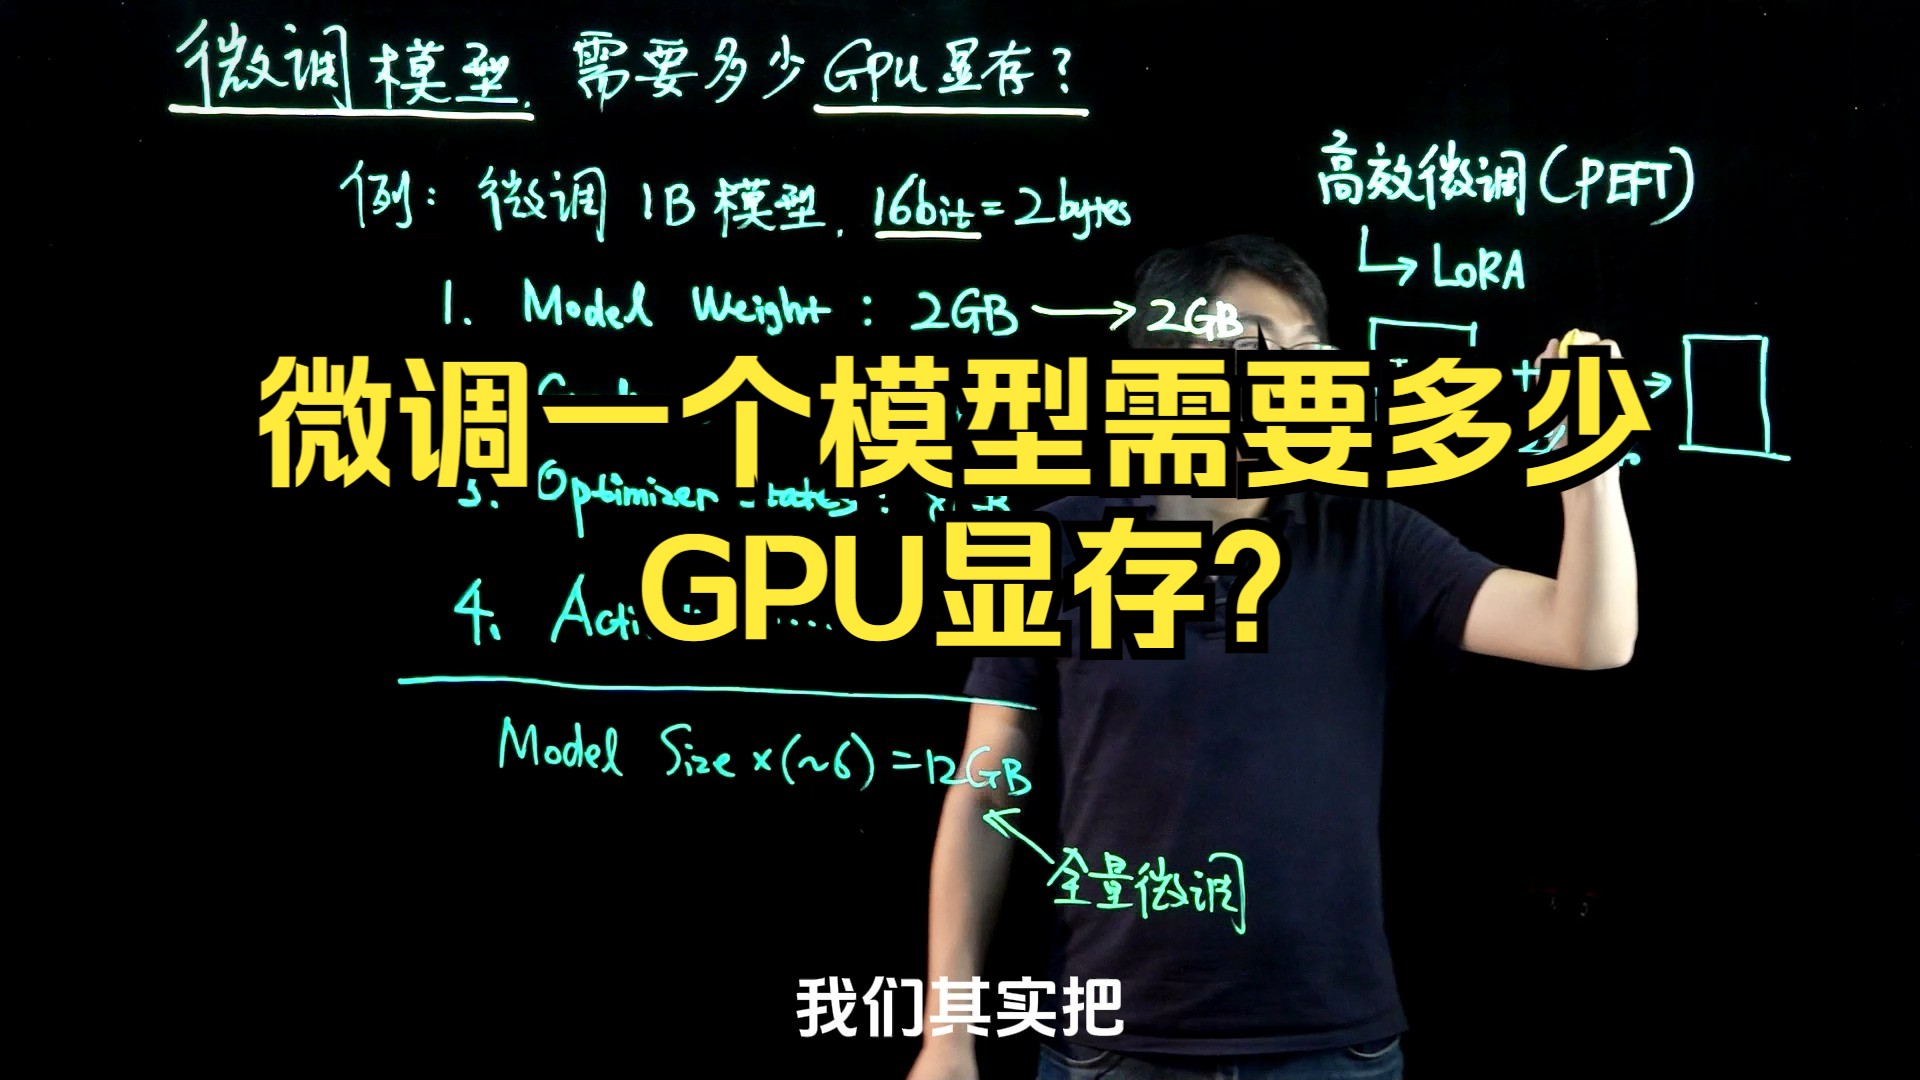

微调场景下显存的实际消耗
显存占用不是固定的,它受几个因素影响:
- 模型参数量:参数量越大,吃显存越狠。
- 批次大小:批次越大,中间激活占用的显存越多。
- 精度选择:FP16比FP32省一半显存。
- 优化器类型:AdamW比SGD多占约2倍显存(因为需要存储动量和方差)。
如果你在西安本地机房租用GPU,比如RTX 3090(24GB)或RTX 4090(24GB),用LoRA微调7B模型是可行的,但若想跑13B或更大模型,建议直接上A100 80GB或H100,否则只能靠梯度累积和更小的批次来硬撑。
如何估算你的模型需要多大显存?
有一个粗略估算公式:模型显存占用 ≈ 参数量 × 字节数 × 2(参数+梯度) + 优化器状态 + 激活,实际上更复杂,但你可以用一个小工具快速验证:
# 用transformers加载模型,观察显存占用
python -c "from transformers import AutoModel; model = AutoModel.from_pretrained('meta-llama/Llama-2-7b-hf'); print(model.hf_device_map)"
或者直接跑一次前向传播,看nvidia-smi里的显存使用。实操建议:租用前先花几分钟跑一个测试批次,确认显存余量足够,很多西安本地服务商提供按小时计费,测试成本很低。
计算精度:FP16和BF16怎么选?
精度决定了每一步训练能跑多快,以及显存占用有多大。FP16是主流,但BF16对训练更友好,因为它保留了更大的动态范围,不容易出现梯度溢出,不过BF16只有A100/H100及更新的架构才原生支持,V100和RTX 30系列只能模拟,效率打折。
混合精度训练对租用GPU的影响
如果你租用A100,直接用AMP(自动混合精度),框架会自动在FP16和BF16之间切换,几乎不影响显存,还能提速,对于RTX 4090,它支持FP16但不支持原生BF16,所以用FP16就行。行业共识认为,混合精度训练是微调的标准配置,能降低约40%的显存占用,同时保持模型精度。
INT4量化:显存不够时的折中方案
当显存实在吃紧,可以考虑INT4量化微调,比如用QLoRA,把模型权重压缩到4位,显存需求直接减半,但代价是训练速度变慢,且精度可能略有损失。如果你在西安租用低显存卡(如RTX 3060 12GB),INT4量化几乎是唯一的选择,不过要注意,量化后模型推理时也需要相应硬件的支持。
互联带宽:多卡训练不可忽视的瓶颈
单卡显存不够时,你自然会想到多卡并行,但多卡之间的通信带宽如果不够,训练速度可能还不如单卡加小批次,尤其对于大模型,梯度同步和数据传输量巨大,带宽直接决定扩展效率。
西安本地GPU集群的互联配置
西安本地的一些机房提供多卡服务器,但互联方式差异很大。高端的如A100 HGX配备NVLink,带宽高达600GB/s,多卡线性扩展效果很好,而普通PCIE连接(比如多张RTX 4090通过PCIE 4.0 x16互联),带宽只有约32GB/s,多卡训练效率会明显下降。建议优先选择NVLink互联的机器,尤其是你需要训练模型超过10B参数时。
如果不确定,可以直接问服务商:“你们的机器是多卡NVLink互联还是PCIE?” 这个问题能帮你筛选掉不少低效配置。
西安GPU租用价格:如何平衡性能与成本?
说到价格,西安本地租用GPU通常比一线云厂商便宜20%-30%,但需要自己承担运维和网络稳定性的风险,价格模式主要有按小时、包天和包月三种。
单卡 vs 多卡:性价比的临界点
以2026年的市场行情做个模糊对比(单位:元/小时):
| GPU型号 | 显存 | 单卡价格范围 | 适合场景 |
|---|---|---|---|
| RTX 3090 | 24GB | 5-10 | 7B模型LoRA微调 |
| RTX 4090 | 24GB | 10-18 | 7B-13B模型LoRA/全参微调 |
| A100 80GB | 80GB | 25-40 | 13B-70B模型全参微调 |
| H100 80GB | 80GB | 40-70 | 70B+模型全参微调 |
如果你的模型在单卡24GB显存内能跑起来,租单张RTX 4090往往比租多张RTX 3090更划算,因为省去了通信开销,当模型需要多卡并行时,优先选NVLink互联的A100/H100,虽然单价高,但总训练时间短,综合成本可能更低。
按需租用 vs 包月租用
对于短周期微调(几天内),按小时租用最灵活。但如果你计划长期跑实验或迭代,包月通常能打5-7折,西安本地一些服务商还提供“闲时套餐”,比如午夜到早上的价格更低,适合可暂停的微调任务。
实操步骤:租用前如何验证参数是否达标?
纸上谈兵不如动手测试。租到机器后,先跑几个命令确认硬件和网络状态,避免训练中途发现参数不达标。
用命令行快速检查硬件
# 查看GPU型号、显存、温度
nvidia-smi
# 测试显存带宽(单位:GB/s)
# 使用cuda带宽测试工具
bandwidthTest
# 测试多卡间通信延迟(如果有多卡)
# 使用nccl的all_reduce测试
如果显存带宽低于理论值(比如RTX 4090是1008GB/s,实际测出来只有800多,可能被降频或共享带宽),直接联系服务商更换机器。
微调前必做的环境检查清单
- 确认CUDA版本和PyTorch版本匹配(推荐CUDA 11.8+,PyTorch 2.0+)。
- 加载一个测试模型,用
torch.cuda.max_memory_allocated()查看峰值显存。 - 跑一次小规模训练迭代,观察
nvidia-smi的功耗和温度。如果温度超过85°C,说明散热有问题,很容易降频。 - 对于多卡场景,用
nccl-tests跑一次all-reduce,确认带宽符合预期(比如NVLink应在400GB/s以上)。
西安GPU租用跑大模型微调常见问题
西安租用GPU跑微调,显存起步该选多大?
7B模型用LoRA微调,16GB显存是底线,24GB更稳妥,如果做全参微调,32GB起步,13B模型建议至少48GB(A100 80GB理想),70B模型只能用80GB显存以上的卡,并且需要多卡并行。
租用RTX 4090和A100,哪个更划算?
取决于你的时间成本,RTX 4090单价低,但显存和带宽有限,适合小模型或快速验证,A100虽然贵,但能跑大模型且训练速度快,算下来总费用可能更低,如果你每周都要跑几次微调,A100的稳定性也更好。
西安本地租GPU比线上云平台延迟更低吗?
理论上本地机房延迟更低,但实际差距不大,线上云平台如简米云、酷番云在西安也有节点,延迟通常在10ms以内,本地机房的最大优势是数据不需要出市,适合对数据合规性要求高的场景,选择时重点看服务商的网络质量和机器运维响应速度,而非单纯网速。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/558562.html