KV缓存是Transformer模型推理时存储在显存中的历史键值对,它是显存压力的主要来源。 在长文本、多轮对话或高并发场景下,KV缓存甚至比模型权重更占显存,直接影响推理成本和部署方案。
如果把大模型比作一位正在写长文的作者,KV缓存就是摆在手边的便签纸,作者每写一个新词,都要翻看之前记下的关键词和要点,同时再添一张新便签,文本越长、读者越多,便签纸堆得越高,书桌(显存)就越挤,这正是KV缓存让显存告急的真实写照。

KV缓存到底是什么?KV cache原理一句话讲明白
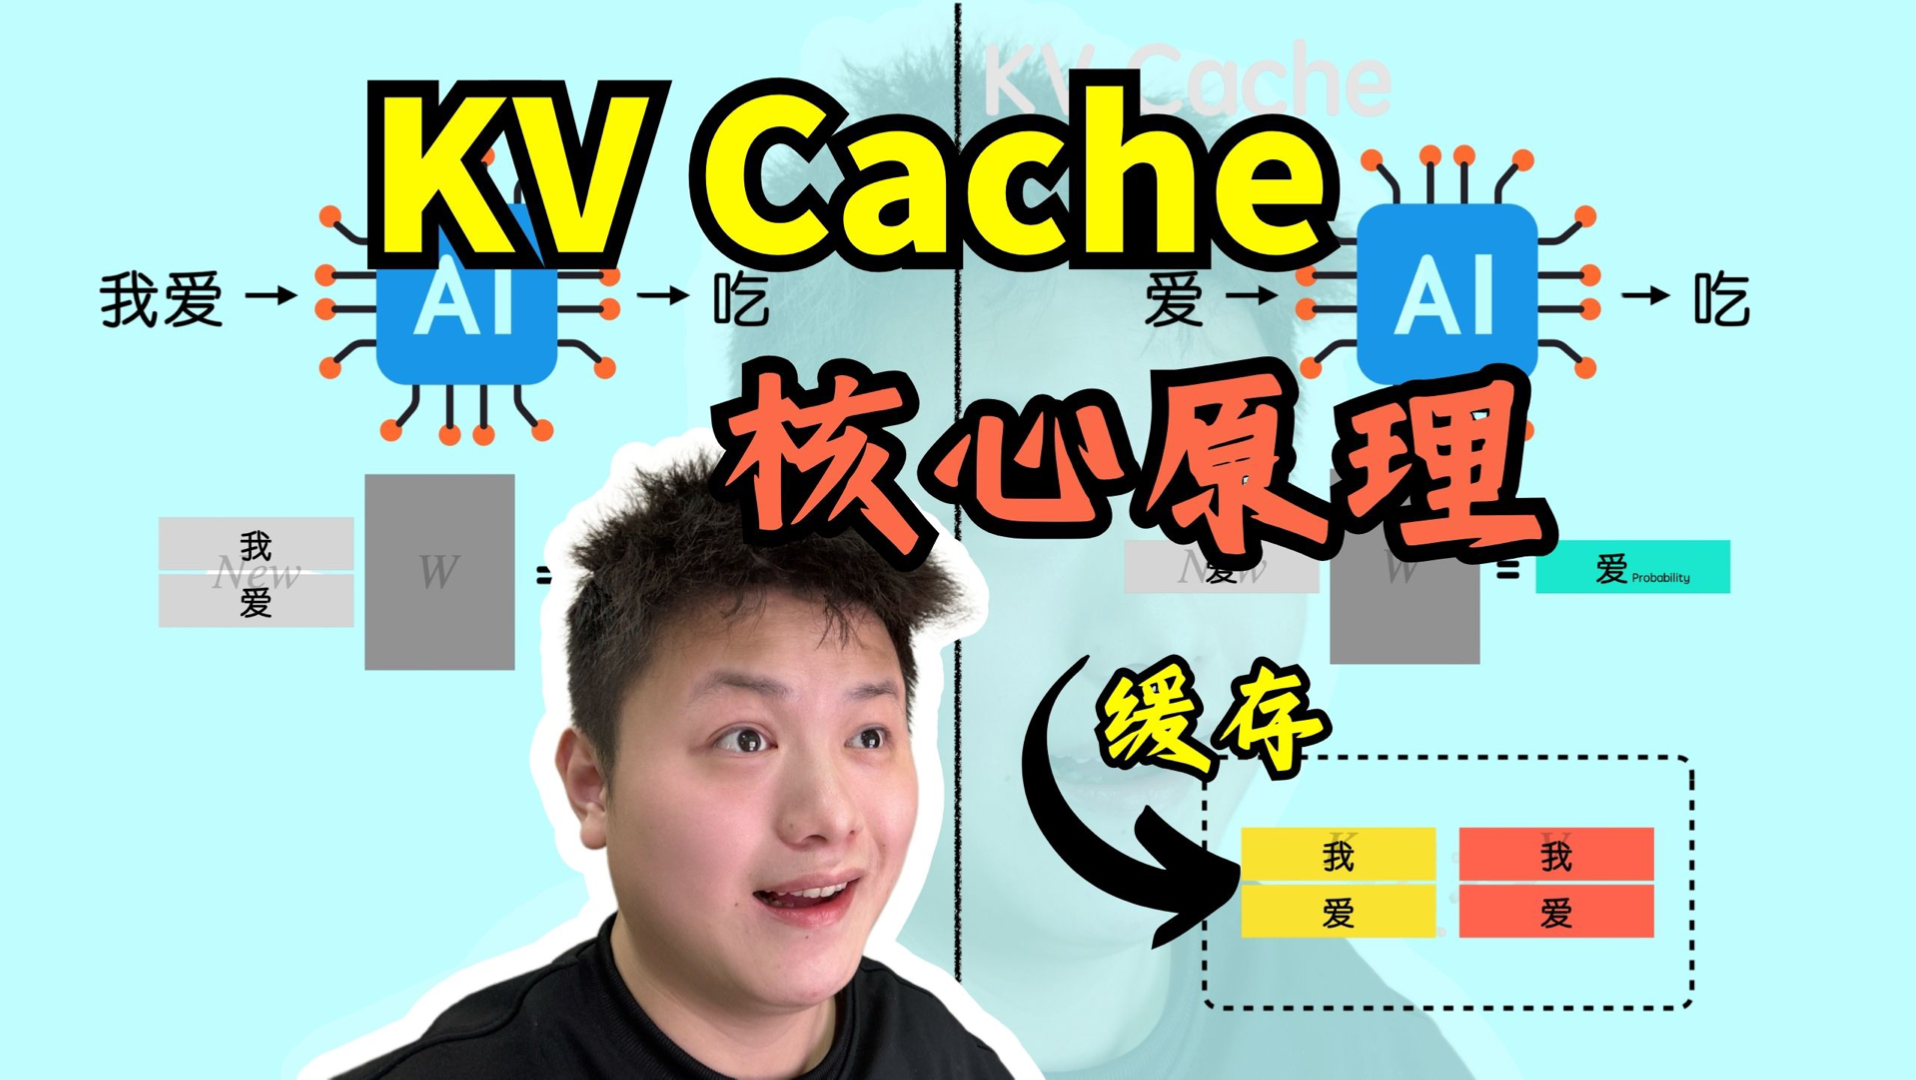
Transformer推理分为预填充和解码两个阶段,预填充阶段一次性处理输入中的所有token,并生成对应的Key和Value,到了解码阶段,每生成一个新token,注意力机制需要让它和之前所有token重新计算关系。
为了避免每次都重新计算历史token的K和V,推理引擎把这些中间结果缓存下来,这份缓存就是KV cache,它的存在让生成速度大幅提升,代价是它必须常驻显存。
从一次对话看KV缓存的诞生
在服务端处理多轮对话时,用户的每一条新消息都会被拼接在历史消息后面,模型需要对整个拼接后的序列做预填充,然后将新token的K和V不断追加到已有缓存中。
- 第一轮用户说“介绍一下量子计算”,模型生成回答,缓存里保存了本轮所有token的KV。
- 第二轮用户继续问“它和经典计算机有什么不同”,模型需要把第一轮和第二轮的内容串在一起,此时K和V不再是简单的“追加”,而是要对整个序列重新计算注意力权重,同时旧缓存继续保留。
这意味着对话轮次越多,KV缓存里堆积的“便签”就越多,显存占用随之水涨船高。
一张公式看懂KV缓存显存占用怎么计算
KV缓存显存占用怎么计算?业内习惯用一个简化公式估算:
每token占用字节数 = 2(K和V两份) × 层数 × KV头数 × 头维度 × 精度字节数
总缓存大小 = 每token字节数 × 序列长度 × 并发请求数。
以常见的7B规模模型为例,假设32层、32个注意力头、头维度128,用FP16存储:
- 每token占用 = 2 × 32 × 32 × 128 × 2字节 ≈ 524KB
- 当序列长度2048时,单条请求缓存约1GB
- 如果同时服务8个用户,仅KV缓存就需要约8GB显存
如果模型采用GQA(分组查询注意力)或MQA(多查询注意力),KV头数会大幅减少,每token占用会降为原来的四分之一甚至八分之一,这也是新模型普遍用GQA替换MHA的原因之一。
哪些场景会把KV缓存撑爆?显存压力的四个主要来源
KV缓存不是均匀增长的,它在特定场景下会急剧膨胀,行业共识认为,长上下文和高并发是导致KV缓存显存压力上升最直接的两个变量。
长文本摘要与文档分析:序列长度线性放大缓存
书籍翻译、代码仓库分析等场景中,输入序列动辄上万token,KV缓存大小与序列长度严格成正比,序列长度从2048涨到16384,缓存占用直接变成原来的8倍。
更棘手的是,这类场景往往需要处理几十页文档,模型需要在每个生成步骤都访问全部历史KV,即便采用滑动窗口或稀疏注意力,窗口之外的早期信息也需要以压缩形式保留,否则会丢失关键内容。
多用户并发:每多一个用户就多一份完整缓存
线上推理服务通常要同时接待多个用户,每个用户都拥有自己独立的完整KV缓存,模型无法在用户之间共享,并发数从1变成32,意味着32份完整序列长度的缓存同时存在。
在实际部署中,单纯靠增加用户数就能把显存压垮,例如一个A100 80G的推理节点,如果模型权重已经占用40G,剩下40G即使只给KV缓存,在7B模型、2048上下文、FP16精度下也只够容纳约40条并发请求,一旦超出,就会请求排队或触发显存溢出。
模型规模与层数:更大的模型意味着更大的“基础底子”
KV缓存的体量与模型层数和隐藏维度强相关,70B规模模型比7B模型的层数更多、维度更宽,即使序列长度相同,每token的KV缓存也可能是小模型的近10倍。
当模型需要配合FlashAttention等优化时,虽然注意力计算效率变高,但KV缓存依然是硬性占用,它不像计算密集型算子那样可以通过算子融合消除,只能被压缩或剪枝。
低精度与多卡并行:精度选择直接影响缓存体积
存储精度对KV缓存影响巨大,FP32存储的KV缓存是FP16的两倍,是INT8的四倍,很多推理框架会默认用BF16/FP16存储KV,但如果模型权重能接受INT8量化,KV缓存却仍用高精度,那它就会成为显存中的“大户”。
在多卡并行推理时,每一张卡都需要为其负责的注意力头保留完整的序列信息,张量并行虽然分摊了模型权重,但KV缓存并未完全按比例缩小,因为序列维度和K/V在跨卡通信中往往需要全量同步。
KV cache优化技术对比:哪些方法真正立竿见影?
面对“大模型推理显存不够怎么办”这类问题,核心答案就是削减KV缓存,业界常用的手段可以归为四类,效果和代价各不相同。
分组查询注意力GQA与多查询注意力MQA:从源头减量
GQA和MQA的核心思路是让多个查询头共享同一组Key和Value头,这样在做缓存时,不需要为每个头保存K和V,缓存总量可以下降数倍,代价是模型结构需要改变,正在训练的模型可以无损切换,已发布的模型只能在微调时适配。
KV cache量化:用更小箱子装同样的记忆
量化是直接降低KV缓存中每个元素的存储精度,例如把K和V从FP16压缩到INT8,缓存体积立刻减半;压缩到INT4,体积降至四分之一,量化会带来约0.1%到0.5%的精度损失,但对大多数生成任务来说仍在可接受范围内,实际部署中,量化通常与层敏感度分析配合,对关键层保留高精度,非关键层用低精度。
PagedAttention:向操作系统借智慧
vLLM框架提出的PagedAttention是当下最热门的KV缓存优化手段之一,它把连续显存中的KV缓存切成固定大小的“页”,像操作系统管理内存一样处理显存碎片和按需分配,过去KV缓存需要一整块连续显存,导致碎片严重;现在缓存被拆成页,可以分散存放在不连续区域,显存利用率明显提升。
业内专家指出,在实际部署中,PagedAttention往往能让同一批GPU服务更多并发请求,因为它让原本被浪费的碎片显存重新参与分配。
滑动窗口与稀疏注意力:只保留最近的记忆
滑动窗口只缓存最近N个token的KV,窗口之外的旧token不再参与注意力计算,它适合对话和流式生成场景,因为远端信息通常不敏感,稀疏注意力则是用固定模式跳过部分token的注意力计算,减少缓存项,这两种方法的代价是模型可能“遗忘”过远的历史信息,在长文档摘要场景下需谨慎使用。
| 优化方法 | 显存收益 | 实现难度 | 适用场景 |
|---|---|---|---|
| GQA/MQA | 缓存量降低数倍 | 需改模型结构 | 新模型训练、微调 |
| KV量化 | 缓存体积降低50%~75% | 中等,需校准数据集 | 已有模型的推理部署 |
| PagedAttention | 提高显存利用率,减少碎片 | 低,可直接用推理框架 | 高并发服务、多用户场景 |
| 滑动窗口 | 缓存上限固定在窗口大小 | 低,需调窗口长度 | 单轮长文本、对话生成 |
如果显存还是不够,怎么估算并规划部署?
先别急着换更大的GPU,按以下步骤把KV缓存占用量摸清。
第一步:查模型配置。 从模型的config.json文件里读三个值:层数、注意力头数、KV头数,如果模型用了GQA,config里通常有num_key_value_heads字段。
第二步:代入公式。 使用上面的公式计算单请求每token占用,再乘以目标序列长度和并发数,比如7B模型的MHA变体,2048上下文下每并发约1GB,如果计划支持16路并发,KV缓存预留16GB。
第三步:用工具实测。 可以先用单卡跑一个小批量推理,开启torch.cuda.memory_allocated()记录显存占用,关闭KV缓存后再记录一次,两者之差就是KV缓存的实际占用,以Transformers库为例,在generate()方法中设置use_cache=False作为对照组。
第四步:参考同类配置。 在A100或H100上跑7B模型时,如果序列长度控制在2048以内,显存大头依然是模型权重;一旦上下文拉长到8192或更高,KV缓存就会反超权重成为主要压力。
如果预算有限,优先考虑KV量化加PagedAttention的组合,这样既不需要改模型结构,又能让现有GPU容纳更多并发,对70B级别模型,则强烈建议使用GQA结构的变体,否则KV缓存很容易撑爆单卡80G的显存。
关于KV缓存显存压力的常见问题
关闭KV缓存会怎样?还能正常推理吗?
能正常推理,但速度会非常慢,关闭KV缓存意味着每个新token生成时都要重新计算整个之前序列的Key和Value,计算复杂度从近似线性变成二次方增长,在实际使用中,use_cache=False常用于测试显存基线,不建议用于生产推理。
KV cache和模型权重哪个更占显存?
要看上下文长度和并发数,在短文本、低并发场景下,模型权重通常是主要占用者;在长上下文、高并发场景下,KV缓存会很快超过权重,行业经验表明,当序列长度超过4096且并发数大于8时,KV缓存占比往往达到总显存的一半以上。
量化KV缓存会不会影响回答质量?
对于多数生成任务,INT8量化的影响较小,INT4量化在敏感任务如数学推理上可能出现更多错误,实际部署时建议先在小批样本上对比回答质量,再决定是全局量化还是分层混合量化,更稳妥的做法是保留最后几层的高精度KV,只对浅层做低精度量化,这样质量和显存能取得更好的平衡。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625183.html