大模型的算法要求技术原理,通俗讲讲很简单,其核心逻辑在于通过海量数据训练一个超级复杂的数学公式,让机器具备了“猜下一个字”的能力,并在此基础上涌现出理解与推理的智慧,这并非玄学,而是一场基于概率统计、计算架构与优化算法的精密工程,其本质是将人类的语言知识压缩进神经网络参数之中。

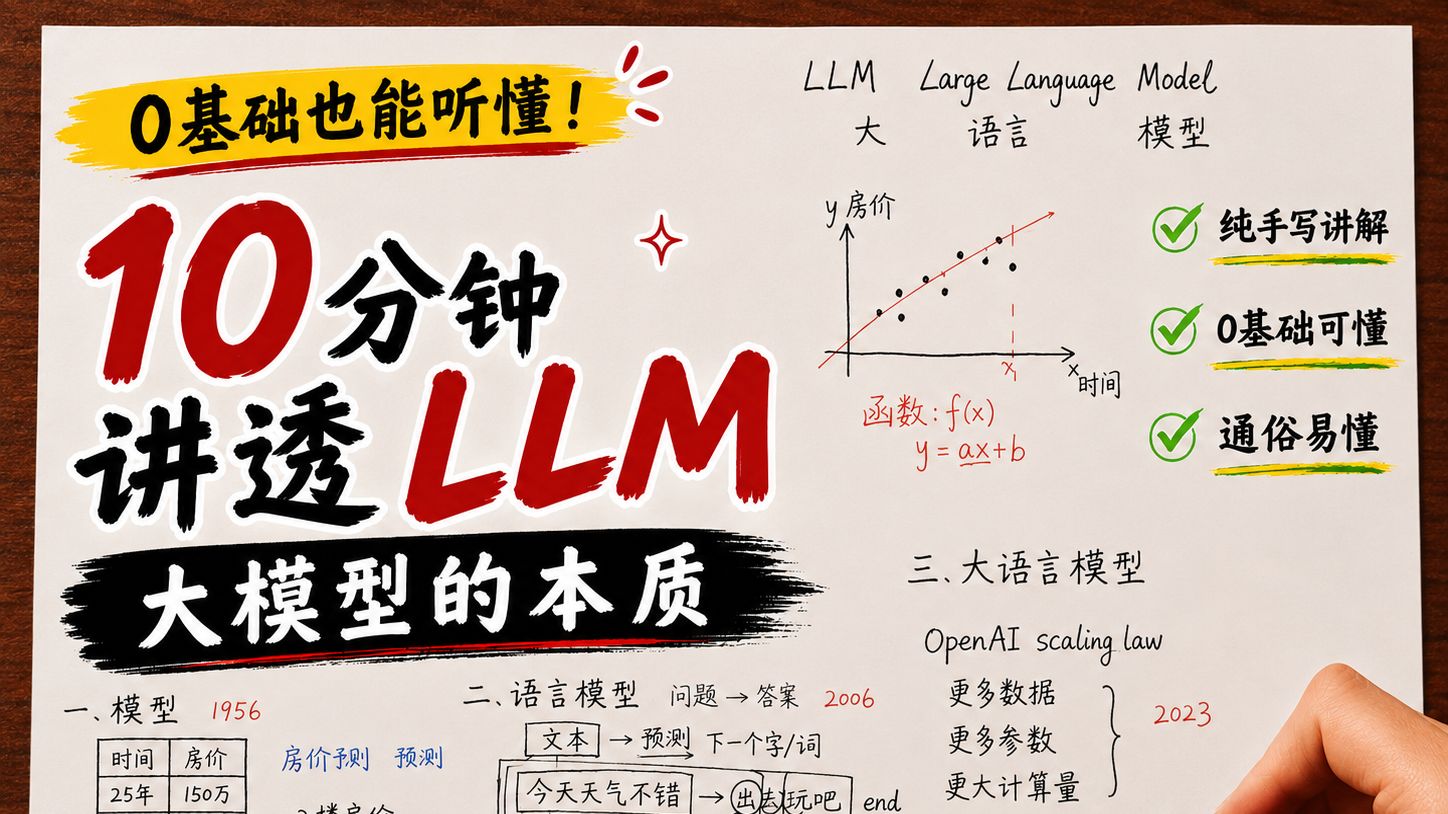

核心结论:大模型是“大力出奇迹”的数学产物
大模型的智能并非凭空产生,它是“大数据、大算力、强算法”三者深度融合的产物,算法构建了学习机器的骨架(神经网络架构),算力提供了运转的动力,而数据则是喂养机器的养料。大模型的算法要求技术原理,通俗讲讲很简单,就是构建一个拥有千亿级别参数的深度神经网络,通过不断调整这些参数,让模型输出的内容无限接近于真实世界的语言规律。 这一过程解决了传统人工智能无法处理模糊性、上下文和创造性表达的难题。
算法基石:Transformer架构的颠覆性创新
要理解大模型,必须先理解其“心脏”Transformer架构,这是大模型算法的技术底座,它彻底改变了机器处理语言的方式。
-
并行计算能力的突破
传统的循环神经网络(RNN)像是一个阅读速度慢的人,必须读完前一个字才能读后一个字,效率极低且容易遗忘长距离的信息,Transformer架构引入了“自注意力机制”,让模型能够一次性看到整篇文章,并行处理所有数据,这就像从单车道变成了双向八车道的高速公路,极大地提升了训练效率,使得训练千亿参数的超大模型成为可能。 -
自注意力机制:让机器懂语境
这是大模型算法中最核心的独创点。它解决了“一词多义”和“长距离依赖”的问题。 “苹果”这个词,在“我爱吃苹果”和“苹果发布了新手机”中意思完全不同,自注意力机制让模型在处理每个字时,都能动态地关注到句子中其他相关的字,模型不再是死记硬背,而是学会了根据上下文环境来判断词义,这正是大模型具备理解能力的根源。
训练过程:从“乱猜”到“预言家”的进化之路
大模型的算法原理在训练阶段体现得淋漓尽致,这个过程可以形象地比喻为“做题与纠错”。
-
预训练:海量数据的无监督学习
这是大模型获得通识能力的阶段,模型被投喂了互联网上万亿级别的文本数据,算法要求模型根据上文预测下一个字,起初,模型是乱猜的,但随着数万亿次的计算,它逐渐学会了语法结构、逻辑推理甚至世界知识。这一阶段不依赖人工标注,完全靠数据本身的规律进行学习,算法的核心要求是能够处理极大规模的稀疏数据。
-
微调:人类价值观的对齐
光有预训练,模型可能只是一个“懂很多但说话难听”的怪才,微调阶段引入了人类反馈强化学习(RLHF),就是人类老师教模型如何说话,人类给出问题和标准答案,让模型模仿;或者对模型的多个回答进行打分,告诉它哪个更好,算法在此时的核心任务是优化奖励模型,让模型的输出符合人类的价值观、安全规范和表达习惯。

算法要求的关键技术难点与解决方案
大模型的算法不仅仅是搭建网络,更涉及一系列精密的工程要求,以确保模型既聪明又好用。
-
参数规模的突破与稀疏激活
随着模型参数从亿级迈向万亿级,算法面临着显存爆炸和计算缓慢的挑战。混合专家模型技术成为了关键解决方案,它将一个大模型拆分成许多个“小专家”,在处理不同任务时,只激活其中相关的部分专家,而不是动用全部参数,这既保证了模型的智商,又大幅降低了推理成本。 -
位置编码与长文本处理
语言是有顺序的,Transformer架构本身不具备时序概念,算法通过引入位置编码,给每个字打上“位置标签”,让模型区分“我爱你”和“你爱我”的区别,现代算法更是通过旋转位置编码等技术,让模型能够处理几十万字的超长文本,实现了“长记忆”。 -
tokenizer(分词器)的优化
在算法层面,机器不直接看汉字,而是看“Token”(词元),分词器的质量直接决定了模型的效率和理解力,优秀的算法要求分词器既能压缩文本长度,又能保留语义完整性,将常用的成语作为一个Token处理,能显著提升模型的运算速度和理解深度。
推理与应用:从概率分布到自然语言
当用户向大模型提问时,算法的工作原理同样精妙。
-
概率预测与采样策略
模型输出的每一个字,实际上都是计算出的概率分布,例如输入“床前明月”,模型计算出“光”字的概率是90%,“亮”字是5%,算法通过“温度参数”来控制输出的随机性,温度低,模型倾向于选概率最高的字,回答严谨但枯燥;温度高,模型可能选概率较低的字,回答更有创造性。这种基于概率采样的生成机制,是大模型能够进行文学创作和代码编写的数学基础。 -
解码加速技术
为了让用户更快看到答案,算法采用了KV-Cache(键值缓存)等技术,模型在生成每个新字时,不需要重新计算之前所有字的向量,而是直接读取缓存中的结果,这极大地优化了用户体验,实现了毫秒级的响应速度。

独立见解:算法未来的演进方向
当前大模型算法虽然强大,但仍存在幻觉、时效性差等问题,未来的算法演进将呈现两大趋势:一是架构的极简与高效化,如Mamba等线性注意力机制架构的出现,试图在保持性能的同时降低计算复杂度;二是神经符号AI的融合,将深度学习的感知能力与符号逻辑的推理能力结合,解决大模型不懂算术、逻辑易错的短板,这将是人工智能从“模拟人类直觉”迈向“具备严谨逻辑”的关键一步。
相关问答模块
大模型的算法是如何解决“幻觉”问题的?
大模型产生“幻觉”(一本正经胡说八道)的根本原因在于它是基于概率生成而非事实检索,目前的算法解决方案主要包括:引入检索增强生成(RAG)技术,让模型在回答前先查阅外部知识库,将准确的事实注入提示词中;在训练阶段增加事实性奖励信号,惩罚编造事实的行为;以及开发思维链算法,强制模型展示推理过程,便于人类核查逻辑漏洞。
为什么大模型需要如此巨大的算力支持?
大模型的算法本质是大规模矩阵乘法运算,一个千亿参数的模型,每一次训练迭代都需要更新千亿个数值,这就好比要在一片拥有千亿个山峰的山脉中寻找最低点(最优解),每走一步都需要计算所有山峰的坡度,这种天文数字级别的计算量,必须依赖高性能GPU集群的并行计算能力才能在可接受的时间内完成,算力是算法得以落地的物理基础。
深入解析了大模型背后的技术逻辑,如果您对大模型的训练细节或具体应用场景有更多见解,欢迎在评论区留言讨论。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/69738.html