大模型部署后的性能监控核心在于建立涵盖响应延迟、吞吐量及资源占用的全链路实时观测体系,通过自动化告警与动态扩缩容机制,确保模型在生产环境中的高可用性与成本可控。
将大模型从实验室推向生产环境,就像把一辆跑车开上繁忙的高速公路,光有引擎强劲还不够,你得知道它现在跑得快不快、油耗高不高、会不会过热,很多团队在模型上线初期往往只关注准确率,却忽视了部署后的“体检”工作,直到用户投诉卡顿、服务器账单爆表才后知后觉,性能监控不是事后诸葛亮,而是保障业务连续性的生命线。

大模型部署模型性能监控的关键指标体系
监控什么比怎么监控更重要,大模型与传统Web应用不同,其推理过程具有高度的计算密集型和随机性,业内专家指出,构建监控体系必须抓住三个核心维度:速度、效率和稳定性。
延迟与吞吐量:用户感知的直接体现
延迟是用户感知最明显的指标,它不仅仅是一个数字,而是决定用户体验生死的关键,我们需要区分首字延迟(TTFT)和生成速度。
- 首字延迟(Time To First Token):这是用户按下“发送”后,看到第一个字的时间,对于聊天机器人,这通常要求在1秒以内,否则用户会感到明显的等待焦虑。
- 每秒生成令牌数(Tokens Per Second):这反映了模型的生成流畅度,如果数值过低,长文本生成会变得断断续续,严重影响阅读体验。
- 请求吞吐量(Throughput):单位时间内系统能处理的请求总量,在促销或热点事件期间,吞吐量直接决定了系统是否会崩溃。
资源利用率:成本控制的核心
GPU资源昂贵,如何榨干每一分算力是运维团队的必修课,监控资源使用率不仅能防止资源浪费,还能预判硬件瓶颈。
- GPU显存占用率:显存不足会导致OOM(内存溢出)错误,直接中断服务,监控显存峰值有助于优化批处理大小(Batch Size)。
- GPU计算利用率:如果利用率长期低于50%,说明存在算力闲置,可能需要调整并发策略或更换更合适的推理引擎。
- CPU与内存压力:数据预处理和后处理往往消耗大量CPU资源,忽视这部分监控会导致CPU成为新的瓶颈。

量化指标的具体采集方法
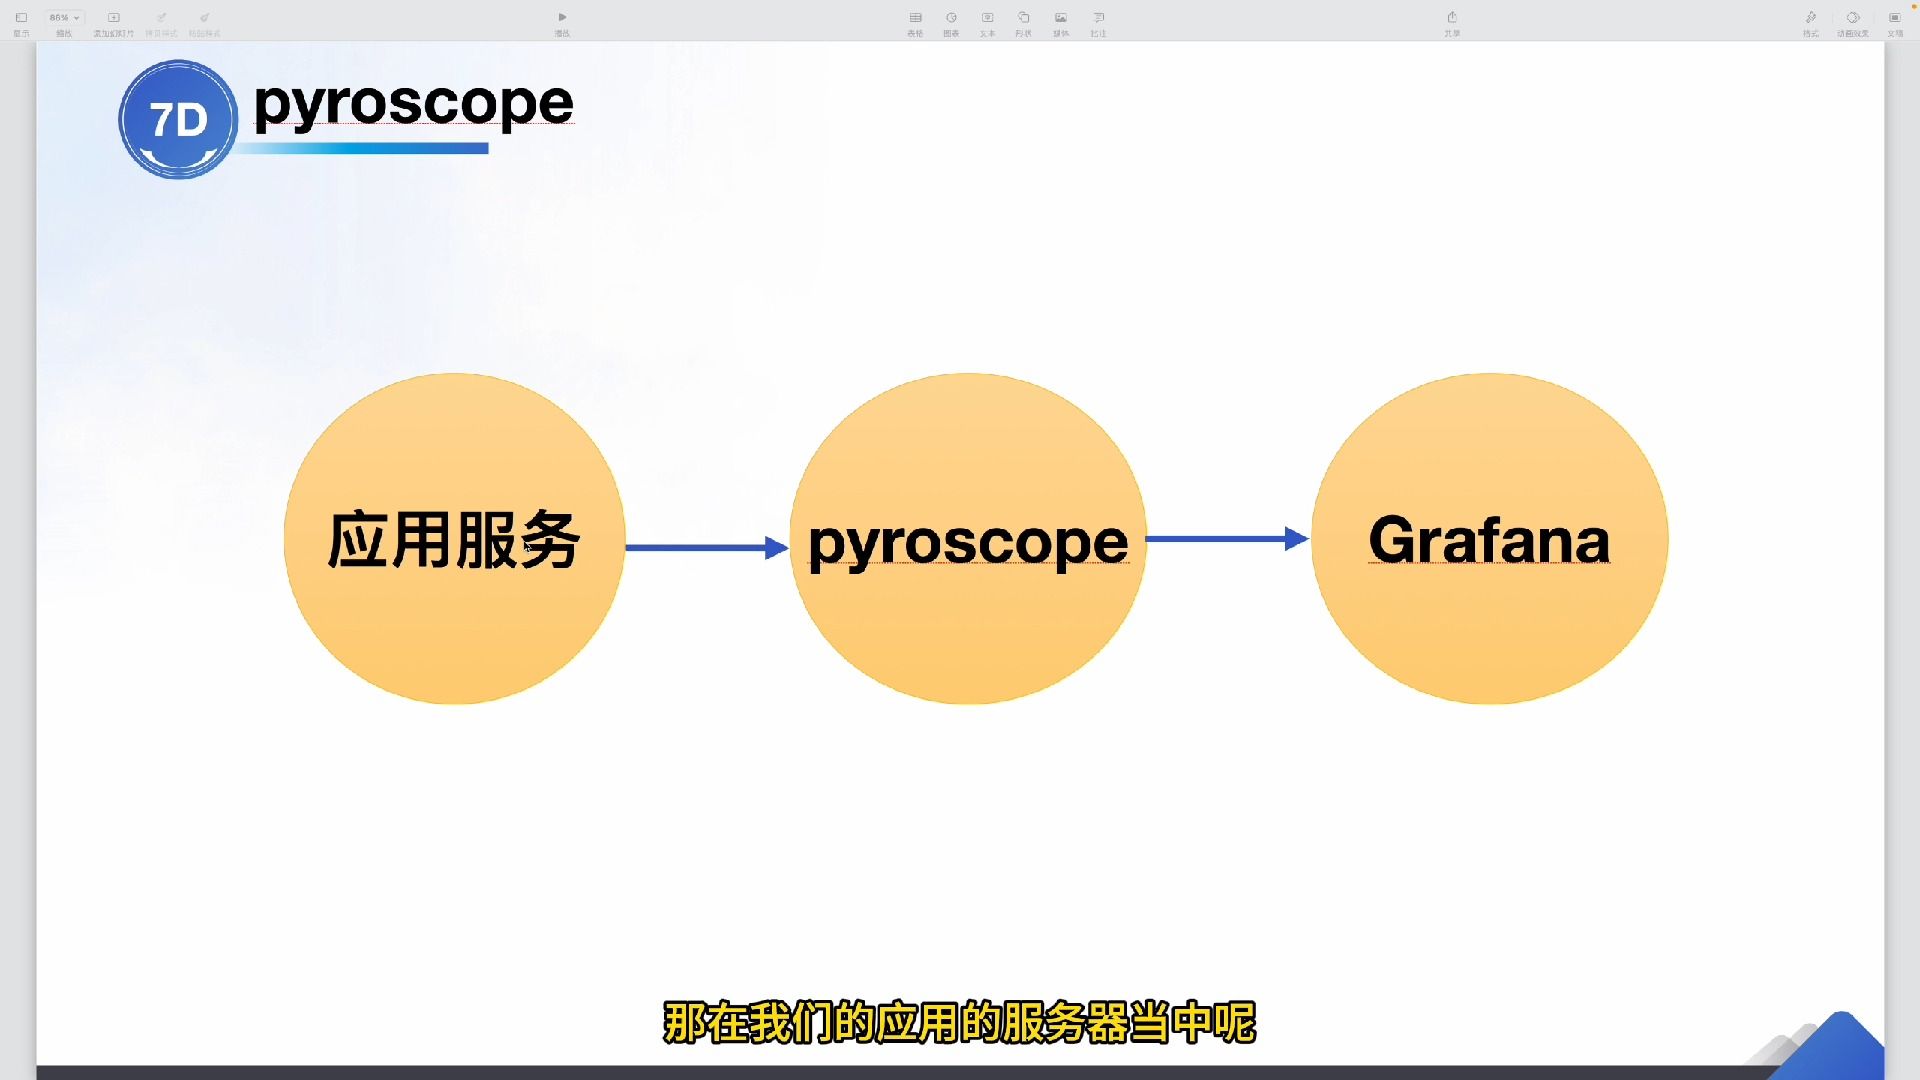
在实际操作中,推荐使用Prometheus配合Grafana搭建可视化看板,通过导出推理引擎(如vLLM、TGI)的内置指标,可以实时捕捉上述数据,在vLLM中,可以通过/metrics接口获取详细的请求队列长度和GPU利用率。
大模型部署模型性能监控中的常见陷阱与应对策略
监控并非越细越好,过度监控会增加系统负担,而监控盲区则可能导致重大事故,以下是实践中常见的几个陷阱及其解决方案。
长尾延迟被平均数掩盖
平均延迟具有极大的欺骗性,如果90%的请求在100ms内完成,而10%的请求因为缓存未命中或复杂逻辑处理耗时10秒,平均延迟可能看起来依然健康,但这10%的用户体验是灾难性的。
- 解决方案:必须监控P95、P99甚至P999延迟,P99延迟代表了最慢的那1%请求的表现,这才是决定系统稳定性的关键。
- 实操建议:在Grafana中设置分位数统计图表,重点关注P99曲线的波动,一旦P99出现异常尖峰,立即触发告警。
忽略上下文长度对性能的影响
许多监控工具只统计总请求数,却忽略了输入输出的Token数量,处理1000Token的请求和处理10000Token的请求,对GPU的压力截然不同。
- 解决方案:监控应基于“Token级”而非“请求级”,记录每个请求的输入Token数和输出Token数,计算加权平均负载。
- 场景应用:当监控发现长文本请求占比上升时,应考虑引入异步处理机制或限制最大上下文长度,以保护系统稳定性。

动态扩缩容的触发机制
基于上述监控数据,实现自动扩缩容(HPA)是提升资源效率的有效手段。
- 触发条件:当P99延迟超过阈值(如2秒)或GPU利用率持续高于80%时,自动增加推理实例。
- 冷却时间:设置合理的冷却时间(如5分钟),避免因为瞬时流量波动导致频繁启停实例,增加额外开销。
大模型部署模型性能监控实战:从搭建到优化
理论最终要落地,以下是搭建一套基础监控体系的实操路径,适用于大多数基于Kubernetes的大模型部署场景。
第一步:部署监控代理
在Kubernetes集群中部署Prometheus Operator和Node Exporter,对于大模型推理服务,确保每个Pod都暴露了标准的Metrics端口,如果使用vLLM,需在启动参数中开启--disable-log-requests以外的指标导出功能,确保关键数据不被遗漏。
第二步:配置告警规则
告警不是越多越好,而是越精准越好,建议设置三级告警:
- Warning(警告):P99延迟超过1.5秒,或GPU利用率超过75%,此时系统仍可运行,但需关注。
- Critical(严重):P99延迟超过3秒,或出现OOM错误,此时需立即介入,可能触发自动扩容。
- Emergency(紧急):服务完全不可用,错误率超过1%,需立即启动应急预案,如切换备用模型或降级服务。
第三步:建立性能基线与持续优化
监控数据积累到一定量级后,可以建立性能基线。
- 基线对比:将当前性能与历史基线对比,识别异常波动,某次模型更新后,虽然准确率提升,但延迟增加了20%,这就需要权衡优化。
- 压力测试:定期使用Locust或JMeter对服务进行压力测试,模拟高并发场景,验证监控系统的灵敏度和扩容策略的有效性。
大模型部署模型性能监控价格与成本考量
很多团队担心监控本身

会带来高昂成本,开源方案如Prometheus+Grafana组合,在中小规模部署下几乎零成本,主要成本在于存储历史数据的时间序列数据库(如Thanos或Cortex)以及运维人力,对于大规模集群,建议采用云厂商提供的托管监控服务,虽然有一定费用,但能大幅降低运维复杂度,据工信部数据,采用自动化监控体系的团队,其故障恢复时间平均缩短了60%,长期来看显著降低了运维成本。
大模型部署模型性能监控常见问题解答
大模型部署模型性能监控中如何平衡监控精度与系统开销?
监控本身确实会消耗少量CPU和内存资源,但现代监控代理(如OpenTelemetry)已高度优化,开销通常低于1%,为了平衡精度与开销,建议采用采样策略,对于高频指标(如请求计数),可以全量记录;对于低频但重要的指标(如特定错误的堆栈跟踪),可以采用采样记录,避免在监控查询中执行复杂的聚合计算,尽量在数据采集端完成初步聚合。
大模型部署模型性能监控发现延迟突然升高,如何快速定位原因?
延迟升高通常由三个原因引起:资源争抢、网络瓶颈或模型内部异常,首先检查GPU利用率和显存占用,确认是否因并发过高导致排队,检查网络延迟,特别是跨可用区通信时的网络抖动,查看模型日志,确认是否有大量超时或错误请求,如果以上均正常,考虑是否因输入数据复杂度突然增加(如长文档解析)导致,此时应调整批处理大小或引入异步队列。
大模型部署模型性能监控是否适用于边缘部署场景?
适用于,但需简化架构,边缘设备资源有限,无法运行复杂的Prometheus集群,建议采用轻量级监控方案,如使用StatsD或InfluxDB Line Protocol直接上报关键指标至云端监控平台,重点关注GPU温度、显存占用和推理延迟,忽略复杂的分布式追踪,对于边缘场景,稳定性优于精细化分析,确保核心指标不丢包即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/396688.html