大模型部署Prometheus监控的核心在于构建“指标采集-存储分析-告警通知”闭环,通过自定义Exporter暴露LLM特有指标(如Token吞吐量、推理延迟、显存占用),并结合Grafana实现可视化,从而保障高并发下的服务稳定性。
在2026年的AI基础设施环境中,大语言模型(LLM)的应用已从“尝鲜”转向“深水区”,企业不再仅仅关注模型本身的准确率,更关心在生产环境中如何稳定、低成本地运行这些庞然大物,Prometheus作为云原生时代的监控标准,凭借其强大的生态和灵活的查询语言,成为大模型服务监控的首选方案,传统的服务器监控无法覆盖LLM特有的业务逻辑,如何针对大模型特性定制监控体系,成为运维团队面临的首要挑战。

大模型监控与传统监控的本质差异
许多团队在初期直接套用传统Web服务的监控模板,结果发现数据虽然齐全,却无法解释业务瓶颈,业内专家指出,大模型服务的监控维度具有显著的“双重性”,既包含底层基础设施资源,又包含上层业务逻辑指标。
基础设施层:算力与资源的精细化管控
大模型推理对硬件资源极度敏感,尤其是GPU显存和计算单元,传统的CPU利用率监控在这里往往滞后,因为GPU的利用率可能在瞬间飙升导致OOM(内存溢出),而CPU可能仍处于空闲状态。
- 显存碎片化监控:大模型加载后,显存分配往往不连续,需要监控显存使用率及碎片程度,防止因碎片化导致的分配失败。
- GPU温度与功耗:高负载下GPU过热会触发降频,直接导致推理延迟激增,监控GPU温度曲线有助于提前发现散热瓶颈。
- PCIe带宽瓶颈:在数据预处理阶段,CPU与GPU之间的数据传输可能成为瓶颈,需监控PCIe带宽利用率。
业务逻辑层:LLM特有的性能指标
这是大模型监控的核心差异点,普通的HTTP请求成功率无法反映模型生成的质量或效率,我们需要关注以下关键指标:
- 首字延迟(TTFT):Time To First Token,即从用户提问到模型输出第一个字的时间,这是影响用户体验最关键的指标,通常要求控制在秒级以内。
- 生成速率(Tokens/Second):模型每秒生成的Token数量,该指标直接反映系统的吞吐能力,是评估扩缩容策略的重要依据。
- 上下文窗口利用率:监控输入Prompt的长度及占用比例,防止超出模型最大上下文限制导致服务中断。

构建大模型专属Prometheus监控体系
要实现上述指标的采集,不能仅依赖Prometheus默认的Node Exporter,必须开发或集成针对大模型服务的自定义Exporter,这一过程涉及代码埋点、指标暴露和配置优化三个关键环节。
指标采集:自定义Exporter的开发路径
目前主流的大模型推理框架(如vLLM、TGI、Llama.cpp)大多已内置Prometheus指标暴露接口,对于自研服务,需遵循以下步骤:
- 定义指标类型:在代码中定义Gauge(瞬时值,如显存使用率)、Counter(累计值,如总请求数)、Histogram(分布值,如请求延迟分布)。
- 暴露HTTP端点:在服务内部启动一个独立的HTTP服务,监听特定端口(如9100或自定义端口),提供/metrics端点。
- 集成Prometheus Client库:使用Python或Go语言的官方Prometheus客户端库,将业务逻辑中的关键数据注册为指标。
在Python中,可以通过以下逻辑暴露首字延迟:
代码示例逻辑
from prometheus_client import Histogram, start_http_server
定义延迟直方图
request_latency = Histogram('llm_request_latency_seconds', 'LLM Request Latency')
在推理函数中记录
with request_latency.time():response = model.generate(prompt)
服务发现与配置优化
在大模型集群中,Pod的创建和销毁频率极高,静态配置Prometheus目标显然不可行,必须采用Kubernetes Service Monitor或Endpoint Slice进行自动服务发现。
- 标签管理:为每个指标打上清晰的标签(Label),如model_name(模型名称)、version(版本)、region(地域),这有助于在多模型混合部署时进行隔离分析。
- 采样率调整:大模型请求量可能巨大,全量采集会导致存储压力,对于高频指标(如每秒请求数),可适当调整采集间隔;对于低频关键指标(如错误率),保持高频采集。

可视化分析与告警策略设计
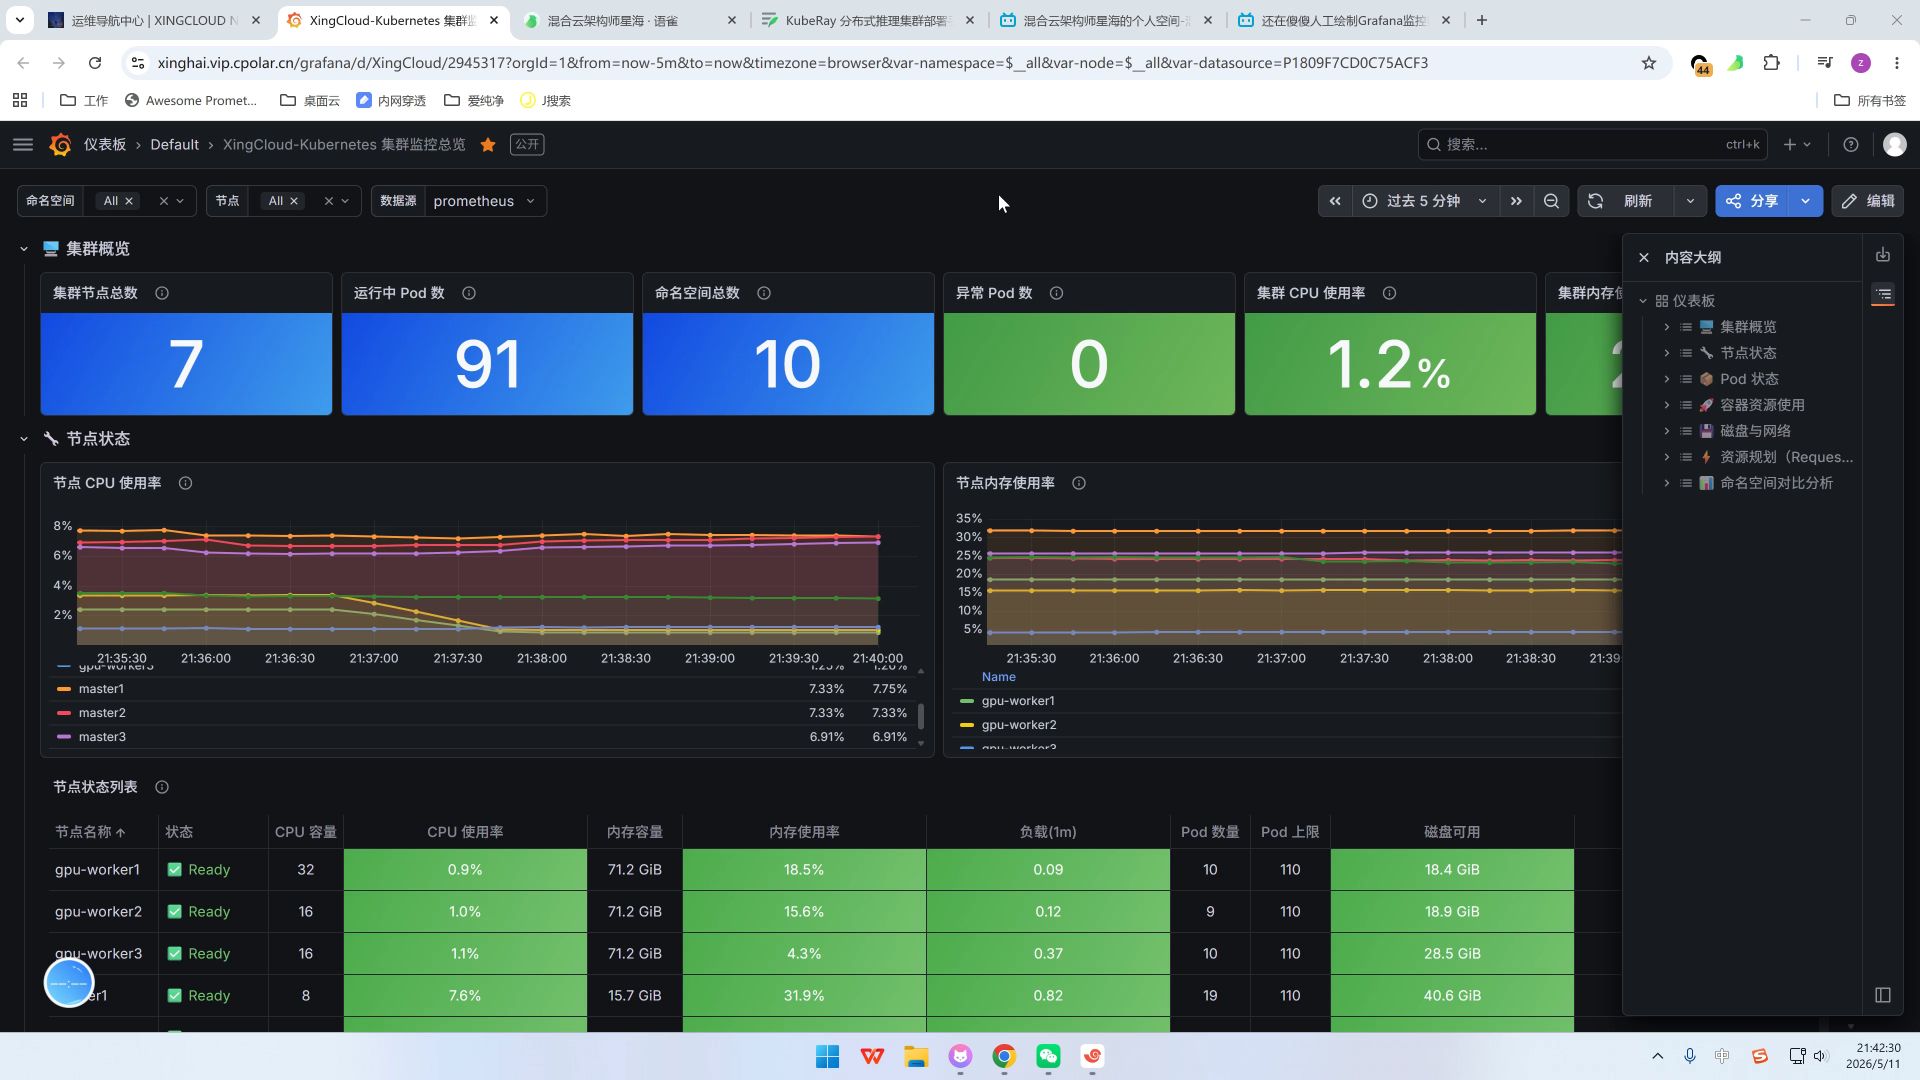
采集到数据只是第一步,如何从海量数据中提取洞察并快速响应异常,才是监控的价值所在,Grafana作为事实上的可视化标准,提供了强大的仪表盘构建能力。
Grafana仪表盘设计原则
一个优秀的大模型监控仪表盘应遵循“由总到分”的视觉层级。
- 概览层:展示核心KPI,如当前QPS、平均TTFT、错误率,使用大字体数字面板,一目了然。
- 趋势层:展示过去1小时、24小时、7天的指标变化趋势,通过折线图观察负载波动,识别高峰时段。
- 分布层:使用热力图或直方图展示延迟分布,观察99%的请求延迟是否超出SLA阈值。
智能告警:避免告警风暴
大模型服务的异常往往具有突发性,简单的阈值告警(如“延迟>1s”)容易引发误报,建议采用复合告警策略:
- 多条件组合:同时满足“延迟升高”且“错误率上升”才触发P0级告警。
- 动态基线:利用Prometheus的环比比较功能,当指标偏离过去7天同期基线超过20%时触发告警,适应业务自然波动。
- 分级通知:P0级(服务不可用)电话通知值班人员;P1级(性能下降)钉钉/企微通知;P2级(轻微异常)邮件汇总。
常见场景下的监控难点与解决方案
在实际落地过程中,不同场景下的监控需求存在显著差异,据行业共识认为,针对高并发推理和私有化部署两种典型场景,需采取不同的优化策略。
高并发推理场景:重点监控排队与限流
当并发请求超过模型处理能力时,请求会在队列中积压,监控重点应从“响应速度”转向“队列深度”。
- 监控指标:Pending Requests(排队请求数)、Rejected Requests(被拒绝请求数)。
- 应对策略:当排队数超过阈值时,自动触发水平扩缩容(HPA),增加推理实例数量,前端应实施优雅降级,提示用户稍后重试。

私有化部署场景:关注成本与资源利用率
对于在本地数据中心部署大模型的企业,成本控制是核心诉求,监控需结合资源利用率,评估性价比。
- 监控指标:GPU利用率、每Token成本(Cost per Token)、空闲实例比例。
- 应对策略:在低峰期自动缩容实例,释放GPU资源,通过监控发现长期低利用率实例,及时下线或转作其他用途。
大模型部署Prometheus监控常见问题解答
大模型监控中Prometheus存储成本过高如何解决?
随着Token生成量的增加,时序数据量呈指数级增长,业内专家指出,长期存储全量高频数据并不经济,解决方案是采用分层存储策略:将最近7天的原始数据存储在本地Prometheus中,用于快速查询和告警;将7天以上的数据归档至Thanos或Cortex等长期存储后端,并降低保留数据的采样率(如从1秒降至1分钟),对于非关键指标,可设置较短的保留期限,仅保留核心业务指标长期存储。
如何区分是模型问题还是基础设施问题导致的延迟升高?
这需要结合多维指标进行根因分析,若TTFT升高,但GPU利用率正常且无OOM错误,可能是Prompt预处理或网络传输延迟所致,需检查CPU负载和网络带宽,若GPU利用率达到100%且排队数激增,则是算力瓶颈,需扩容GPU实例,若出现大量500错误且显存波动剧烈,可能是模型本身存在Bug或输入数据异常,需检查日志和输入数据质量,通过关联分析基础设施指标与业务指标,可快速定位问题源头。
Prometheus监控是否适用于所有类型的大模型服务?
Prometheus适用于绝大多数基于HTTP/gRPC协议的大模型服务,包括开源框架(vLLM、TGI)和自研服务,对于某些封闭API服务商(如部分商业云厂商),若其不提供自定义Exporter,则需通过API网关日志或外部探针进行间接监控,对于实时流式输出场景,需确保Exporter支持流式数据的高效采集,避免内存泄漏,总体而言,只要服务暴露了标准的指标接口,Prometheus均可有效监控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/397494.html