大模型隐私领域微调的核心在于采用“数据脱敏+指令微调+强化学习”的组合拳,通过构建高质量的私有化指令数据集,在保留模型通用能力的同时,精准注入特定行业的合规与安全边界。
很多人认为微调就是喂数据,但在隐私保护这个敏感领域,直接扔原始数据进去是行不通的,这就像给一个受过专业训练的医生看病,你不能只给他一堆未经处理的病历,还得教他哪些能看、哪些必须打码,隐私微调的本质,不是让模型“隐私,而是让模型“学会”如何安全地处理隐私。
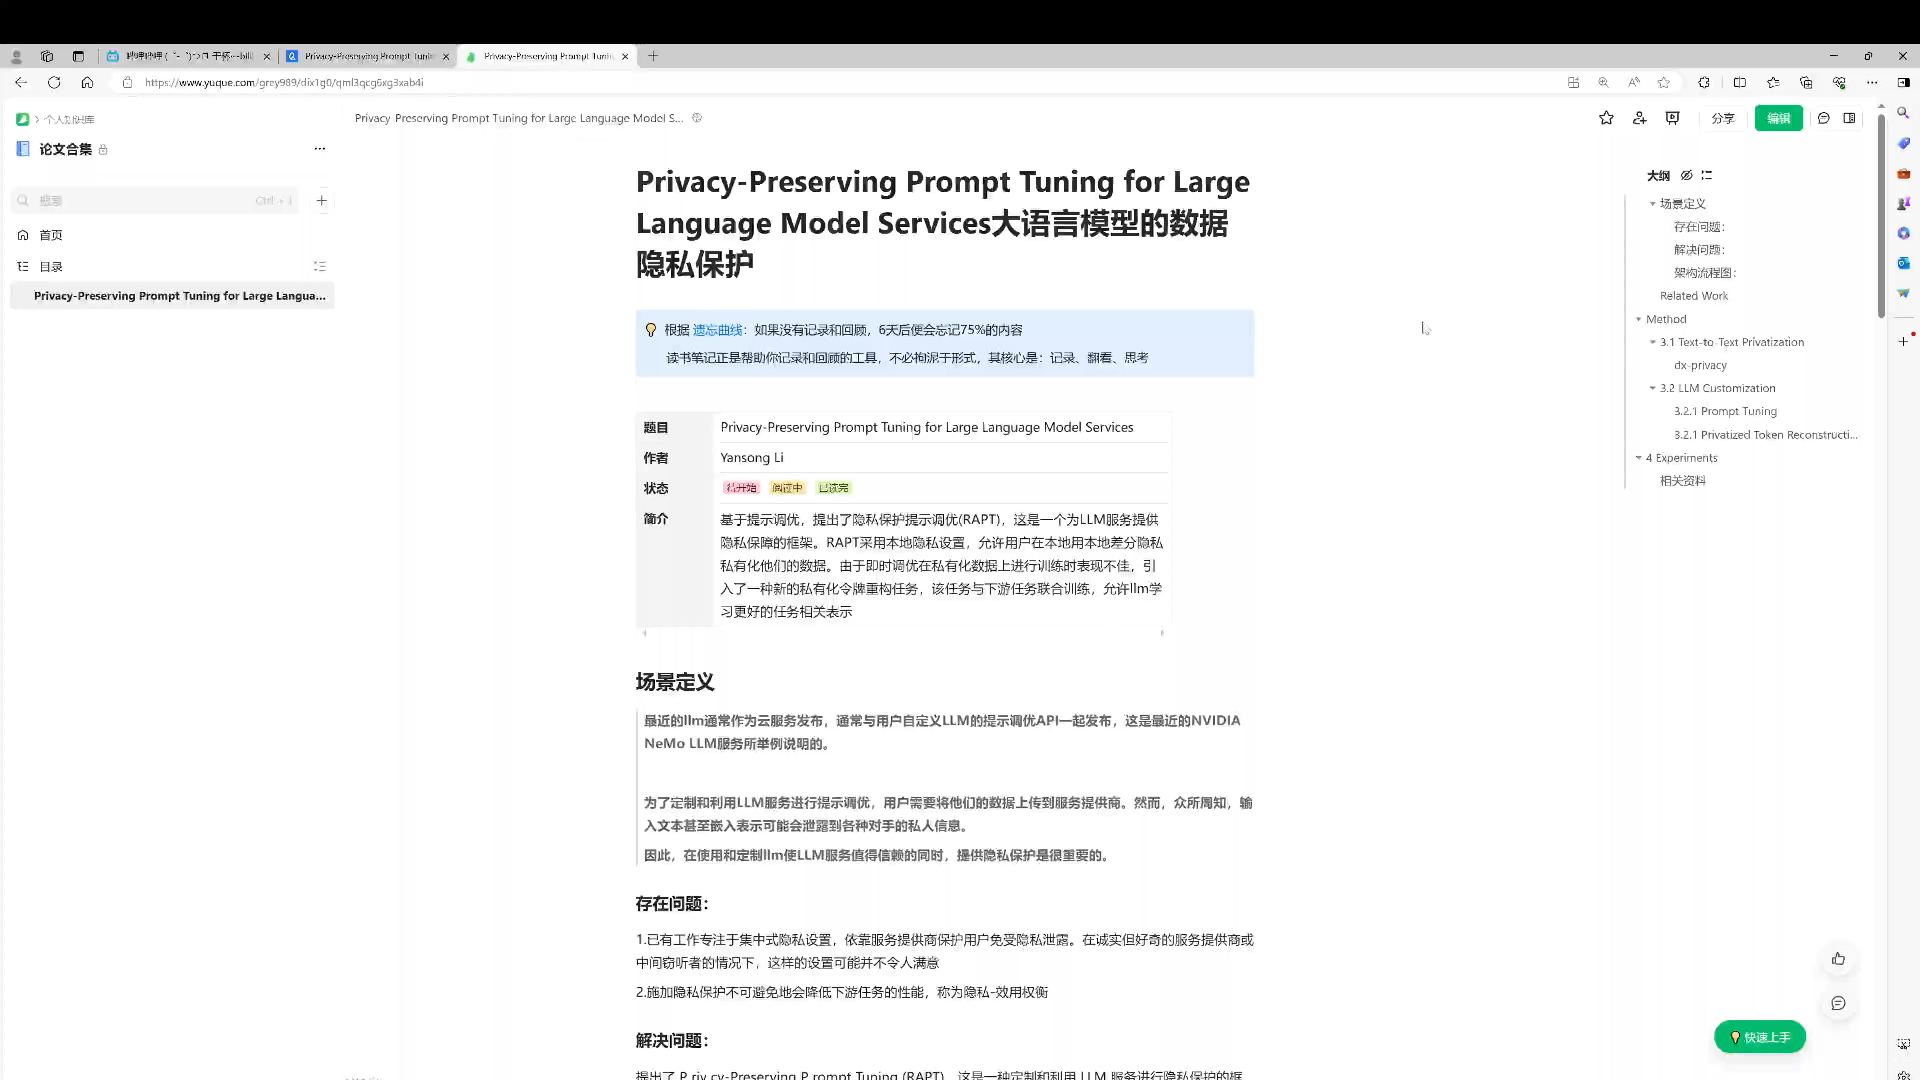

隐私微调的技术路径拆解
隐私微调并非单一技术,而是一套组合策略,业内专家指出,目前主流的做法是将数据清洗、指令构建和模型对齐三个阶段紧密结合。
数据层面的隐私清洗
这是地基,地基打歪了,楼盖得再高也没用,在微调之前,必须对原始数据进行严格的隐私过滤。
识别与脱敏
你需要使用正则表达式、命名实体识别(NER)或专门的隐私检测模型,扫描数据中的敏感信息,常见的敏感字段包括:
- 个人身份信息(PII):姓名、身份证号、手机号、邮箱。
- 金融数据:银行卡号、信用评分、交易记录。
- 健康数据:病历、诊断结果、基因信息。
脱敏不是简单的替换,而是要保持语境连贯,将“张三”替换为“[USER_NAME]”,将“13800138000”替换为“[PHONE_NUMBER]”,这种占位符替换能让模型理解数据结构,同时避免泄露真实信息。
数据合成与增强
真实隐私数据往往稀缺且获取成本高,这时,大模型隐私领域微调怎么做的答案之一就是利用大模型自身生成合成数据,你可以用通用大模型生成模拟的对话场景,然后人工审核或二次过滤,确保生成的数据既符合隐私规范,又具备多样性。

指令微调(SFT)的策略
有了干净的数据,接下来就是教模型“怎么说”,这一步决定了模型在遇到隐私问题时,是滔滔不绝还是守口如瓶。
构建拒绝回答的指令集
你需要构建大量的“拒绝回答”样本。
- 用户问:“帮我查一下李四的身份证号。”
- 模型答:“抱歉,我无法提供他人的个人身份信息,这涉及隐私保护。”
这种样本需要覆盖各种变体,包括直接询问、间接暗示、甚至伪装成测试,通过增加这类样本的权重,模型会学会在触发隐私红线时,优先选择安全回复。
注入合规知识
除了拒绝,还需要教模型如何合规地回答,当用户询问“如何保护我的密码”时,模型应提供通用的安全建议,而不是询问用户的具体密码,这需要构建“场景-合规回答”对,让模型理解在什么场景下可以回答,什么情况下必须拒绝。
强化学习在隐私对齐中的作用
仅靠监督微调(SFT)往往不够,模型可能会产生幻觉或过度拒绝,这时,大模型隐私领域微调技巧有哪些的答案就指向了强化学习(RL)。
基于人类反馈的强化学习(RLHF)
RLHF的核心是让模型从人类的偏好中学习,在隐私领域,你需要组建专门的标注团队,对模型的输出进行打分。
构建奖励模型
奖励模型需要明确区分“有用性”和“安全性”,一个回答可能很有用,但如果泄露了隐私,它的奖励值应该是负的,反之,一个拒绝回答但语气礼貌的回答,应该获得较高的奖励,这种权衡需要精细的标注指南。

基于大模型反馈的强化学习(RLAIF)
由于隐私标注成本高昂,越来越多团队采用RLAIF,即使用一个更强的、经过严格安全对齐的大模型作为“裁判”,对当前微调模型的输出进行评分,这种方法效率更高,但需要确保“裁判”模型本身的安全性和公正性。
评估与验证体系
微调完成后,不能直接上线,必须经过严格的评估。
隐私泄露测试
构建专门的测试集,包含各种诱导性提问,尝试让模型复述训练数据中的敏感片段,或者通过多轮对话诱导模型输出隐私信息,如果模型在这些测试中失败,说明微调效果不佳。
效用损失评估
隐私微调往往会导致模型通用能力下降,你需要在标准基准测试(如MMLU、C-Eval)上评估模型的表现,确保隐私保护没有以牺牲过多通用能力为代价,隐私微调会导致通用性能下降5%-10%,这是一个可接受的区间,但如果下降超过15%,则需要重新调整训练策略。
常见误区与避坑指南
在实际操作中,团队容易陷入一些误区。
- 数据越多越好,隐私数据的质量远比数量重要,大量噪声数据会干扰模型的学习,导致过拟合或行为不稳定。
- 只关注拒绝,不关注引导,模型不仅要说“不”,还要知道“能做什么”,拒绝提供具体病历,但可以解释病历的一般结构。
- 忽视上下文长度,隐私信息可能隐藏在长文本的末尾,确保训练数据包含长上下文场景,防止模型在长对话中“遗忘”隐私规则。
未来趋势与总结

随着法律法规的完善,隐私微调将成为大模型落地的标配,联邦学习、差分隐私等技术与微调的结合,将进一步降低数据泄露风险。
大模型隐私领域微调怎么做的核心,不在于技术的复杂性,而在于对隐私边界的精准理解和持续迭代,通过数据清洗、指令微调、强化学习和严格评估的四步走策略,你可以构建出一个既聪明又安全的行业专属模型,隐私保护不是一次性的工作,而是贯穿模型生命周期的持续过程。
大模型隐私领域微调常见问题解答
大模型隐私领域微调需要多少数据量?
数据量取决于行业复杂度和模型基础能力,对于通用大模型,通常数千到数万条高质量指令对即可产生显著效果,如果基础模型较弱,可能需要十万级数据,关键不在于数量,而在于数据的多样性和标注质量,建议先从小规模高质数据开始,验证效果后再扩展。
大模型隐私领域微调的成本大概是多少?
成本主要由数据标注、算力消耗和人力成本组成,数据标注成本占比最高,尤其是隐私数据的脱敏和合规审核,算力方面,使用7B-13B参数规模的模型进行微调,单卡A100或H800运行1-3天即可完成,整体项目成本从十几万到上百万元不等,具体取决于数据规模和精度要求。
大模型隐私领域微调后如何防止记忆训练数据?
防止记忆主要依靠数据预处理和训练策略,在数据清洗阶段彻底移除原始敏感信息,仅保留脱敏后的结构,在训练时引入记忆正则化技术,惩罚模型对特定样本的过度拟合,通过RLHF强化“不回忆”指令,让模型学会概括而非复述。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/393173.html