服务器部署爬虫的核心在于根据抓取频率、目标网站复杂度及数据量级,匹配合适的硬件资源与网络环境,通常推荐使用Linux系统配合容器化技术以实现高可用与易维护。
服务器部署爬虫怎么选配置
在进行爬虫部署前,必须明确抓取任务的类型,是简单的静态页面解析,还是需要模拟人工操作的动态网页渲染?这两者的资源消耗存在量级上的差异。

CPU 与计算能力
CPU 的核心数和主频直接影响数据解析的速度,如果爬虫逻辑涉及大量的正则表达式匹配、HTML 树解析(如使用 lxml)或者复杂的加密算法破解,CPU 压力会非常大,业内专家指出,在处理大规模动态网页抓取时,CPU 的多核性能决定了系统能够同时处理多少个并发解析任务。
内存与并发能力
内存是爬虫部署中最容易被忽视的瓶颈,如果使用 Scrapy 等框架,内存占用相对可控;但如果使用 Selenium、Playwright 或 Puppeteer 等需要驱动 Headless Browser(无头浏览器)的工具,内存消耗会呈指数级增长,每个浏览器实例都会占用数百 MB 甚至上 GB 的内存。
网络带宽与延迟
带宽决定了单位时间内能下载的数据总量,对于图片、视频等大文件抓取,带宽是首要考虑因素,服务器所在的地域(如香港、美国或境内)会直接影响到访问目标网站的延迟和成功率。
配置参考方案对比
根据任务规模,可以参考下表进行初步选型:
| 任务规模 | 典型场景 | 建议 CPU | 建议内存 | 建议带宽 | 操作系统 |
|---|---|---|---|---|---|
| 小型任务 | 定时抓取新闻、单页监控 | 1-2 核 | 2GB | 1-5Mbps | Linux |
| 中型任务 |
电商价格监控、社交媒体数据 | 4-8 核 | 8-16GB | 10Mbps+ | Linux |
| 大型任务 | 全网搜索引擎、分布式大规模抓取 | 16 核以上 | 64GB+ | 高带宽/专线 | Linux (集群) |

爬虫部署在Linux还是Windows服务器
在实际工程实践中,爬虫部署在Linux还是Windows服务器的选择几乎是定论性的,虽然 Windows 在开发环境下非常友好,但在生产环境部署时,Linux 具有压倒性的优势。
Linux 的绝对优势
- 资源占用极低:Linux 系统(如 Ubuntu Server 或 CentOS)通常没有图形界面,可以将几乎所有的硬件资源都分配给爬虫进程。
- 强大的进程管理:通过
systemd或Supervisor,可以实现爬虫进程的自动重启、监控和日志管理。 - 容器化支持:Docker 在 Linux 环境下的原生支持,使得爬虫环境的迁移和水平扩展变得极其简单。
- Shell 脚本自动化:利用 Cron Job 可以非常方便地实现定时任务调度。
Windows 的局限性
Windows 系统由于图形界面和后台服务的复杂性,在处理高并发任务时会浪费大量内存,在处理复杂的网络协议栈和大规模并发连接时,Linux 的内核优化通常比 Windows 更具优势。
实操:Linux 环境快速搭建爬虫运行环境
以下是在 Ubuntu 系统上部署 Python 爬虫环境的标准路径:
-
更新系统软件包
sudo apt update && sudo apt upgrade -y -
安装 Python 及必要依赖
sudo apt install python3 python3-pip python3-venv -y -
创建虚拟环境(防止污染系统环境)
python3 -m venv crawler_envsource crawler_env/bin/activate -
安装核心库

pip install scrapy requests beautifulsoup4 pandas -
配置持久化运行(使用 Supervisor)
安装 Supervisor 后,编写配置文件/etc/supervisor/conf.d/crawler.conf,设置autostart=true和autorestart=true,确保程序崩溃后能自动拉起。

高并发爬虫服务器部署方案
当抓取规模从万级提升到亿级时,单机部署模式会迅速失效,此时需要构建一套分布式架构。
分布式架构设计
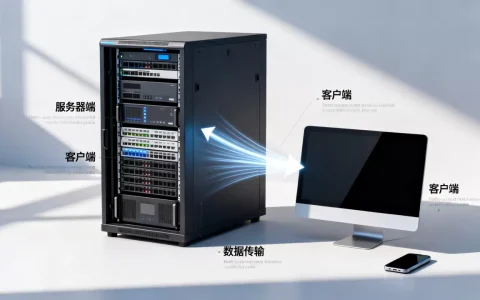
行业共识认为,成熟的分布式爬虫方案通常采用“调度中心 + 执行节点 + 数据存储”的三层架构。
- 调度中心:负责任务的分发,可以使用 Redis 作为任务队列,Scrapy-Redis 框架是目前最主流的实现方式。
- 执行节点:多个爬虫实例从 Redis 中获取 URL,进行抓取并返回结果。
- 数据存储:抓取到的结构化数据存入 MongoDB(适合非结构化数据)或 MySQL(适合强关系数据)。
代理 IP 池的集成
在高并发场景下,频繁请求同一目标网站会导致 IP 被封禁,部署方案中必须集成代理 IP 池。
- 动态代理:通过 API 调用第三方代理服务,每次请求自动更换 IP。
- 自建代理池:利用爬虫抓取公开的代理列表,并结合验证逻辑,维护一个高可用的代理池。
容器化部署路径
使用 Docker 部署可以解决“在我机器上能跑,在服务器上不行”的问题。
- 编写 Dockerfile:将 Python 环境、依赖库、爬虫代码打包成一个镜像。
- 使用 Docker Compose:一键启动“爬虫容器 + Redis 容器 + MongoDB 容器”的组合。
- 编排扩展:在 Kubernetes (K8s) 环境下,可以根据 CPU 负载自动增加爬虫容器的数量,实现真正的弹性伸缩。
云服务器部署爬虫多少钱一个月
对于初学者或中小企业,云服务器部署爬虫多少钱一个月是一个非常现实的问题,价格主要由实例配置、带宽流量和存储空间三个维度决定。
实例配置成本

- 入门级(轻量应用服务器):适合个人开发者,配置通常为 2核2G 或 2核4G,在主流云厂商处,包年包月价格通常在每月 30元至80元 之间。
- 进阶级(标准云服务器):适合企业级任务,配置在 4核8G 以上,价格随配置提升,每月通常在 200元至500元 左右。
带宽与流量成本
这是最容易产生额外支出的部分。
- 固定带宽模式:按月支付固定带宽费用(如 5Mbps),适合流量平稳的任务。
- 按流量计费模式:适合抓取量波动巨大的任务,如果抓取大量图片或视频,流量费用可能会远超服务器本身的租用费。
成本优化策略
- 利用竞价实例:对于对实时性要求不高的离线抓取任务,可以使用云厂商的“竞价实例(Spot Instance)”,价格最高可降低 60%-90%,但前提是需要处理好实例被回收时的任务断点续传问题。
- 地域选择:选择非核心业务区域的机房,通常可以获得更具性价比的配置。
Q&A: 关于服务器部署爬虫的常见问题
服务器部署爬虫如何防止被封 IP?
除了使用代理 IP 池外,还需要模拟真实用户行为,这包括:设置合理的 User-Agent 随机池、控制请求频率(避免短时间内高频请求)、模拟 Cookie 状态以及在请求头中加入 Referer 信息。
爬虫程序运行过程中 CPU 占用过高怎么办?
首先检查是否存在死循环或极其复杂的正则表达式,如果是由于 Headless Browser 引起的,应考虑降低并发的浏览器实例数量,或者改用更轻量级的解析库,可以考虑将任务拆分到多台服务器上进行负载均衡。
部署爬虫时如何保证数据不丢失?
必须实现任务的持久化机制,不要将待抓取 URL 仅存在内存中,而应存储在 Redis 或数据库中,抓取逻辑应具备“断点续爬”能力,即每次启动时能通过检查数据库记录,自动跳过已完成的任务,据统计,完善的异常处理和状态记录机制能将数据丢失率降低到 1% 以下。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/490546.html