容器镜像分层缓存的核心作用是通过复用镜像层,省去重复拉取和解压的开销,从而把训练启动时间从分钟级压缩到秒级。对于跑深度学习任务的同学来说,每次启动新训练任务前等镜像,那几分钟的空白期特别浪费GPU,理解分层缓存机制并合理配置,能让你的训练启动像本地执行一样快。
容器镜像分层缓存是什么原理
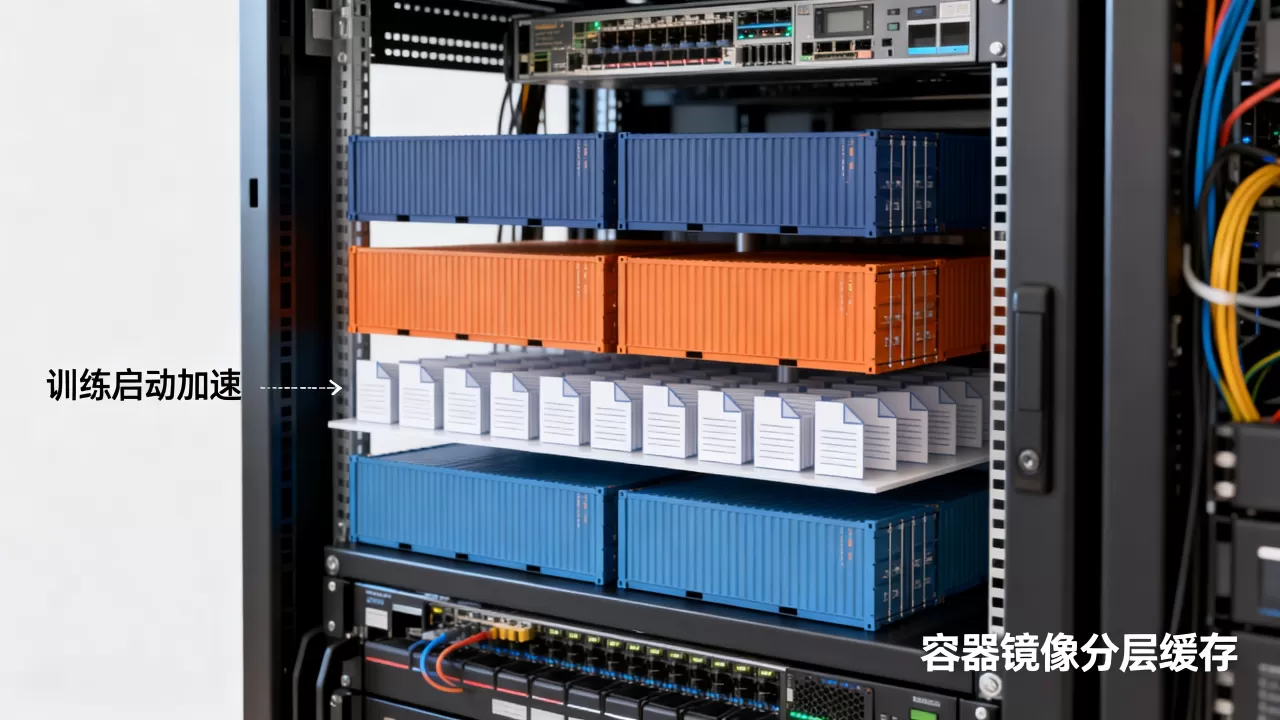
容器镜像由多个只读层叠加而成,每一层对应Dockerfile里的一条指令,比如FROM pytorch/pytorch:2.0-cuda11.7拉取的基础镜像有系统库层、Python环境层、PyTorch依赖层,之后RUN pip install产生的文件又会形成新层,当多个镜像共享相同基础层时,宿主机只需要保存一份层数据,其他镜像直接引用即可。
训练启动时的完整流程包括:从仓库拉取镜像清单、对比本地已有层、只下载缺失层、解压全部层、挂载为可写层,分层缓存起作用的关键就在这里:如果基础镜像没变,那么所有基础层都能命中缓存,实际需要下载的只有你新增的那几层。
传统训练启动慢在哪个环节
很多团队抱怨训练启动慢,其实慢在三个地方:
- 仓库拉取:无缓存时,一个10GB的镜像全部下载,按百兆带宽算也要几分钟。
- 磁盘解压:镜像层通常是压缩格式,解压到本地存储驱动目录需要大量IO操作。
- 文件权限与链接:如果包含大量小文件(比如Python的site-packages里成千上万个.py文件),索引和chown耗时尤其明显。
行业共识认为,超过一半的训练启动延迟来自镜像拉取和解压,而非进程初始化本身。
分层缓存如何精准命中
命中原理并不复杂,但需要理解层ID的生成方式,每一层的内容哈希和元数据共同决定其唯一标识,只要层的内容没有变化,无论来自哪个镜像,都能在本地复用。
实际操作中,最影响命中率的是Dockerfile的指令顺序,把频繁变化的指令放后面,把稳定指令放前面。
FROM pytorch/pytorch:2.0-cuda11.7
RUN apt-get update && apt-get install -y libgl1   # 稳定层
RUN pip install -r requirements.txt               # 需求变化频繁
COPY . /app                                       # 每次都变
如果先COPY代码再pip install,那么每次代码变动都会让后续所有层失效,缓存形同虚设,反过来,先装依赖再拷代码,依赖层就能稳定命中。
训练启动慢怎么办:分层缓存配置实操
针对Kubernetes和单机场景,有几种立即可用的加速手段。
使用registry mirror加速拉取
在Docker daemon或containerd配置中设置镜像仓库镜像地址,让拉取请求先走内网或云厂商的镜像加速器,这样即使冷启动没有本地缓存,网络传输速度也能提升不少。
Docker的/etc/docker/daemon.json示例:
{
  "registry-mirrors": [
    "https://docker.mirrors.ustc.edu.cn",
    "https://hub-mirror.c.163.com"
  ]
}
配置后重启docker,再用docker pull验证速度变化,注意这只影响拉取速度,不改变分层复用逻辑。
预拉取镜像到所有节点
训练任务调度到GPU节点前,提前在节点上执行docker pull或ctr image pull,把镜像层缓存到本地,调度器可配合节点亲和性,确保任务落在预取过的节点上。
具体做法:写一个DaemonSet,用initContainer或postStart钩子预拉取即将使用的镜像。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: pre-puller
spec:
  template:
    spec:
      containers:
      - name: puller
        image: docker
        command: ["docker", "pull", "myregistry/train:latest"]
启用containerd的Stargz或Nydus snapshotter
针对大规模集群,常见的方案是使用支持远程分层的snapshotter,这里以Nydus为例,它把镜像层拆分为元数据和数据块,按需拉取,启动训练时只加载必要的块,配合缓存加速,首次启动也能大幅缩短。
安装参考:先在节点上安装nydus-snapshotter,然后在containerd配置中切换proxy_plugins,操作路径较长,但收益明显,社区反馈中,较大镜像(5GB以上)的启动时间能缩短到原来的三分之一。
用BuildKit缓存构建层
如果你是自己构建训练镜像,BuildKit支持跨构建的层缓存,通过--mount=type=cache挂载包管理器的缓存目录,比如apt或pip的下载缓存,让重复构建不再重复下载依赖包。
# syntax=docker/dockerfile:1.4
RUN --mount=type=cache,target=/var/cache/apt
    apt-get update && apt-get install -y libgomp1
构建时设置docker buildx build --cache-from=type=local,src=/tmp/buildcache,把缓存持久化到本地磁盘,下一次构建直接复用。
不同镜像大小下的缓存加速效果对比
为了让你有直观感受,这里给出一个模拟场景的数据对比,假设训练镜像总大小8GB,基础层占比7GB,业务层1GB,带宽200Mbps。
| 场景 | 有分层缓存 | 无分层缓存 | 说明 |
|---|---|---|---|
| 首次启动(冷缓存) | 约4分钟 | 约4分钟 | 没有区别 |
| 第二次启动(已拉取) | 约15秒 | 约4分钟 | 全部层复用,只需加载到内存 |
| 修改业务代码后 | 约20秒 | 约4分钟 | 仅重拉1GB业务层 |
| 换基础镜像版本 | 约2分钟 | 约4分钟 | 部分层复用取决于相似度 |
数据为单机环境下合理估算,实际值受磁盘IO、带宽和文件数量影响,但趋势明确:分层缓存对重复启动和增量修改的优化幅度是数量级的。
容器镜像分层缓存的常见坑与优化策略
实践中不少团队明明配置了缓存,加速效果却不理想,问题往往出现在下面几个地方。
缓存失效的元凶是先后顺序
前面提过Dockerfile指令顺序,这里再强调一个细节:COPY指令对文件元数据敏感,代码文件的时间戳变化也会导致缓存失效,建议统一用.dockerignore排除无关文件,并在构建时用--mount=type=bind挂载代码而非COPY,这样代码变更不影响层缓存。
拉取策略与调度亲和性
有些集群默认imagePullPolicy: Always,即使节点上有镜像也要重新拉取,训练任务应该改为IfNotPresent,除非你明确需要每次都拉最新版本,调度时增加节点标签,让训练任务优先调度到已有镜像缓存的节点。
nodeSelector:
  gpu-cache: "true"
垃圾回收别太激进
节点上磁盘空间不足时,kubelet会回收未使用的镜像,如果回收策略过于激进,刚预热好的缓存层又没了,设置imageGCHighThresholdPercent和imageGCLowThresholdPercent时,给镜像缓存留出充足空间,一般建议高阈值85%、低阈值70%,并单独挂载一个较大的磁盘给容器存储目录。
基于分层缓存设计训练启动流程的具体步骤
想让加速效果持续可复制,建议按以下流程落地:
- 梳理镜像层稳定性:用
docker history查看每层创建指令,标记哪些是长期不变的基础层,哪些是频繁变动的业务层。 - 重构Dockerfile:把安装依赖、下载权重、配置环境等稳定操作放在前层,把代码COPY和动态生成内容放后层。
- 配置内部镜像仓库:用Harbor或Distribution搭建内网仓库,并开启镜像代理缓存,避免每次从外网拉取基础镜像。
- 预热节点缓存:编写脚本在业务低峰期批量拉取所有训练镜像,确保节点本地有完整分层。
- 监控缓存命中率:通过
docker system df查看回收可用的镜像缓存量,或者用cAdvisor监控容器存储层的读写延迟。
这套流程在多数中等规模的GPU集群上都能稳定生效,据行业观察,多数实施此方案的团队反馈,训练任务排队后的就绪时间缩短到原来的一半以内。
常见问题解答
容器镜像分层缓存会占用多少额外磁盘空间?
分层缓存本质是复用已有层,并不会额外复制数据,但多个镜像共享基础层时,磁盘占用远小于各镜像独立存储的总和,你可以用docker system df查看实际占用,其中Shared字段表示共享层大小,如果磁盘紧张,可以限制docker image prune但保留最近使用的层。
换一台新机器训练,缓存还有效吗?
新机器没有本地缓存,首次启动仍然会拉取完整镜像,这时需要依赖内网仓库的镜像加速和预拉取机制,建议将新节点纳入集群前,先执行一次批量拉取镜像的操作,或者用集群的DaemonSet完成自动预热。
如何判断训练启动慢是不是镜像分层导致的?
在节点上手动执行docker run --rm your-image echo hello,用time测量从命令发起容器退出的耗时,如果这个时间远低于实际训练任务就绪时间,那么瓶颈可能在数据加载或环境初始化,如果手动运行也很慢,说明镜像分层或存储驱动存在优化空间,注意观察拉取阶段耗时占比,可用docker pull计时单独验证。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/622774.html