蓝绿部署的核心价值在于,它让你能在零停机的前提下完成系统切换,一旦出问题可以秒级回滚,把故障影响面压缩到最小。这套策略说白了就是准备两套一模一样的环境,一套跑老版本,一套跑新版本,通过负载均衡或路由规则一键切换流量,它解决的不是“怎么把代码发上去”的问题,而是“怎么让变化发生得更安全”的问题,下面从原理、实操到踩坑,逐层拆开讲。
蓝绿部署的工作原理,为什么它能兜住风险
理解蓝绿部署,你可以把它想象成两家相邻的店面,老店(蓝色环境)还在正常营业,新店(绿色环境)在隔壁装修完毕,菜品、服务流程全部就绪,你想试试新店的服务,只需要把门口的路标(流量入口)指过去,顾客自然就分流了,如果发现新店上菜太慢或者菜品有问题,再把路标指回老店,顾客没有任何感知,生意照常做。
这套逻辑映射到技术架构里包含三个关键动作:
- 搭建绿色环境:准备好与当前生产环境(蓝色)配置一致的新环境。
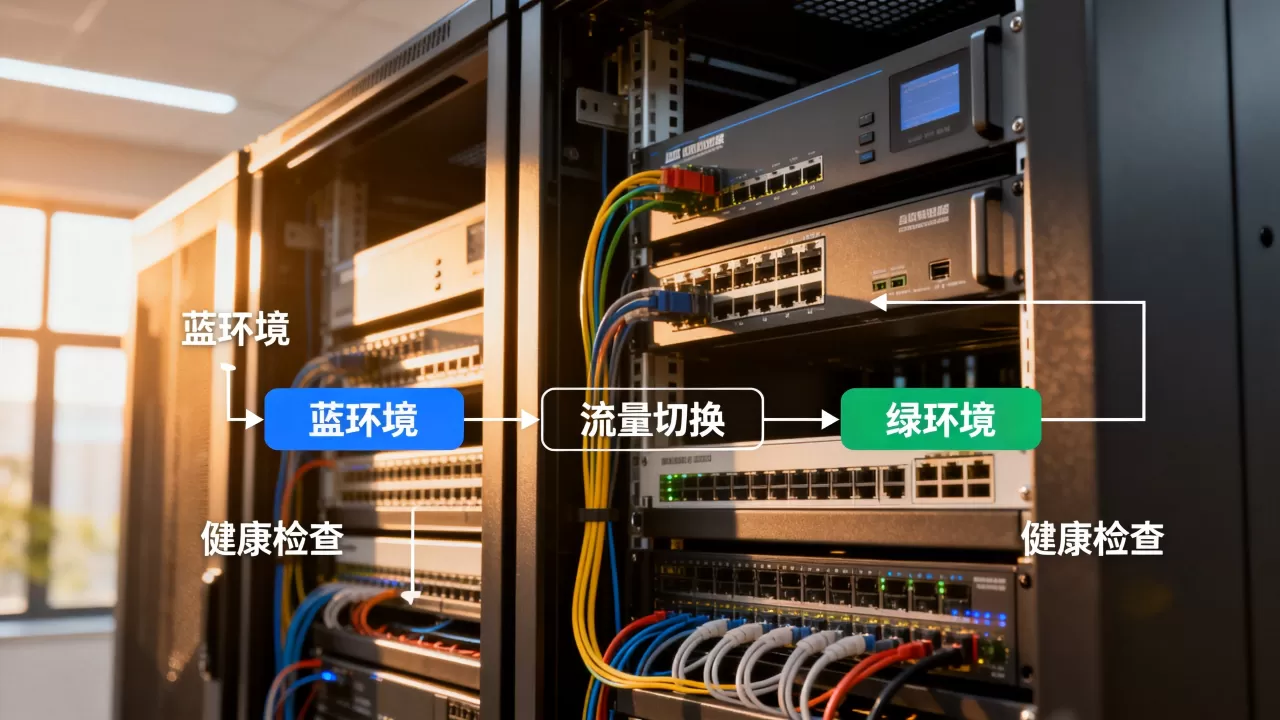
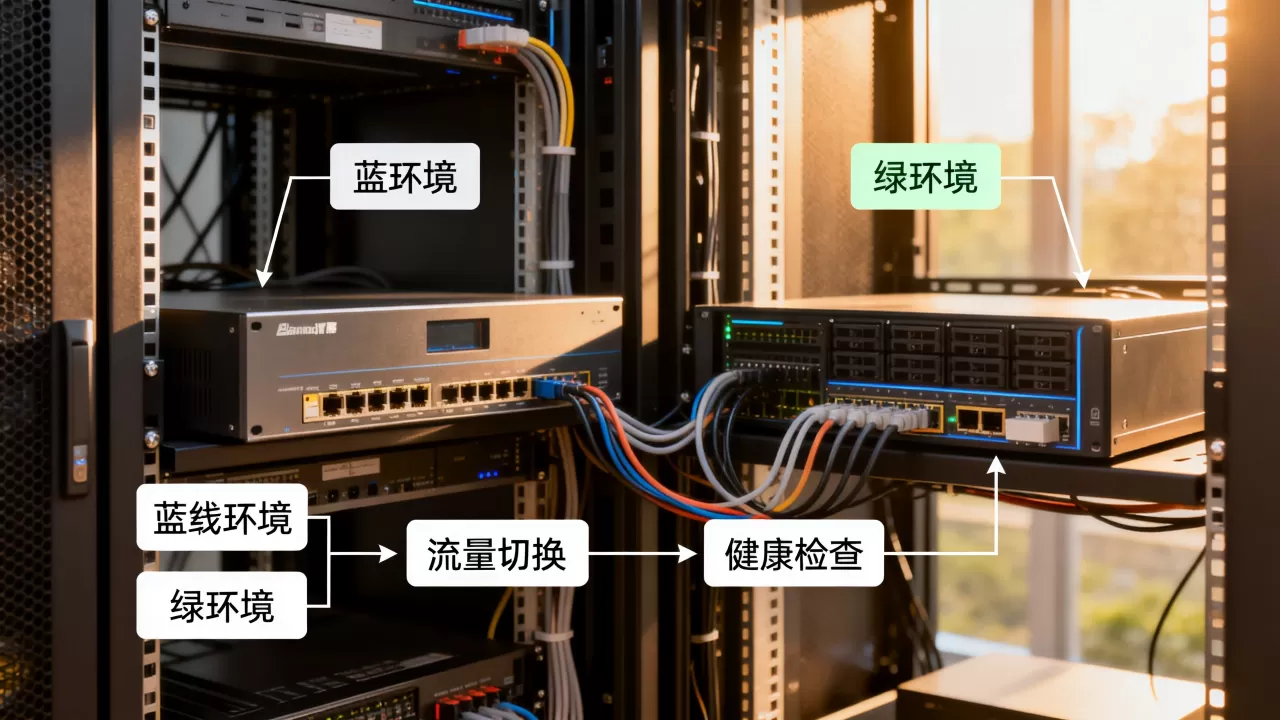
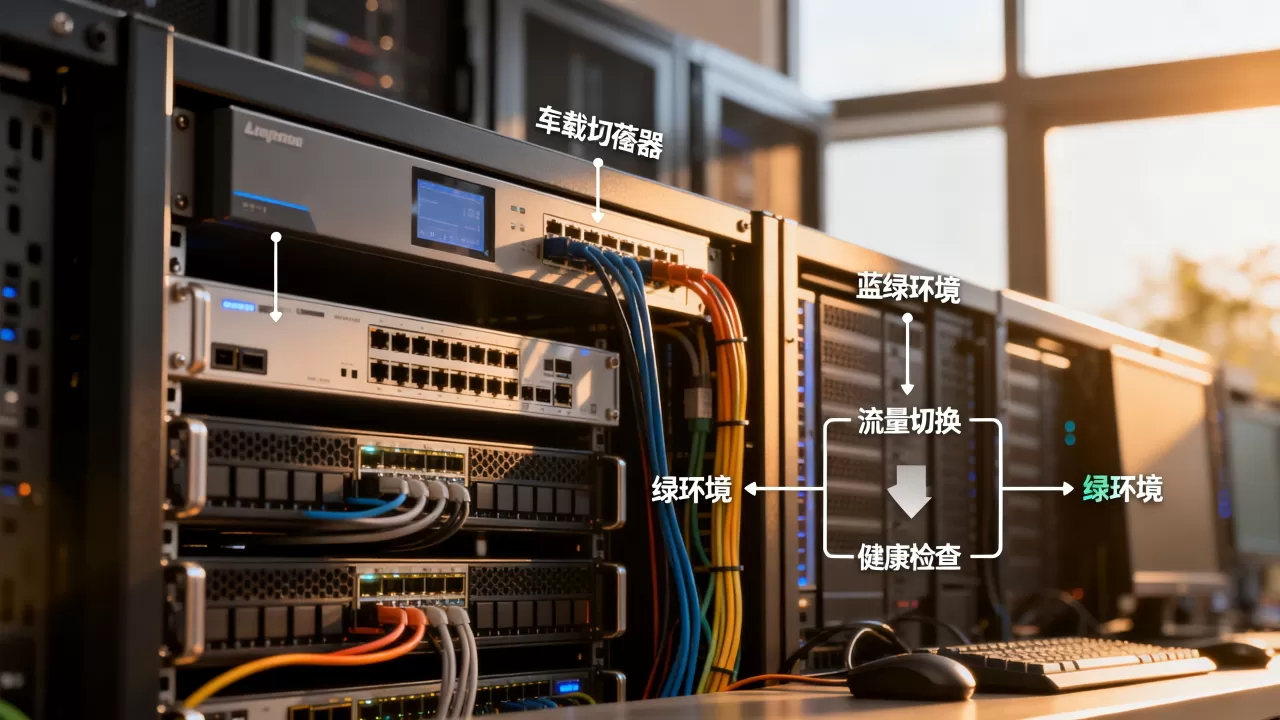
- 切换流量入口:通过负载均衡器或网关规则,把用户流量从蓝色环境整体切到绿色环境。
- 保留回滚退路:切换后,蓝色环境保持闲置状态,至少保留一段时间,确保问题出现时能随时切回去。
为何回滚速度是蓝绿方案的第一优势
传统发布方式,比如滚动更新,遇到事故时需要一条条回退代码,重启服务,验证依赖,整个流程走下来少则半小时,多则几小时,而蓝绿部署的回滚,本质上是改一次路由规则的操作,有经验的老运维会告诉你,DNS切换或负载均衡权重调整的耗时,通常在几分钟甚至几十秒内完成,这对于追求高可用的业务来说,价值是决定性的。
从零开始实施蓝绿部署,具体操作分四步走
如果你打算在项目中落地这套方案,下面这四条路径是绕不开的,不要一上来就追求复杂的自动化,先把流程跑通最重要。
第一步:梳理应用依赖与数据层一致性
很多人栽跟头就栽在数据上,蓝绿部署最怕的是,新版本改了表结构,切过去之后,老版本又需要回滚,结果数据已经写入新结构,导致老代码直接报错,处理这个问题有两条主流路线。
- 只做应用层切换:如果版本迭代不涉及数据库结构变更,这是最理想的状态,直接切换即可。
- 数据库双向同步:如果涉及结构变更,业内普遍采用的做法是,先让蓝色和绿色环境共享同一个数据库,或者用主从同步机制确保两侧数据一致,降低风险的办法是,把数据库变更拆分成向前兼容

的步骤:先加字段,再改代码,最后删旧字段。
第二步:配置负载均衡或网关路由规则
流量切换的开关通常放在流量入口处,无论你用的是Nginx、HAProxy,还是云厂商的SLB,原理都是一样的,以Nginx为例,核心配置就是定义两个upstream,然后用一个开关切换指向。
upstream blue_env {
    server 10.0.0.10:8080;
    server 10.0.0.11:8080;
}
upstream green_env {
    server 10.0.0.20:8080;
    server 10.0.0.21:8080;
}
# 切换时只需把下面的指向从blue_env改成green_env
server {
    listen 80;
    location / {
        proxy_pass http://green_env;
    }
}
如果使用Kubernetes环境,逻辑更简单,直接修改Service的selector标签指向新版本的Pod即可,切换动作本身,建议通过脚本或DevOps平台操作,这么做的好处是操作可审计且可追溯。
第三步:执行切换并观察核心指标
切换完成后,不要急着宣布成功,你需要盯着几个关键信号:
- 错误率:HTTP 5xx比例是否有明显爬升。
- 响应延迟:P95和P99耗时是否出现抖动。
- 业务成交量:订单量或请求量曲线是否和切换前保持平稳。
观察窗口建议拉长到10分钟到30分钟,因为很多问题不是瞬间爆发的,比如内存泄漏需要一点时间才会体现。
第四步:闲置环境处理与回滚演练
新环境稳定运行一段时间(比如24小时)之后,老的蓝色环境就可以释放或者降级为预发布环境了,平时,要刻意做一次回滚演练,验证路由切换的有效性,许多团队以为配置没问题,真遇到事故时才发现脚本里的后端IP写错了,这种低级错误在演习时暴露出来,总比在事故中暴露要好。
数据库迁移配合蓝绿部署,这是最大的难点
前面提到过,数据层处理不好,蓝绿部署就会变成“半蓝半绿”的尴尬状态,这里单独用一个章节详细说说,因为这部分是实践中让绝大多数团队头疼的地方。
扩展阶段:新旧结构并存
不要试图在一夜之间完成表结构的替换,行业共识认为,一次好的数据库迁移,应该是分阶段推进的,第一阶段,你可以直接在老表上新增一个允许为空的字段,此时两端代码都不依赖它,数据库表结构也兼容。
迁移阶段:读写分离与双写策略
当你的代码需要读取新字段或写入新字段时,采用双写策略降低风险:业务代码同时向新旧字段写入数据,但读取优先读新字段并校验,这是一个过渡态,目的是确认新字段的数据质量没问题,此时有经验的架构师会通过对比程序,定期校验新旧数据的一致性。
收敛阶段:灰度剔除旧逻辑
当新字段稳定运行并承载了所有数据读取后,代码层面就可以去掉双写逻辑,随后在下一个迭代中删除旧字段,这套动作跑完后,你会发现数据库的变更周期被拉长了,但变更的安全性呈几何级提升,想通过蓝绿部署降低风险,但不敢碰数据库迁移的团队,多半会让整体方案的价值大打折扣。
如果你正在为“数据库怎么配合蓝绿部署”发愁,可以记住一个简单原则:代码可以秒级回滚,但数据没法秒级回滚,所以数据变更必须前置于代码发布,且必须做到向前兼容。
蓝绿部署和灰度发布区别,到底该选谁
很多团队在选型时经常把这两者混为一谈,这里做一个直观的对比,看完你就知道该怎么选了。
| 对比维度 | 蓝绿部署 | 灰度发布 |
|---|---|---|
| 切换粒度 | 全量切换,要么蓝要么绿 | 按比例逐步放量,比如10%、50%、100% |
| 回滚速度 | 极快,改路由即回滚 | 相对快,调整权重即可 |
| 资源成本 | 需要两套完整环境,成本高 | 复用一套环境,成本较低 |
| 适用场景 | 核心业务、对停机极敏感的系统 | 功能迭代频繁、需要小流量验证的互联网应用 |
| 测试完整性 | 新环境可做完整全量测试 | 只能验证部分用户链路 |
场景选择:什么情况下无脑选蓝绿,什么情况下选灰度
- 高并发核心交易系统,比如支付网关、订单中心,这个场景适合蓝绿部署,这类系统不差钱,但绝对不允许长时间不可用。
- 用户端App或官网的UI改版,这个场景适合灰度发布,你应该希望先让5%的用户看看新版界面是否顺眼,收集反馈后再全量铺开。
- 依赖外部接口的复杂系统,可以考虑用蓝绿部署,因为新环境可以完整地调用一遍外部接口做联调,这种优势在灰度模式下很难实现。
有人会问,蓝绿部署适合什么场景?答案是当你对“确定性”要求高,且能接受双倍资源开销时,它天然就是为那些“不允许出岔子”的业务准备的。
蓝绿部署最常见的几个坑,以及怎么绕开它
在这套方案被大量团队采用的今天,你可能想不到,最常见的故障原因不是技术本身,而是“环境漂移”,所谓漂移,就是蓝色环境和绿色环境配置不一致,比如某台服务器漏更新了系统参数、依赖包版本不一致,导致切换后行为异常,解决这个问题,建议把环境配置全部基础设施即代码化,用Terraform或Ansible统一管理,确保两边环境是同一个模子刻出来的。
坑二:会话保持引发登录态丢失
如果你的应用有Session粘滞,或者使用了IP_HASH负载均衡策略,流量切换到新环境后,老用户的登录态可能失效,绕开的方法是,在切换前把Session存储迁移到Redis等集中式缓存中,避免Session滞留在单台或单环境的本地内存里。
坑三:消息队列积压与重复消费
蓝绿切换的瞬间,如果有消息生产者正在发送消息,可能出现消息丢失或重复投递,绕开的方法是,给消息记录一个幂等键,消费者在处理时先查重,既能保证数据落地,又不怕重复。
坑四:依赖外部回调地址发生变化
比如你的系统对接了微信支付或第三方开放平台,回调URL通常绑定在固定域名或IP上,切换蓝绿环境之前,如果忘了更新回调配置,支付结果就会回调到老环境里,造成业务数据不同步,这类问题的排查通常比较隐蔽,需要提前梳理一份外部依赖清单,切换后逐一确认。
Q&A:关于蓝绿部署切换风险的高频疑问
问:蓝绿部署的成本是不是很高?小公司玩得起吗?
要看你怎么理解成本,如果你所在的业务是给甲方做私有化部署,机器资源本来就紧张,再养一套空闲环境似乎有些浪费,但换个角度思考,一次线上重大事故造成的损失,往往会远超过那套闲置服务器的硬件开销,近年来国内中小企业上云比例持续提升,云上资源随时可以创建和销毁,你可以仅在发布的窗口期内拉起一套新环境,验证完再释放,这样成本就能有效压缩。
问:蓝绿部署能不能覆盖所有发布场景?哪些情况不适合用?
显然不能,对于微服务数量多达几十上百个的分布式系统,想给每个服务都准备一套蓝绿环境,复杂度会呈指数级上升,这种情况下,更适合把服务拆分成核心链路和非核心链路,只对核心链路的少数关键服务应用蓝绿部署,其余服务使用滚动更新或灰度发布。没有银弹,组合策略才是上策。
问:切换后如何确认新环境真的健康?只看监控就够了吗?
监控指标当然重要,但更可靠的手段是主动探测,切完之后,用脚本模拟真实用户的关键路径操作,比如登录、浏览、下单、支付,查看状态码和响应内容是否符合预期,这种主动拨测比被动看监控曲线要来得更直接,能更早地暴露问题,核心结论还是那句话:用蓝绿部署把风险提前关进笼子里,比事后亡羊补牢要高明得多,它也许不是最省钱的方案,却是关键时刻最保命的方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625922.html