先给结论
量化研究环境和生产交易环境必须彻底隔离,最稳妥的做法是物理分离研究用一台机器跑策略回测,交易用另一台机器下单执行,两套系统的账户、权限、网络完全独立,代码通过人工审查后单向流转。这个结论在行业里是共识,但真正落地时,很多人因为嫌麻烦走了弯路,最后在实盘阶段付出更大代价,下面把隔离规划的具体做法、常见坑和配套流程拆开讲透。
为什么必须把量化研究环境和生产交易环境隔离
不隔离的后果不是“可能出问题”,而是“必然出问题”,量化开发这件事有个特点:研究阶段充满试错,代码质量参差不齐,依赖库版本混乱,日志到处乱写,一跑起来各种警告刷屏,这些在生产环境里都是致命伤。
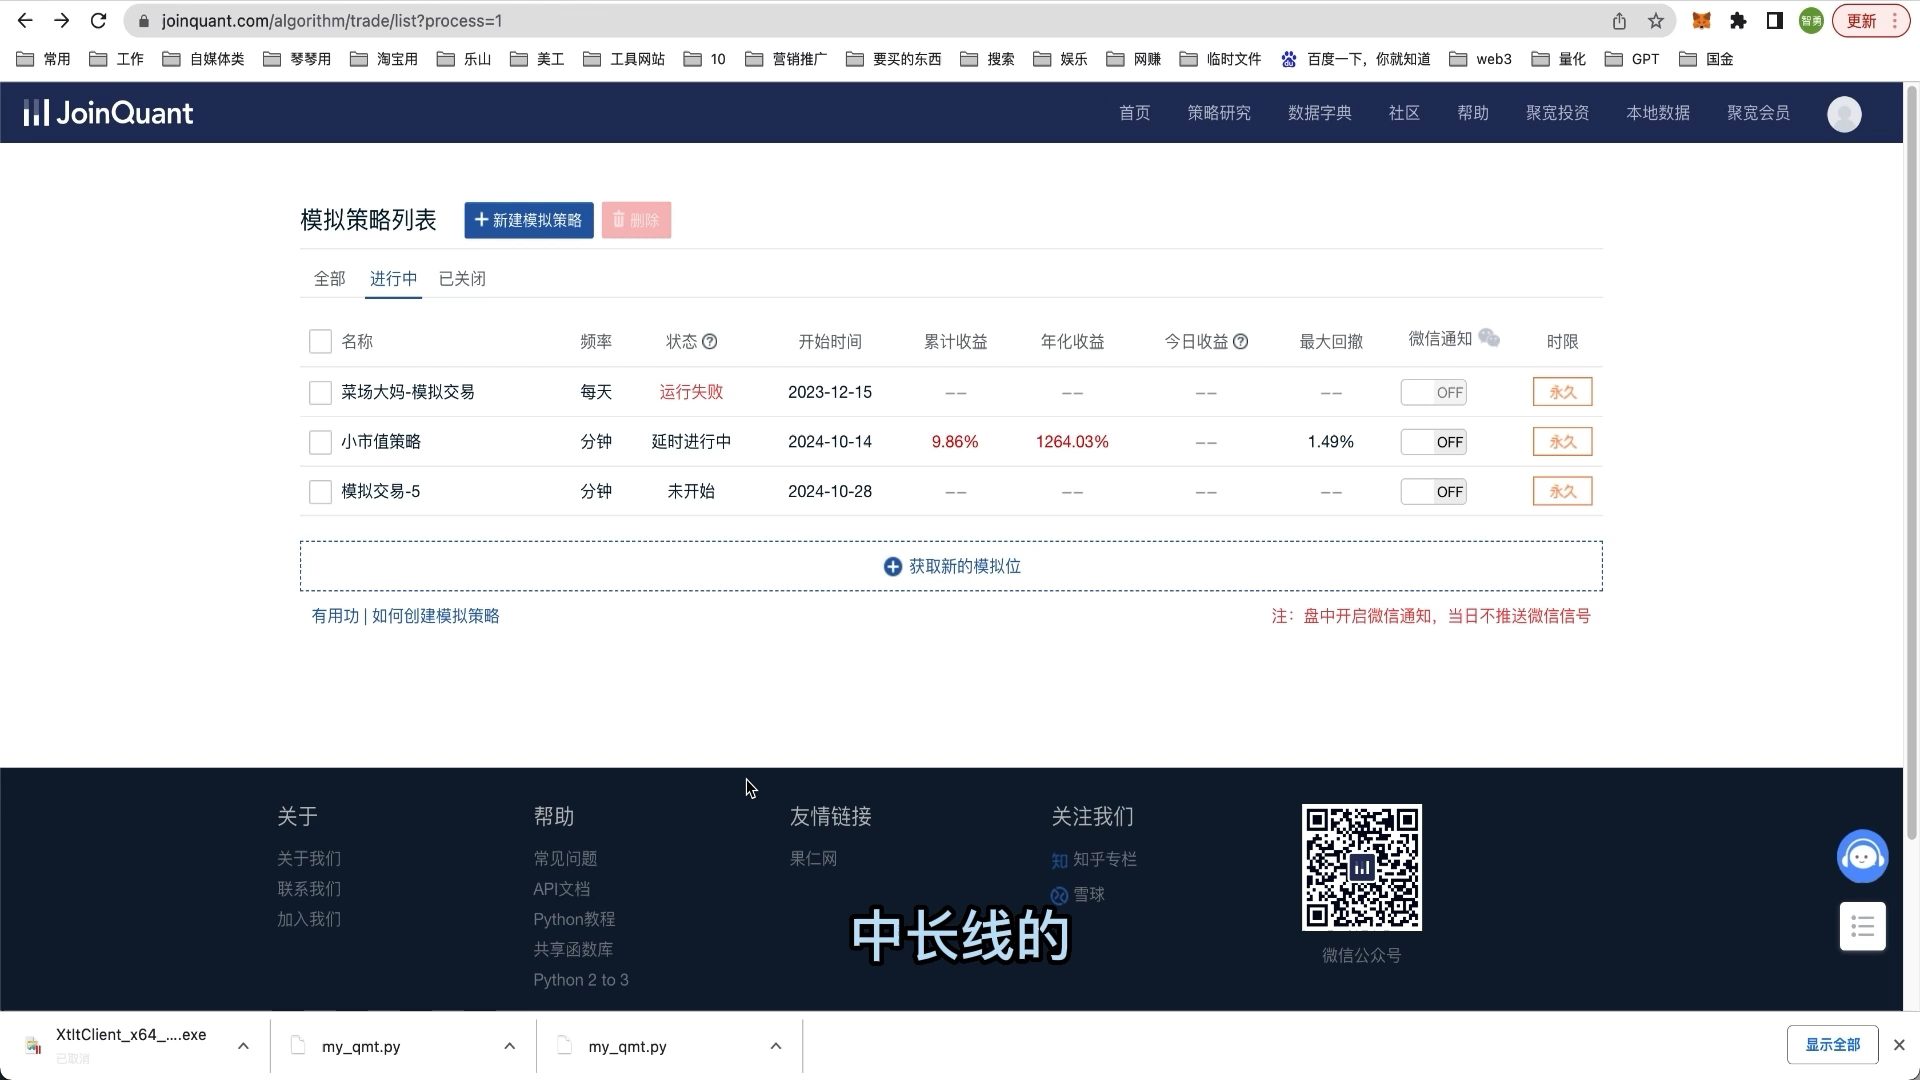

- 操作失误风险:研究时经常要改代码、重启进程、调试算法,一个不小心就会把正在跑的交易进程误杀。
- 系统稳定性冲突:回测任务极耗CPU和内存,量化开发机跑满的时候,交易下单的延迟会从毫秒级恶化到秒级,行情数据也可能堆积丢失。
- 环境依赖互相污染:研究环境里经常pip install各种新库,升级某个依赖可能会破坏交易程序正在使用的底层库兼容性。
据行业内部分享,相当一部分量化团队的实盘事故都发生在“研究环境和生产连在一起”的阶段,不是策略逻辑有问题,而是环境串扰导致的下单失败或重复执行。
量化研究环境与生产交易环境怎么隔离:九个维度逐一落地
隔离不是简单的“用两台电脑”,而是从操作系统用户、硬件资源、网络通信、数据流向等层面全面分开。
操作系统用户层面:最基础的隔离
直接创建两个不同的系统用户,量化开发机一个账号,生产交易机一个账号,两个账号的权限边界要清晰:
- 研究用户无法读取生产用户的交易配置文件和密钥
- 生产用户无法修改研究用户的代码目录
- 关键敏感文件设置权限,只有生产用户可读
具体操作上,生产交易用户建议设置为非sudo权限,任何需要root权限的操作都要经过审核后由专人执行。
机器层面:物理隔离优于逻辑隔离
如果预算充足,直接买两台服务器,一台专做策略研究和回测(以下称量化开发机),一台专跑实盘下单(以下称生产服务器)。
两台机器之间用网线直连或者通过一个受控网关通信,不通公网。
这样做的好处是单台机器坏了不影响另一端,跑回测时再大的资源占用也碰不到实盘进程一根汗毛,业内专家指出,这种物理隔离方案在所有隔离方案中是故障隔离效果最好的,量化交易服务器配置也多建议按这个思路来。
网络层面:通信路径要单一且可控
如果物理隔离做不到,至少要在同一台物理机上做虚拟化隔离,用Docker容器或虚拟机分别跑研究和交易环境,容器之间关闭默认网络,只暴露一个受控通信端口。
- 研究环境可以访问外网下载数据、更新依赖
- 生产环境禁止外网访问,只允许从研究容器单向推送代码和数据
数据层面:行情数据和研究数据分离
数据流向是隔离规划里最容易忽略的一环,许多团队把历史行情、因子库放在共享盘里,两边同时读写,结果回测时把生产正在用的数据文件改乱了。
正确做法是:数据文件分三种历史回测数据、实时行情缓存、策略参数配置,历史回测数据只允许研究环境挂载,实时行情缓存只允许生产环境写入,策略参数配置通过代码仓库管理,不走共享盘。
代码怎么从量化开发机安全地到生产服务器
隔离不是为了“老死不相往来”,而是为了让代码在受控条件下单向流转,这块需要一套落地的流程,行业里管这个叫“发布流程”。
代码仓库做中转站
研究环境里写好的策略代码,先提交到私有Git仓库,生产服务器只允许从Git仓库拉取代码,不接受任何其他形式的上传(比如U盘拷、邮件发、网盘传)。
生产服务器上做一个固定的部署目录,配合脚本实现一键拉取和重启:
- 研究者提交代码到特定分支,标记版本号
- 风控或负责人审查diff,确认没有夹带私货(比如临时调试代码、硬编码密钥)
- 在生产服务器上执行部署脚本,自动拉取对应分支
- 脚本校验代码完整性(对比提交哈希),然后重启交易进程
整个过程中,生产环境的代码目录对开发者是只读的,防止“顺手改一下”的冲动。
交易策略参数的单独管理
有很多团队把策略参数写死在代码里,这其实是隐患,参数一旦写进代码,每次改参都要走一遍发布流程,麻烦还容易出错,更合理的做法是参数放在独立配置文件里,生产环境单独保管一份副本,由风控角色负责更新。
- 代码负责逻辑
- 配置文件负责参数
- 每次更新参数都有审计记录
这样研究环境改了参数,只需要导出一份配置文件,由风控确认后放到生产机器对应目录,而不用重新发布整个策略代码。
研究环境要保留“接近实盘”的子环境
隔离规划做到后面,很多团队会遇到一个实际需求:回测跑得好好的策略,接到实盘上却因为撮合机制、滑点模型、手续费设置差异导致表现不一致,这个问题的根源在于研究环境和真实交易规则脱节。
所以合理的做法是在研究环境内部再划分出一个“仿真交易区”:
- 同一套策略代码,接实时行情,走模拟撮合
- 交易逻辑和生产完全一致,只是把订单路由到模拟账户
- 跑一到两周验证无异常后,再把同样版本的代码推向生产
这个仿真区虽然部署在研究机器上,但进程隔离、数据隔离,运行机制更像生产环境的“影子”,通过它可以在真正上实盘前发现交易接口兼容性、行情源连通性、主流程稳定性等隐藏问题。
量化开发机和生产机的配合方式:谁为主谁为辅
搞清楚了隔离结构,还要想明白两台机器的分工和配合节奏,量化开发机主要负责频繁迭代,生产服务器负责稳定执行,两者在时间上也有配合:
- 白天行情活跃时段,生产服务器专心跑交易信号,开发机可以跑日内的模拟盘验证
- 收盘后,生产服务器做每日数据备份,开发机跑整段历史回测和因子扫描
- 每周做一次生产环境的轧账,核对实际成交和模拟成交的偏差
这套节奏让两台机器各司其职,互不干扰,同时又能逐步积累实盘数据和模拟数据的对比记录,为后续策略迭代提供依据。
性能受限时退而求其次的方案
如果团队预算确实紧张,只有一台服务器,必须同时跑研究和交易,那至少采用容器级隔离加资源配额的方式,用Docker Compose分别定义研究容器和交易容器:
- 交易容器设置CPU亲和性和内存上限,确保任何情况下都不会被抢占资源
- 研究容器允许使用机器剩余算力,但设置最大内存阈值
- 两者的文件系统完全独立,共享目录只挂载一个专门的数据交换文件夹
这种做法隔离效果不如物理分离,但能保证核心的交易进程在多数情况下不受研究任务资源波动的影响,量化环境搭建时,建议优先考虑物理隔离,预算受限再选这个方案。
隔离规划的本质上是在为量化交易系统增加一道防线,防的不是别人,而是“手滑”的自己和“波动”的环境,安排两台机器、理清代码流转路径、明确数据读写归属,这些初期看似繁琐的工作,在实盘阶段都会默默挡掉大量麻烦,先隔离,再谈策略,这个顺序不能反。
关于量化研究生产环境隔离的常见疑问
量化研究环境和生产环境隔离后,回测数据和实盘行情可以共用一套接口吗?
不建议共用,回测使用的是历史落盘数据,实时行情是流式推送数据,数据格式、更新频率、写入模式差异很大,生产环境的行情接口应保持纯粹,只接收实时数据,避免回测程序的批量读取抢占I/O导致行情积压延迟,多数情况下,将两者接口分离是交易系统稳定性的基本保障。
用一台配置很高的服务器做虚拟化隔离够用吗?
在预算有限的前提下,单机虚拟化隔离优于不做隔离,但并非万无一失,虚拟化隔离能阻断文件系统互访和大部分操作干扰,但底层硬件资源仍是共用的,极端高负载时仍可能互相影响,如果想使用这类方案,务必为交易虚拟机设置CPU和内存的硬性配额,同时保持内核参数调优、系统防火墙配置独立,如果策略运行频率较高,行业共识仍更推荐两台物理机。
从量化开发机到生产服务器部署代码,最快的方式是什么?
通过Git仓库推拉是最受推荐的路径,但注意生产服务器端应是主动拉取,而不是开放端口给开发端推送,先在开发机上提交合并到发布分支,再到生产服务器执行预设的部署脚本,这个脚本会拉取代码、校验哈希、重启服务并记录版本号,流程走顺后一次部署耗时不超过一分钟,而且每个版本都有据可查,不建议使用rsync或scp直接传文件,那样绕过了版本管理,出了事故难定位。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/765168.html