设计稿多版本渲染的结果归档管理,不是把PNG、JPG、PDF塞进网盘就完事,核心是“一版一码一清单”:每个渲染输出绑定唯一版本号、渲染配置和源文件哈希,再用自动流水线写入对象存储和索引库。
设计稿多版本渲染结果怎么归档管理?先定版本模型
设计稿一旦进入多版本、多主题、多尺寸、多语言渲染,文件数量会快速膨胀,今天改间距,明天换品牌色,后天适配移动端,若只按“最终版”“最终版2”“最终版真的最终版”来存,后面根本找不到对应关系,所以第一步不是买工具,而是定版本模型。
设计稿多版本渲染和源文件归档有什么区别?对比着看更清楚
源文件归档管的是“设计过程”,渲染结果归档管的是“交付产物”,两者目标不同,字段也不同。
| 对比项 | 源文件归档 | 渲染结果归档 |
|---|---|---|
| 核心对象 | Sketch、Figma、PSD、XD等源稿 | PNG、JPG、WebP、PDF、SVG、视频帧 |
| 关键关系 | 谁改了什么 | 哪版源稿、哪套参数、哪次任务生成了它 |
| 常用工具 | Git LFS、设计协作平台历史版本 | 对象存储、CDN、渲染流水线、索引库 |
| 保留重点 | 可继续编辑 | 可追溯、可复用、可审计 |
| 常见错误 | 只存最新版 | 只存图片,不存配置和清单 |
行业共识认为,渲染配置和设计源必须绑定存放,否则同一个设计稿,用不同缩放、不同字体、不同色彩空间渲染,结果可能完全不同,你只存图片,等于把“为什么长这样”丢掉了。
版本模型要包含哪些字段
一个可用的渲染归档模型,至少包含这些字段:
design_id:设计稿唯一标识version:语义化版本,如v1.2.0render_profile:渲染配置名,如ios-dark-2xsource_hash:源文件或源稿快照的SHA-256config_hash:渲染参数、字体、插件的哈希output_hash:输出文件的哈希timestamp:渲染完成时间operator:触发人或触发任务approval:审核状态与审核记录storage_path:归档路径或对象存储URL
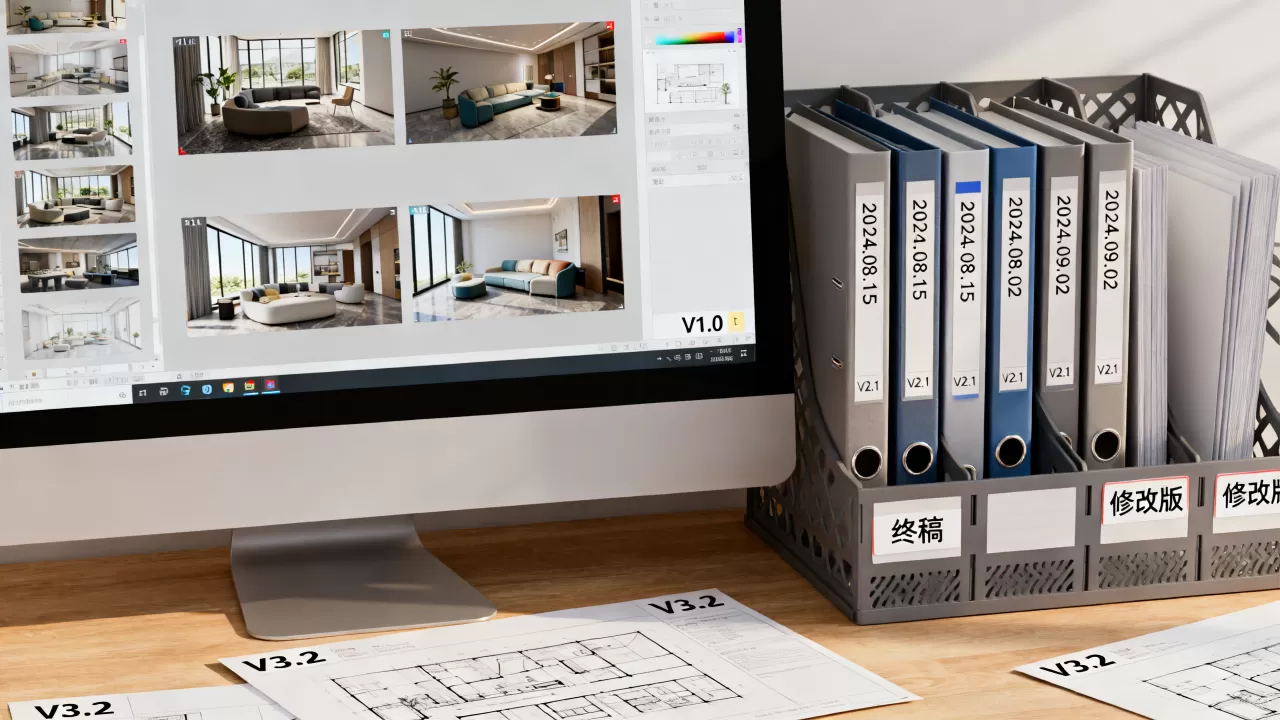
每个渲染版本至少保存源文件哈希、渲染配置哈希和输出哈希。 三个哈希齐全,才能回答“这个效果由哪一版设计稿、哪套参数、哪次任务生成”。
目录与命名如何设计
推荐按“项目设计稿版本配置输出”分层,示例路径:
/archive/{project}/{design_id}/{version}/{render_profile}/{output}
命名建议:
{project}-{page}-{version}-{profile}-{scale}-{locale}-{hash}.png
别小看命名,文件名里带版本、配置、哈希,后面做增量同步、去重、审计会轻松很多。
上海设计团队多版本渲染归档方案怎么落地?从目录到命令
地域团队往往跨办公室协作,上海总部、杭州分部、远程设计师同时改稿,网络盘一卡,版本就乱,落地时要把“人操作”变成“流水线操作”。
渲染流水线要产出哪些归档物
每次渲染任务完成后,至少产出五类文件:
- 渲染输出:主图、切图、多倍图、多语言版本
- 预览图:用于快速查看,不必长期保留最高清版本
- 清单文件:
manifest.json,记录版本、配置、哈希、路径 - 日志文件:渲染日志、错误日志、耗时记录
- 审计记录:谁触发的、关联需求单、审核结果
manifest.json可以长这样:
{
  "design_id": "home-banner",
  "version": "v1.2.0",
  "render_profile": "webp-dark-2x",
  "source_hash": "sha256:...",
  "config_hash": "sha256:...",
  "output_hash": "sha256:...",
  "timestamp": "2026-01-15T10:30:00Z",
  "operator": "ci-runner-03"
}
具体命令与操作路径
以下命令可按需改成团队脚本:
- 计算源文件哈希:
sha256sum design-v1.2.0.fig > source.sha256 - 计算输出哈希:
find render/ -type f -exec sha256sum {} + > outputs.sha256 - 同步到归档盘:
rsync -av --delete render/ /archive/project/design/version/
- 同步到对象存储:
aws s3 sync render/ s3://archive-bucket/project/design/version/ --storage-class STANDARD_IA - 给Git打标签:
git tag -a render-v1.2.0-webp-dark-2x -m "manifest: v1.2.0" - 大文件走LFS:
git lfs track ".psd"、git lfs track ".fig"
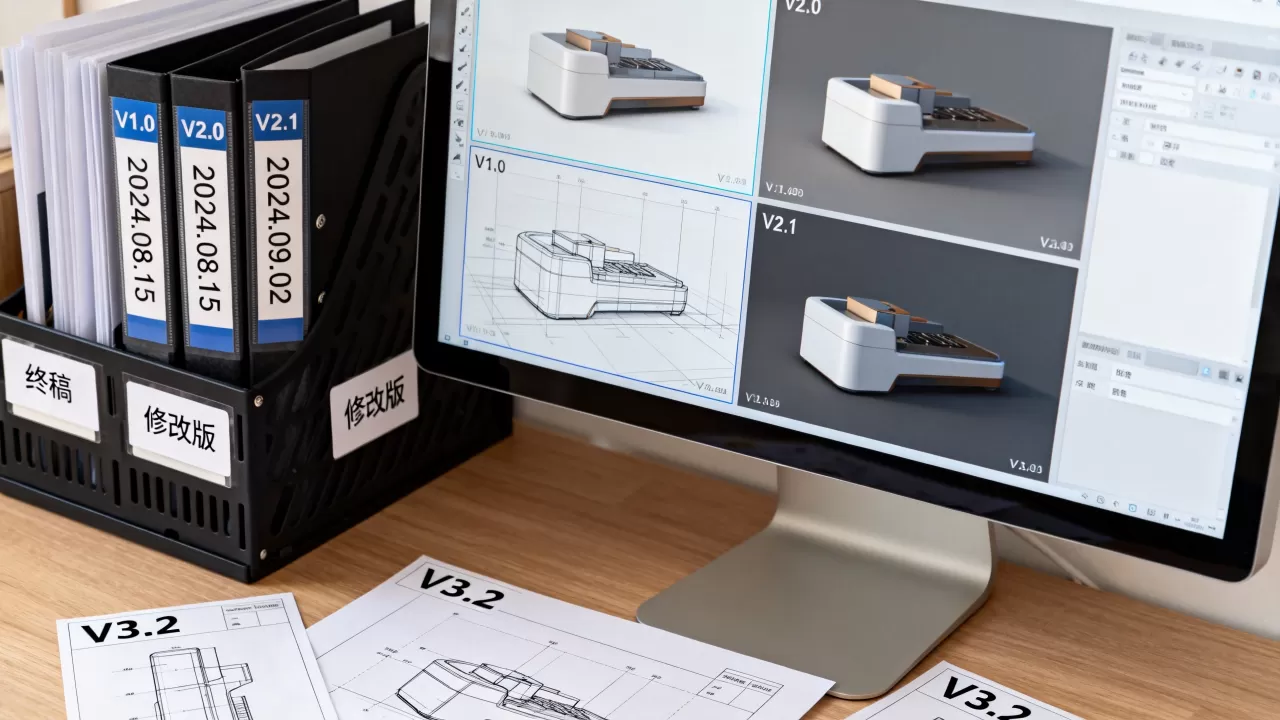
操作路径要固定,设计师只负责提交源稿和点“发起渲染”,后面哈希、清单、上传、索引交给CI,手工步骤越多,归档越不可信。
存储分层与保留策略
不是所有版本都要放热存储,可以按热度分层:
- 热数据:最近迭代版本,保留在对象存储标准层或高速NAS
- 温数据:已上线但可能回滚的版本,转低频存储
- 冷数据:结项归档,转归档存储或离线介质
- 过期数据:按合同和合规要求定期清理
热数据保留最近3到5个迭代版本,冷数据按项目周期封存。 这样既省成本,也不丢关键追溯能力。
设计稿多版本渲染归档要花多少钱?按存储、计算、人力拆分
价格问题不能只看网盘会员费,渲染归档的成本通常分三块。
成本构成
- 存储成本:原始源稿、多版本输出、预览图、日志、清单
- 计算成本:渲染任务、缩略图生成、哈希计算、索引更新
- 人力成本:搭建流水线、维护脚本、处理异常、审计合规
据工信部公开的软件业运行情况,企业侧数据存储与协作需求持续上升,多数情况下,存储单价在降,但文件数量和版本数量涨得更快。真正烧钱的不是单GB存储,而是混乱带来的重复渲染和人工找文件。
控制成本的做法
- 输出文件只保留必要格式,预览图用低码率WebP
- 相同哈希文件去重,避免同一张图存十遍
- 渲染配置版本化,不要每次手调参数
- 冷热分层,生命周期规则自动转储
- 日志和清单存数据库或轻量对象,不跟大图混放
价格区间受存储类型、渲染算力、合规要求影响,若团队只是内部看稿,轻量对象存储加脚本就能跑,若涉及金融、医疗、汽车等强审计场景,就要加权限、水印、操作留痕和长期归档。
在线协作场景下设计稿多版本渲染归档怎么落地?CI流水线要接上
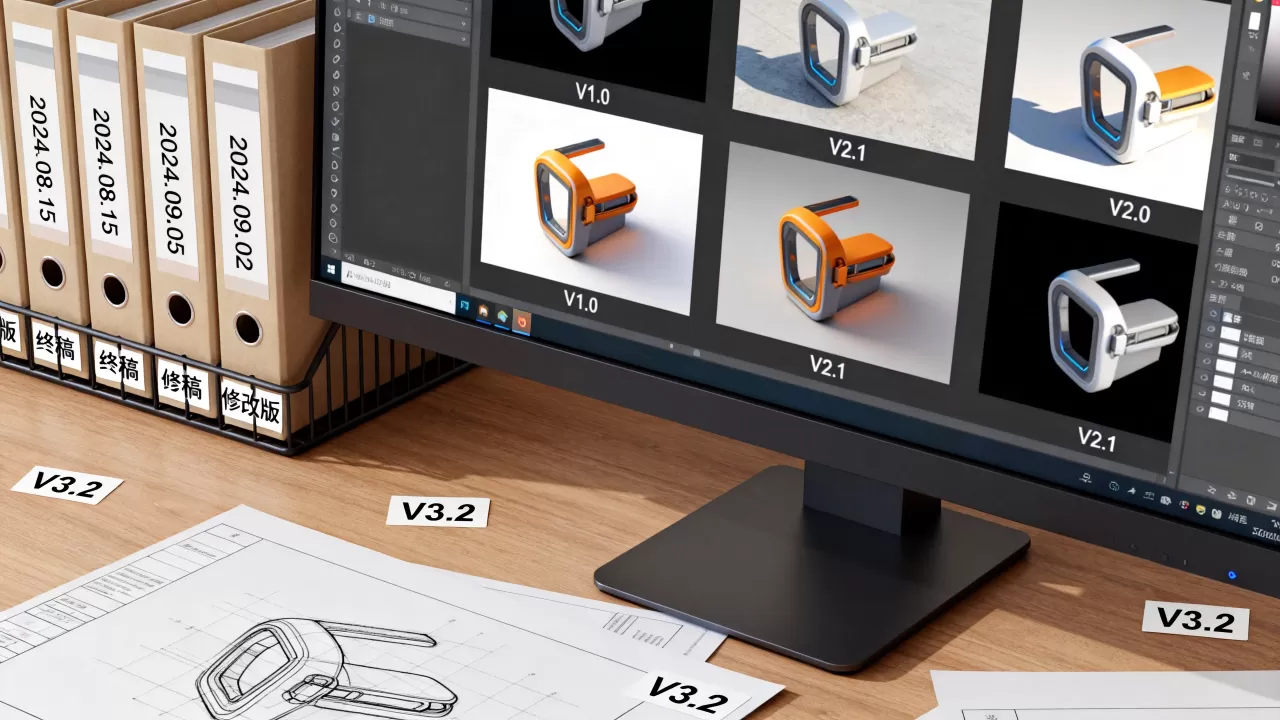
在线协作让改稿更快,也让版本更碎,今天A改按钮,明天B换字体,后天C导出十套语言,没有自动归档,三周后没人说得清线上图对应哪版设计。
在线协作的难点
- 多人同时编辑,版本号容易冲突
- 评论和审批散落在聊天记录里
- 渲染任务由不同人触发,参数不统一
- 外部供应商交付格式五花八门
业内专家指出,版本归档的核心不是存文件,而是存关系,关系包括源稿与渲染结果、配置与输出、审批与发布。
流水线步骤
可以按这个顺序接:
- 设计师在设计协作平台打版本标签,如
v1.2.0 - Webhook触发CI任务,拉取源稿快照
- CI读取
render.config.json,锁定字体、插件、缩放倍率 - 执行渲染,生成输出和
manifest.json - 计算哈希,上传对象存储,写入索引库
- 更新审批系统,通知相关角色
- 发布时只允许引用已归档且审批通过的版本
这样每次渲染都有唯一清单、唯一哈希和唯一责任记录,回滚时,按version + render_profile就能找回全套文件。
设计稿多版本渲染归档管理Q&A
设计稿多版本渲染结果怎么归档管理才可追溯?
先定版本模型,再上自动流水线,每个输出必须绑定源文件哈希、配置哈希、输出哈希、时间戳和操作人,目录按项目、设计稿、版本、配置分层,清单文件随输出一起存,只靠文件名和人工记录,追溯一定会断。
设计稿多版本渲染归档和普通网盘备份有什么区别?
普通网盘备份解决“文件还在不在”,渲染归档解决“这个文件由哪版设计稿、哪套参数、哪次任务生成,能不能回滚,能不能审计”,备份可以覆盖,归档不能随意覆盖,归档要有索引、有哈希、有保留策略,还要能按版本检索。
设计稿多版本渲染归档要花多少钱?
成本由存储、计算、人力三块组成,存储可以冷热分层,计算可以复用缓存,人力靠流水线减少手工操作,价格没有统一标准,取决于文件量、保留周期、合规要求和团队规模,一套可执行的归档系统,必须让每次渲染都有唯一清单、唯一哈希和唯一责任记录。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/697905.html