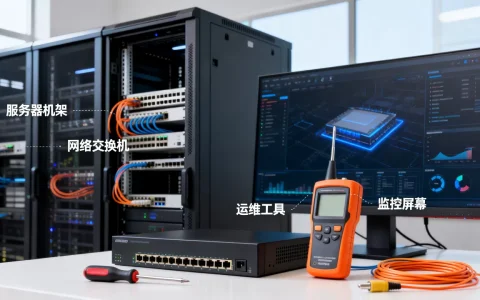
有效的服务器资源监控是通过实时采集CPU、内存、磁盘I/O及网络带宽等核心指标,并结合预设阈值实现故障预警与性能优化的闭环管理体系。
服务器资源监控的核心维度与指标体系
在构建监控体系时,首先需要明确“监控什么”,业内专家指出,盲目追求指标数量并不能提升系统稳定性,建立以业务可用性为导向的指标体系才是关键。
计算资源监控指标
计算资源是服务器的核心,监控时不能仅看CPU使用率,必须深入到更细分的维度。
- CPU使用率(Usage):分为用户态(user)和内核态(system),如果内核态占比过高,通常意味着系统调用过于频繁或驱动程序存在问题。
- 负载(Load Average):反映了等待CPU处理的任务队列长度,在多核环境下,负载值应参考核心数,例如在8核服务器上,负载达到8即代表资源趋于饱和。
- CPU Steal Time:在云环境下,该指标至关重要,它代表了物理机资源被其他虚拟机抢占的时间,如果该值持续走高,说明宿主机超卖严重,需要考虑迁移实例。
内存资源监控指标
内存问题往往比CPU问题更隐蔽,直接导致系统OOM(Out of Memory)崩溃。
- 可用内存(Available Memory):这是衡量内存压力最准确的指标,而非简单的“空闲内存(Free Memory)”,因为Linux会将部分内存用于缓存(Cache/Buffer),这部分在需要时可以快速释放。
- Swap使用率:当物理内存耗尽,系统开始频繁使用交换分区,会导致严重的磁盘I/O等待,进而引发系统响应缓慢。
- 内存页故障(Page Faults):高频率的缺页中断通常预示着程序存在内存泄漏或访问模式异常。
存储与网络监控指标
- 磁盘I/O利用率(%util):反映磁盘繁忙程度,如果I/O等待(iowait)时间过长,说明磁盘吞吐量已达瓶颈。
- 磁盘空间(Capacity):需监控根分区、日志分区及数据分区的剩余量,防止因日志撑爆磁盘导致的系统宕机。
- 网络带宽与丢包率:监控入站(Inbound)与出站(Outbound)流量,以及是否存在异常的丢包或重传,这直接影响业务的访问延迟。
服务器资源监控工具怎么选:从技术架构到业务场景
面对市场上琳琅满目的工具,选择逻辑应基于企业的规模、技术栈以及运维能力。
监控模式的对比
- 基于Agent(代理)模式:在目标服务器安装轻量级客户端(如Zabbix Agent、Node Exporter),优点是数据采集精度高、维度丰富;缺点是会占用极少量的系统资源,且在海量节点下部署成本较高。
- 基于Agentless(无代理)模式:通过SNMP、SSH或ICMP协议进行远程探测,优点是无需安装插件,对业务系统无侵入;缺点是采集深度有限,无法获取进程级的细粒度数据。

选型决策矩阵
根据不同的业务需求,可以参考以下逻辑进行决策:
- 初创团队/个人开发者:优先考虑云厂商自带的监控服务(如简米云CloudMonitor、AWS CloudWatch),虽然功能相对基础,但无需维护监控基础设施,运维成本极低。
- 中型企业/互联网项目:倾向于使用成熟的开源组合,如Prometheus配合Grafana,能够实现高度定制化的可视化看板。
- 大型金融/传统企业:由于对数据安全性及合规性要求极高,通常采用Zabbix或自研的监控平台,侧重于全网设备的统一管理与复杂的告警策略。
开源服务器监控系统对比:Prometheus、Zabbix与Netdata的实战差异
在开源领域,这三款工具代表了三种完全不同的设计哲学。
| 特性 | Prometheus | Zabbix | Netdata |
|---|---|---|---|
| 核心架构 | 时序数据库 (TSDB) + Pull模式 | 关系型数据库 (RDBMS) + Push/Pull | 实时流处理 + 本地采集 |
| 数据精度 | 秒级/分钟级 | 分钟级 | 毫秒级/秒级 |
| 适用场景 | 云原生、容器化(K8s)环境 | 传统数据中心、网络设备管理 | 实时性能调优、单机排查 |
| 学习曲线 | 较高(需掌握PromQL) | 中等(配置项极其丰富) | 极低(开箱即用) |
| 扩展性 | 极强,适合动态扩缩容 | 较强,适合大规模静态节点 | 较弱,侧重单机深度监控 |
Prometheus 的应用逻辑
Prometheus 的核心优势在于其强大的查询语言 PromQL 和对动态环境的适应能力,它通过 Exporter 模式抓取指标,非常适合 Kubernetes 等容器化环境,在处理微服务架构时,Prometheus 可以通过服务发现机制自动识别新上线的实例,实现自动化的监控覆盖。

Zabbix 的企业级优势
Zabbix 是一个功能极其完备的监控平台,它不仅能监控服务器,还能通过 SNMP 监控交换机、防火墙等网络设备,其强大的告警触发器(Trigger)逻辑,允许运维人员根据复杂的数学公式定义告警条件,“当CPU负载连续5分钟超过阈值且内存可用量低于10%时才触发告警”。
Netdata 的极致实时性
如果你需要进行深度的性能调优,Netdata 是不二之选,它能提供每秒甚至毫秒级的指标展示,能够捕捉到瞬时的性能抖动(Spike),在排查由于突发流量导致的短时系统卡顿问题时,Netdata 的高频采样能力能提供其他工具无法提供的细节。
云服务器CPU占用率过高怎么办:排查与优化实操指南
当监控系统发出告警,提示云服务器CPU使用率持续处于高位时,应遵循以下标准排查路径。
第一步:定位高负载进程
首先登录服务器,使用 top 或 htop 命令查看当前资源占用情况。
- 执行
top命令后,按下P键,系统将按CPU使用率从高到低排序。 - 观察
COMMAND列,确认是哪个进程(如java、nginx、mysql或某个异常脚本)占用了大量资源。 - 如果进程名是
[kworker]等内核线程,说明问题可能出在硬件中断或驱动层面。
第二步:分析进程行为
确定进程后,需进一步判断是计算密集型还是I/O密集型。
- 使用
pidstat -u 1查看特定进程的CPU利用率变化趋势。 - 如果发现 CPU 使用率很高,但
iowait(等待I/O的时间)也同步升高,说明该进程可能在进行频繁的磁盘读写或网络请求,导致CPU在等待数据返回。 - 使用
strace -p <PID>命令可以追踪进程的系统调用,查看其是否在进行大量的无效循环或异常的系统调用。
第三步:检查系统上下文切换
在高并发场景下,过多的上下文切换(Context Switch)会导致CPU消耗在任务切换而非实际计算上。
- 执行
vmstat 1命令,观察cs(Context Switch)这一列。 cs数值异常高(例如每秒达到数十万次),通常意味着线程过多或锁竞争严重,此时应考虑优化应用程序的线程池配置,减少线程数量或优化锁的粒度。
第四步:排查资源竞争与限制
在云环境下,还需检查是否存在资源限制。
- 检查是否触发了云厂商的 CPU Credit(积分)限制,部分低配实例在消耗完积分后,CPU性能会被大幅限制。
- 使用
df -h和iostat -x 1确认是否存在磁盘空间满或磁盘I/O达到上限的情况。

服务器资源监控方案价格分析
监控方案的成本构成并非单一的软件授权费,而是由多个维度组成的综合成本。
基础设施成本
- 自建方案:成本主要体现在用于部署监控系统的服务器硬件、存储空间以及由于数据高频采集带来的网络带宽消耗。
- SaaS方案:通常按被监控实例的数量(Per Instance)或数据量(Per GB)进行计费,这种方式省去了运维成本,但在规模扩大后,月度支出会呈线性增长。
人力与运维成本
业内共识认为,监控系统的维护成本往往高于其采购成本。
- 自建方案的人力投入:需要专业的运维工程师负责监控平台的升级、数据库调优、告警规则维护以及存储扩容。
- SaaS方案的隐形成本:虽然降低了运维压力,但由于数据存储在第三方平台,企业需要投入精力进行数据安全审计与合规性检查。
综合成本评估模型
在进行预算规划时,建议采用以下公式进行初步评估:
总成本 = (服务器/存储硬件成本 + 网络带宽成本) + (运维人员工时 × 维护频率) + (软件授权/订阅费用)
对于规模较小的企业,初期采用云厂商提供的基础监控服务是最具性价比的选择;而对于拥有大规模集群的互联网企业,构建基于 Prometheus 的自建监控体系虽然前期投入大,但长期来看,其边际成本更低且具备更高的灵活性。
服务器资源监控常见问题解答
监控指标的采集频率应该如何设置?
采集频率取决于业务对实时性的要求,核心业务服务器(如数据库、网关)建议设置在 5-10 秒一次;普通应用服务器可以设置为 30-60 秒一次;而对于非核心的开发测试环境,1-5 分钟一次即可满足需求,频率过高会增加监控系统本身的压力,频率过低则会导致无法捕捉到瞬时的性能波动。
监控系统本身挂了怎么办?
为了避免“监控盲区”,必须实现监控系统的自身监控,行业标准做法是采用高可用(HA)架构,例如通过 Prometheus 联邦集群(Federation)模式,或者使用多个独立的监控节点进行交叉检查,应配置独立的告警通道(如邮件、短信、钉钉/飞书机器人),确保在监控基础设施出现故障时,运维人员能第一时间收到通知。
监控数据的保留周期一般是多久?
数据存储通常遵循分层策略,实时指标(高精度)一般保留 7-15 天,用于日常故障排查;聚合后的指标(低精度)可以保留 3-6 个月,用于容量规划与趋势分析;历史趋势数据(极低精度)则可以保留 1 年以上,用于年度性能审计,根据统计,大多数企业会将 90% 的存储空间分配给最近 30 天的数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/494570.html