安卓大模型训练难吗?一篇讲透安卓大模型训练流程

安卓大模型训练的本质并非高不可攀的技术黑盒,而是数据准备、模型微调与端侧部署三个核心环节的有机串联。只要掌握了端侧硬件的物理限制与模型量化的底层逻辑,普通开发者完全有能力在安卓设备上实现大模型的落地与训练微调,这不需要昂贵的集群设备,核心在于精准的算法裁剪与高效的内存管理。

一篇讲透安卓大模型训练

打破认知壁垒:端侧训练的真实图景

很多人认为大模型训练必须依赖云端算力,这是一个误区,安卓大模型训练,或者说端侧微调,其核心目标是让模型适应特定用户的个性化需求,而非从零开始构建基础模型。这不仅是技术的进步,更是隐私保护的最佳实践,数据不出端,模型在本地迭代,这才是安卓大模型训练的真正价值所在。

环境搭建:构建高可用的训练基座

工欲善其事,必先利其器,在安卓设备上部署训练环境,首要解决的是算力与存储的适配问题。

  1. 硬件门槛界定:并非所有安卓手机都能胜任,设备必须支持神经网络API(NNAPI)或具备高性能的GPU/VPU,建议使用搭载高通骁龙8 Gen2及以上或天玑9200及以上芯片的设备,内存至少预留8GB空闲空间。
  2. 软件栈配置:推荐使用ML Kit或移植轻量级的PyTorch Mobile/TensorFlow Lite框架,这些框架针对ARM架构进行了深度优化,能够直接调用底层硬件加速器,避免算力浪费。
  3. 交叉编译环境:为了提升效率,建议在PC端配置交叉编译工具链,将复杂的模型转换和预处理在PC端完成,仅将计算密集型任务下发至安卓端。

数据工程:端侧训练的燃料

数据质量直接决定了模型的上限,在安卓端进行训练,数据处理必须遵循“轻量化”与“高纯度”原则。

  1. 数据清洗与脱敏:利用安卓系统的本地沙箱机制,对用户输入的文本、图像数据进行清洗,去除冗余噪声,保留核心特征向量。切记,本地训练的优势在于隐私,绝不可将原始数据上传云端。
  2. 数据增强策略:由于端侧数据量有限,必须采用数据增强技术,对于文本模型,可采用同义词替换、回译等方法;对于图像模型,利用随机裁剪、旋转、色彩抖动来扩充样本空间。
  3. 格式标准化:将处理后的数据转换为TFRecord或LiteRT格式,减少I/O开销,提升数据加载速度。

模型微调:LoRA技术的降维打击

一篇讲透安卓大模型训练

这是安卓大模型训练中最核心的技术环节,全量参数微调在移动端是不现实的,低秩适应技术是解决这一难题的“银弹”。

  1. 冻结主干参数:保持预训练大模型的权重不变,仅针对特定任务添加少量的适配器层,这极大地降低了显存占用,使得在手机上微调亿级参数模型成为可能。
  2. 秩的选择:在安卓设备上,建议将秩设置在4到16之间,过高的秩会增加计算负担,过低则无法捕捉特征,通过实验验证,秩为8时,在准确率与性能之间能取得最佳平衡。
  3. 梯度累积:移动设备的内存带宽有限,无法支持大Batch Size训练,采用梯度累积技术,模拟大Batch Size的效果,确保梯度下降方向的准确性。

量化压缩:突破内存瓶颈

模型大小是制约端侧训练的关键因素,量化技术通过降低参数精度,实现模型体积的指数级缩减。

  1. 训练后量化(PTQ):在模型训练完成后,将FP32(32位浮点数)权重转换为INT8(8位整数),这可以将模型体积缩小75%,且精度损失微乎其微。
  2. 量化感知训练(QAT):在微调过程中就引入量化噪声,使模型适应低精度环境。QAT能最大程度保证量化后的模型性能,是专业开发者的首选方案。
  3. 混合精度计算:关键层保留FP16精度,非关键层使用INT8,这种策略既保证了核心推理能力,又兼顾了推理速度。

部署与推理:验证训练成果

训练的最终目的是为了高效推理,安卓端部署需要解决碎片化系统带来的兼容性问题。

  1. 模型转换与优化:使用TensorFlow Lite Converter或ONNX Runtime将模型转换为.tflite或.onnx格式,开启默认优化选项,自动针对设备CPU/GPU进行算子融合。
  2. 委托机制:充分利用安卓的GPU Delegate和NNAPI Delegate,将计算任务分流给专用硬件,相比纯CPU执行,推理速度可提升5-10倍。
  3. 内存管理:实现模型的动态加载与卸载,在应用退至后台时,及时释放显存资源,避免系统杀进程,保证用户体验流畅。

通过上述五个维度的拆解,我们可以清晰地看到,安卓大模型训练并非遥不可及,只要遵循技术路径,利用好LoRA微调与量化压缩这两把利器,就能在方寸之间释放AI的巨大潜能。一篇讲透安卓大模型训练,没你想的复杂,关键在于打破思维定势,从端侧实际出发,寻找算法与算力的最优解。

相关问答

一篇讲透安卓大模型训练

问:安卓手机显存有限,训练大模型时出现OOM(内存溢出)怎么办?

答:解决OOM问题主要有三个策略,强制使用混合精度训练,将部分计算转为FP16,显存占用减半,采用梯度检查点技术,以计算换空间,不存储中间激活值,仅在反向传播时重新计算,优化Batch Size,将其设置为1并配合梯度累积,这是最直接的内存节省手段。

问:端侧训练出的模型效果不好,如何优化?

答:效果不佳通常源于数据分布偏差或过拟合,建议检查数据集的平衡性,确保各类样本比例适中,引入早停机制,当验证集损失不再下降时立即停止训练,防止过拟合,尝试调整LoRA的秩或学习率,微调超参数往往能带来意想不到的提升。

如果你在安卓大模型训练的实际操作中遇到过具体的报错或有独特的优化技巧,欢迎在评论区分享你的经验。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/125805.html

赞 (0)
Android动态壁纸怎么设置?精选高清动态壁纸下载
上一篇 2026年3月25日 13:33
安卓修改时间同步服务器地址怎么设置?IdeaHub Board设备安卓设置教程
下一篇 2026年3月25日 13:37

相关推荐

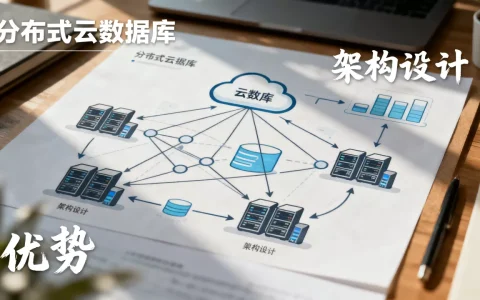
  • 分布式云数据库架构设计怎么做,有哪些优势?

    分布式云数据库架构设计的核心在于通过数据分片与多副本复制实现弹性扩展与高可用,选型时需优先根据业务场景权衡一致性与性能,分布式云数据库架构设计为什么被广泛采用传统数据库在数据量爆发时暴露扩展瓶颈,分布式云数据库通过水平拆分解决了单机限制,同时云原生基础设施降低了部署门槛,据工信部数据,近年来企业上云比例持续攀升……

    2026年7月25日
    600
  • chat大模型都有什么到底怎么样?真实体验聊聊,主流大模型对比评测及优缺点分析

    chat大模型都有什么到底怎么样?真实体验聊聊——结论先行:当前主流大模型已进入“多模态+强推理+低延迟”融合阶段,GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro、Qwen2.5-Max、GLM-4-Plus五款模型在中文场景中综合表现突出,实际部署中应按任务类型匹配模型,而非盲……

    云计算 2026年4月18日
    6400
  • 服务器在上速度慢为何网速如此不给力?揭秘服务器速度慢的真相!

    服务器响应速度慢的根源分析与专业优化方案核心问题回答:服务器响应速度慢通常由资源瓶颈(CPU、内存、I/O)、网络延迟、应用程序代码缺陷、数据库效率低下、配置不当或外部服务延迟引发,需通过系统化诊断工具定位瓶颈,针对性实施资源扩容、代码优化、数据库调优、网络加速及缓存策略,并建立持续监控机制,以下是详细解决方案……

    2026年2月6日
    16500
  • 大模型微调显存占用值得关注吗?微调显存不够怎么办

    大模型微调显存占用绝对值得关注,它直接决定了你的训练任务能否启动以及训练成本的高低,显存占用并非单一的数字堆砌,而是模型参数量、训练精度、优化器状态以及批次大小等多因素共同作用的结果,对于开发者而言,深入理解显存占用机制,是突破算力瓶颈、实现低成本高效微调的关键,核心结论:显存占用是微调工程的“生死线”,优化显……

    2026年3月21日
    13200
  • cdn和带宽的区别是什么,cdn与带宽的区别

    CDN(内容分发网络)与带宽的核心区别在于:带宽是数据传输的“管道容量”,决定你能装多少水;而CDN是分布式的“供水站网络”,决定水能否快速、稳定地送到用户手中,两者是互补而非替代关系,在2026年的数字化基础设施语境下,许多企业仍混淆这两个概念,导致在云资源采购中陷入“带宽瓶颈”或“CDN无效”的误区,理解这……

    2026年5月14日
    6700
  • 不同域名扩展名对GEO和网站可信度影响大吗,域名后缀对GEO影响大吗?

    域名后缀本身不直接决定百度排名高低,但不同扩展名会显著影响用户的信任偏好和点击意愿,间接左右SEO效果,对于大多数企业站和品牌站,.com仍是首选,而新顶级域在特定场景下有独特优势,域名后缀在百度搜索算法中的真实权重百度官方从未暗示过某些域名后缀拥有更高排名权重, 在搜索引擎排名规则上,域名扩展名并不属于核心评……

    2026年10月19日
    400
  • 大模型相关后端开发好用吗?大模型后端开发岗位怎么样

    经过半年的深度实践,大模型相关后端开发显著提升了开发效率,但并未达到“完全替代人工”的程度,其核心价值在于将重复性劳动自动化,同时引入了新的技术挑战,大模型在后端开发中的应用,本质上是一次生产力的重构,而非简单的工具叠加,它极大地降低了常规业务逻辑的实现门槛,却对架构设计和系统稳定性提出了更高的要求,对于这一技……

    2026年3月22日
    12900
  • 服务器app压力测试怎么做?Hadoop压力测试工具如何获取?

    Hadoop压力测试工具获取渠道全梳理很多刚接触大数据压测的朋友,第一反应是去百度搜“Hadoop压力测试工具在哪里下载”,结果翻了几页全是过时的教程或者捆绑安装包,Hadoop压测工具的获取比想象中简单,关键在于分清你要测的是底层存储还是上层业务接口,Hadoop生态自带工具:开箱即用,零成本获取Hadoop……

    2026年8月12日
    900
  • 服务器安装网卡驱动失败怎么办?服务器网卡驱动装不上怎么解决

    2026年服务器安装网卡驱动的核心准则是:优先通过带外管理接口加载厂商认证驱动,结合固件层PXE与操作系统层离线包双轨部署,彻底规避硬件兼容性冲突与内核版本不匹配导致的宕机风险,驱动安装前置洞察与规范基线行业痛点与2026年最新数据服务器网络中断与数据丢包,超60%源于驱动未认证或版本错配,据【中国信通院】20……

    2026年4月24日
    5600
  • 动静分离cdn是什么,动静分离cdn加速原理

    动静分离CDN通过智能识别请求类型,将静态资源与动态API请求分流至不同节点,在2026年已成为降低网站延迟、提升并发处理能力的标准架构方案,其核心优势在于实现毫秒级响应与成本优化的双重平衡,技术原理与核心机制解析智能路由与协议优化动静分离并非简单的文件分类,而是基于深度包检测(DPI)与用户行为画像的智能调度……

    2026年7月4日
    13310

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注