容器镜像频繁更新时,想要做到版本可追溯和可回退,核心做法是把镜像的不可变标签与可变标签分开管理,并配合一套强制要求的版本记录和回退演练流程。本文直接给出可落地的方案,从镜像命名规范、仓库策略、部署工具链到回退操作,一步步讲清楚。
为什么镜像天天更新反而容易“找不到北”
很多团队遇到的情况是:开发一天打好几个tag,线上部署用的是 latest,或者随便拉个“昨天能跑”的镜像,这本质上是把镜像的可变性当成了版本的可追溯性,容器镜像本身是分层的不可变文件,但 tag 是可以被覆盖的,一旦同一个 tag 指向了新的镜像,旧内容就失去了引用,回退时自然找不到。

行业共识认为,镜像版本追溯的根本问题不是存储,而是命名与流转策略的失控,只要 tag 可以随意被覆盖、镜像没有完整的元数据记录,再多的镜像仓库容量也救不了回退需求。
可变 tag 的典型翻车场景
- 凌晨上线后发现问题,想回退到昨天的镜像,但昨天用的是
app:latest,今天构建时已经在同一 tag 下覆盖了旧镜像,旧镜像被仓库GC清理。 - 镜像带上了
python3.11这样的环境 tag,但环境 tag 是为了匹配运行时,不能代表代码版本,回退时按这个 tag 拉取,拿到的可能是完全不同的代码。 - 多个环境共用一套 tag,
dev、staging、prod都指向同一个app:2.3.1,但开发环境的热更新覆盖了 tag,生产环境受影响。
这些场景的共性在于,团队没有把“镜像身份”和“部署时的引用方式”分开,想解决,就要把 tag 的不可变性作为铁律。
镜像版本可追溯的第一步:强制不可变标签
不可变标签的意思很简单:一个 tag 只指向一个镜像摘要,一旦推送,永远不允许覆盖,这需要在镜像仓库端做硬性限制,而不是靠自觉。
具体规则和推荐格式
建议使用 GIT 提交哈希 + 构建序号 的组合作为不可变标签。
registry.example.com/app/order-service:1.4.2-abc123f4.2是语义化版本,表示业务功能版本abc123f是 GIT 短哈希,精确对应源码提交- 两者组合保证唯一性,即使同一个版本号修复了代码,哈希也会变化
同时废弃 latest 作为部署引用,如果非要保留 latest 给开发本地用,必须在仓库设置中禁止生产环境拉取 latest,多数情况下,这是比镜像签名更优先要做的防呆措施。
镜像仓库端的保护配置
- 在 Harbor 中启用“不可变tag”规则,选择项目并按仓库名称匹配,设置 标签禁止覆盖
- 在 GitLab Container Registry 中,通过 CI/CD 的检查步骤,在推送前校验 tag 是否已存在
- 使用 OCI 分发规范中的 referrers API 记录镜像签名和来源信息,确保镜像内容可验证
这一阶段做完,镜像就有了“身份证”,但只有身份证还不够,还需要记录“身份证什么时候发给了谁”。
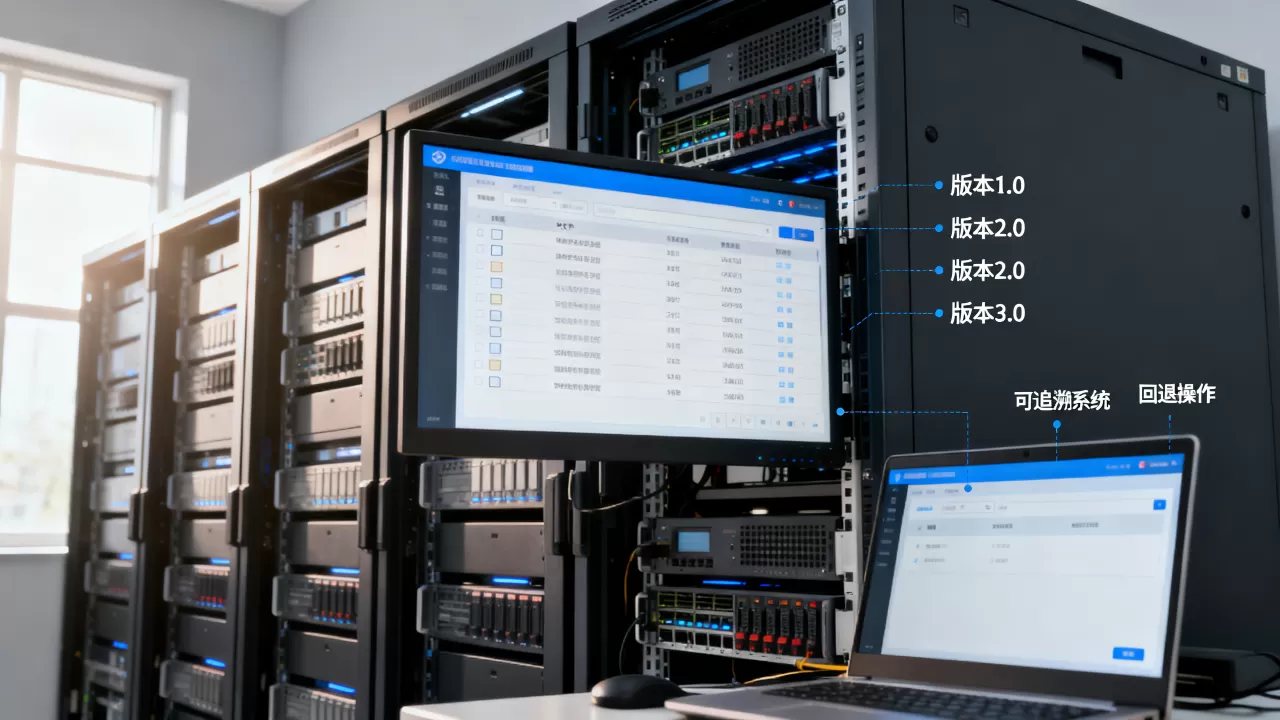
镜像更新记录与元数据管理:让每次变更都有据可查
版本可追溯不等于每个 tag 都能查到代码,而是需要查到这个镜像包含了哪些代码、构建自哪个仓库、何时由谁触发,这些信息需要写入镜像的 label 或 OCI annotations。
在 Dockerfile 或构建阶段注入元数据
在构建时通过 LABEL 或 BuildKit 的 --label 参数写入:
LABEL org.opencontainers.image.source="https://github.com/example/order-service"
LABEL org.opencontainers.image.revision="abc123f"
LABEL org.opencontainers.image.created="2026-03-14T08:30:00Z"
LABEL org.opencontainers.image.version="1.4.2"
LABEL team="backend-order"
利用 BuildKit 的 --metadata-file 参数,还能把构建时间和依赖版本一并导出,这些标签在镜像被拉取后,通过 docker inspect 或 crane manifest 可以随时查看。
统一记录更新日志与镜像的对应关系
行业内的成熟做法是,在 CI/CD 流水线中,将每次推送的镜像摘要、tag、GIT 提交信息、构建日志地址自动写入一个版本清单(可以是简单的 Markdown 文件,也可以是数据库表),例如每次构建后生成如下记录:
| 时间 | 服务 | 不可变 tag | 镜像摘要 | 代码提交 | |
|---|---|---|---|---|---|
| 2026-03-14 10:21 | order-service | 4.2-abc123f | sha256:9f2… | abc123f | 修复超时重试逻辑 |
| 2026-03-14 15:47 | order-service | 4.3-def456a | sha256:8a1… | def456a | 新增库存校验接口 |
这个清单最好由流水线自动追加,不依赖人工填写,这样回溯时只需查表,就能知道某个环境当时部署的是哪个摘要。
通过摘要(digest)作为最终依据
tag 可能被误操作覆盖,但镜像摘要不会被修改,在部署清单(K8s YAML 或 Helm values)中,建议直接引用 digest 而不是 tag:
image: registry.example.com/app/order-service@sha256:9f2...
虽然可读性不如 tag,但可追溯性最强,日常操作中,用不可变 tag 作为人类可读的入口,用 digest 作为系统实际部署的出口。
镜像频繁更新时怎么设计回退策略:多环境联动与自动回退
回退不是保留几个旧镜像就完了,频繁更新意味着变更窗口小、回退频率高,必须建立一套从仓库到运行时的完整策略。
回退的三种常用策略对比
| 策略 | 适用场景 | 操作速度 | 风险 |
|---|---|---|---|
| 重新部署旧镜像 | 功能性问题,代码逻辑需回退 | 中等(需重新拉取镜像) | 较低 |
| 利用 K8s 滚动更新的历史版本 | 仅需回退本次更新 | 较快(kubectl rollout undo) | 低,依赖 Deployment 记录 |
| 蓝绿或金丝雀切流 | 变更影响面大,需快速恢复 | 最快(切换流量) | 中,需额外资源 |
对于镜像频繁更新的业务,推荐 K8s 滚动更新历史记录 + 旧镜像保留双保险,具体操作路径:
- 部署时使用
kubectl set image deployment/order-service order-service=registry.example.com/app/order-service:1.4.2-abc123f - 回退时执行
kubectl rollout undo deployment/order-service,如果使用 Helm,执行helm rollback order-service <版本号> - 同时确保镜像仓库保留至少最近 20 个不可变 tag 或 30 天 的镜像,通过仓库的保留策略自动清理
自动回退判据与人工干预边界
频繁更新往往意味着某个指标有异常,建立自动回退机制时,核心要看部署后的错误率变化,服务在更新后 5 分钟内,HTTP 500 比例超过基线 2 倍,则自动触发回退,但在回退前,需要先确认是代码问题还是配置问题,否则回退后同样会失败。
多数情况下,自动化回退只适用于检测明确的异常信号,业务逻辑错误很难量化,建议将自动化回退范围限定在 启动失败、CPU/内存飙升、请求错误率骤增 三类场景,其余情况由值班人员根据版本清单手动选择回退目标。
实操中的回退检查清单
- 确认目标镜像还存在:在仓库中查看不可变 tag 或 digest
- 确认目标镜像的依赖(如数据库 schema)是否与当前兼容
- 查看回退目标在历史版本清单中的变更记录
- 回退后保持旧 Deployment 的 ReplicaSet 保留,便于再次回退
镜像更新频繁时如何保证全链路可追溯:从源代码到运行实例
版本可追溯的最高标准是:给定一个运行中的容器,能反查它的镜像、代码、构建参数、部署时间和操作人,这需要串联四个环节。
四个环节的关联方式
- 源码阶段:GIT 提交哈希写入镜像 label
- 构建阶段:CI 流水线记录构建日志与镜像摘要
- 部署阶段:K8s 或编排系统记录 Deployment 版本与镜像引用
- 运行阶段:通过容器运行时元数据关联 Pod 与镜像 digest
当线上出现一个行为异常的 Pod,我们执行:
kubectl get pod frontend-x8s9d -o jsonpath='{.spec.containers[0].image}'拿到完整镜像引用后,通过 crane digest 和 crane config 查看镜像的 label 和创建时间,再回到 GIT 提交记录确认代码范围,全过程不超过 5 分钟。
利用 OCI 工件和签名增强可信度
如果业务对安全要求较高,可以为镜像签名并推送签名文件到仓库,验证环境在拉取镜像前强制校验签名,确保历史镜像没有被篡改,这在金融、政务场景中较为常见,但中小团队不必一上来就做全套,先做好 tag 不可变和版本清单就能解决 80% 的追溯问题。
版本回退与镜像仓库清理策略的平衡
镜像越多,存储成本越高,但如果清理策略不当,回退能力会直接失效,频繁更新的团队需要一种兼顾两者的做法。
按业务重要程度分级保留
- 核心服务:保留最近

60 天
所有不可变 tag,同时保留历史 K8s Deployment 记录 - 一般服务:保留最近 30 天 的 tag,支持近三次回退
- 临时或实验服务:保留最近 7 天,回退不保证
在 Harbor 或 Nexus 中设置清理任务时,使用 最近更新镜像数 + 保留天数 的组合规则,清理前确认版本清单中记录的已部署 digest,原则上已部署的镜像永不清理,除非确认环境已下线。
回退测试建议
回退方案不能只在文档里,每隔一个季度,选一个低峰时段,在测试环境执行一次完整回退演练:修改代码构建新镜像部署触发条件回退到旧镜像验证数据一致性,这样能把回退流程中的疏漏提前暴露出来,避免生产事故时手忙脚乱。
容器镜像回退失败的常见原因与排查路径
即使方案完备,回退失败仍然可能发生,以下是根据运维实践整理的高频原因。
- 数据库不兼容:新代码跑过 migration 后,旧代码无法读取新的 schema,排查方法:查看回退前执行的迁移脚本,确认是否需要手动回滚数据库。
- 依赖服务不兼容:旧镜像连接的中间件版本或接口已被更新,排查方法:检查回退时环境变量指向的下游服务版本是否匹配。
- 镜像仓库策略导致镜像被删:例如清理任务误删了回退目标,排查方法:查看仓库的垃圾回收日志,或从异地备份恢复。
- kubectl rollout undo 后镜像没变:可能因为 Deployment 模板中没有实际改变镜像引用,或者 Helm chart 的 values 被手动覆盖,排查方法:检查 ReplicaSet 历史列表,确认旧版本对应的镜像 digest。
关于镜像版本回退的常见问题解答
镜像 tag 和 digest 有什么区别?回退时应该用哪一个?
tag 是人类可读的别名,可以被覆盖;digest 是镜像内容哈希,唯一且不可变,回退时优先使用 digest 作为部署引用,tag 作为查询入口,如果图形化界面只支持 tag,那么必须确认该 tag 未被覆盖。
用 latest 作为生产镜像 tag 就一定不能追溯吗?
不是绝对不能,但极不推荐。latest 本身没有版本语义,更新后无法直接回退,如果团队坚持使用,必须在构建时把旧 tag 保留为带日期的 tag,并在部署记录里写明实际 digest,但这只是补救,不是可追溯的稳妥做法。
小团队没有独立镜像仓库,只用 Docker Hub,能实现回退吗?
能,但限制较多,Docker Hub 的私有仓库支持多个 tag,但不允许设置不可变 tag 规则,小团队可以在 CI 中强制使用 GIT 哈希作为 tag,并维护一份包含 digest 的部署记录,回退时通过 digest 直接拉取,注意 Docker Hub 有免费额度限制,过于频繁的推送可能触发速率限制,可以考虑迁移到自建 Harbor 或云厂商的镜像仓库服务。
容器镜像频繁更新下的可追溯与回退,最终靠的是不可变标签打底、版本清单记录、部署引用摘要、定期演练验证,把这四件事做完,再频繁的更新也乱不了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639321.html