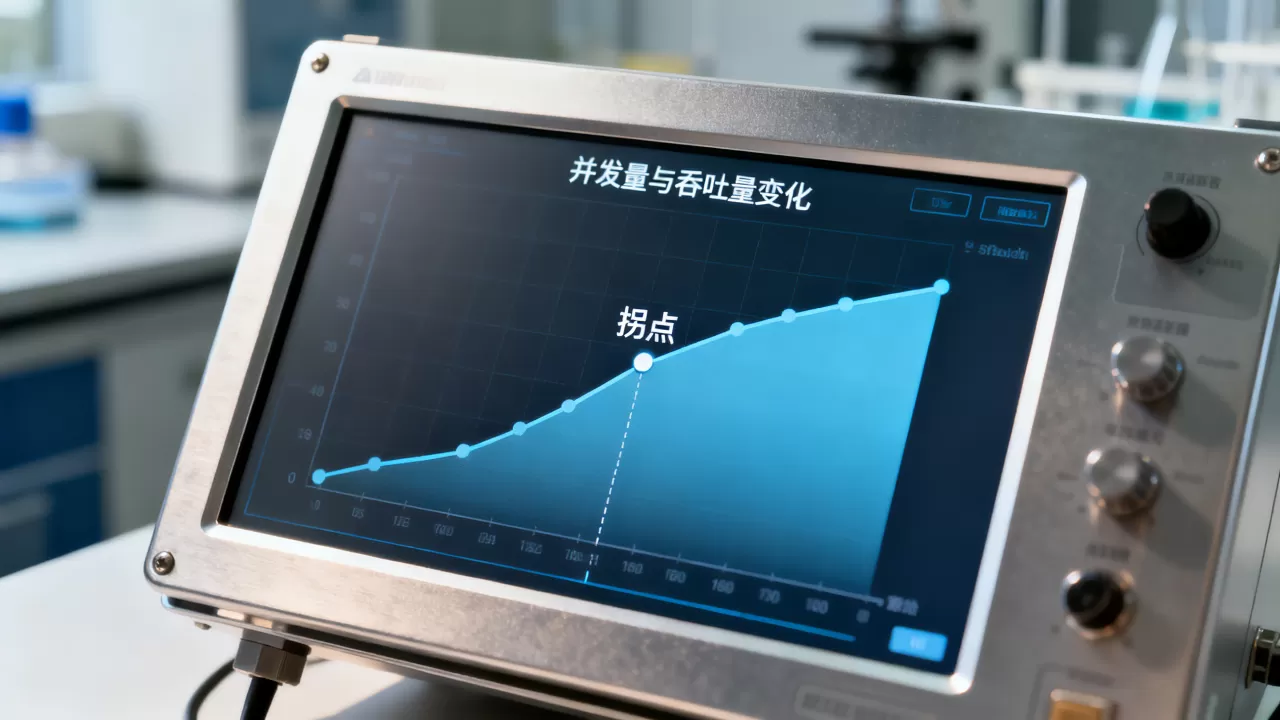
推理吞吐随并发上升并不会无限增长,当并发数越过硬件供给能力的临界点后,吞吐曲线会从近似线性增长转为平台期甚至回落,这个转折点就是拐点,找到它并理解它,是优化推理服务成本与性能的第一步。
推理吞吐量并发拐点怎么找:先搞懂瓶颈在哪
很多团队在压测时发现一个奇怪现象:并发从10加到50,吞吐涨得很漂亮;从50加到200,涨幅开始变缓;到了300以上,吞吐不升反降,这不是偶然,而是推理服务固有的调度规律在起作用。

为什么并发一高吞吐就掉链子
推理引擎处理请求的方式,本质上是一个“攒批”的过程,并发太低时,GPU吃不饱,每个请求虽然快,但单位时间处理的请求总量少,并发升高后,引擎能把更多请求拼成一个batch,GPU的算力利用率上去了,吞吐自然跟着涨,这个阶段叫线性增长区。
但batching不是免费的午餐,一个batch里的所有请求都要共享显存带宽和算力,batch越大,单个请求吃到的资源越少,当并发继续涨,显存带宽成为天花板,每个token的生成速度被拖慢,吞吐就进入了平台区,也就是拐点出现的地方。
如果再往上加并发,情况会更糟,请求排队的等待时间飙升,引擎需要维护的KV cache越来越多,显存开始告急,甚至触发显存溢出后的重排或换出操作,这时候吞吐不但不涨,反而往下掉。
- 低并发区:GPU利用率低,吞吐被算力闲置限制。
- 线性增长区:batching效果显著,吞吐随并发近似线性上升。
- 平台区:显存带宽或算力逼近上限,吞吐增速骤降。
- 回落区:调度开销、排队延迟、显存换入换出吞噬吞吐。
prefill和decode的分阶段真相
想精准定位拐点,光看总吞吐不够,还得把推理拆成两个阶段来观察。
prefill阶段是“一次性计算”,请求的prompt一次性喂给模型,计算密集但时间短,decode阶段是“逐token生成”,每个token都要走一遍模型,内存带宽密集且时间长,不同并发下,这两个阶段对资源的争夺方式完全不同。
并发低时,prefill和decode交替进行,互不干扰,并发高时,多个请求的prefill同时挤进来,抢占显存带宽,直接拖慢正在进行的decode,最终表现为每个token的生成延迟拉长,总吞吐增长停滞。
行业共识认为,拐点的本质就是:请求到达速率逼近系统吞吐上限时,排队时间开始占据端到端延迟的主导地位,而新增的并发请求带来的计算收益已经覆盖不了调度和显存竞争造成的损失。
大模型推理gpu选型对比:同样并发,显卡决定拐点位置
很多团队在选卡时只看显存大小和总算力,却低估了显存带宽对并发吞吐的影响,同一套推理服务,换不同显卡,拐点出现的并发位置可能差出一倍还多。
显存带宽才是真正的天花板
decode阶段几乎是一个带宽受限任务,每个token的生成都需要把模型权重从显存搬到计算单元,模型越大,权重越多,带宽消耗越猛,两张算力相同的卡,如果显存带宽差30%,高并发下的吞吐差距会远比纸面算力差距明显。
以常见的主流加速卡为例,H系列旗舰卡在显存带宽和显存容量上做了强平衡,适合高并发在线推理;而部分主打训练的卡虽然FP16算力很高,但显存带宽相对逊色,在并发超过一定阈值后,吞吐拐点会提前到来。
不同档位显卡的拐点差异
| 显卡档位 | 适合并发规模 | 拐点特征 |
|---|---|---|
| 消费级/入门专业卡 | 个位数到十几路并发 | 拐点来得早,吞吐平台低 |
| 中高端数据中心卡 | 几十路并发区间 | 拐点出现在中等并发,吞吐平台可观 |
| 旗舰级加速卡 | 上百路并发区间 | 拐点靠后,吞吐平台高,但单卡成本高 |
选卡时别只盯着“能跑起来”这个下限标准,要看目标并发下是否越过了拐点,如果业务高峰期并发需求恰好落在平台区之前,就说明卡没选亏;如果长期让请求排长队运行在回落区,加卡比换卡更划算。
还有一条关于成本的参考路径,国产加速卡近年来在推理场景的软件栈成熟度提升明显,价格相比国际主流产品有一定优势,但在高并发下的拐点位置往往比同档位国际卡更靠前,如果你的业务并发天花板不高,用国产卡跑在拐点之前的区间,性价比可能更优;反之,高并发场景闭眼买便宜卡,很可能掉进吞吐塌方的坑。
推理引擎选型对比:vllm和tensorrt-llm哪个快
除了显卡硬件,推理引擎对拐点位置的影响同样关键,同样的并发压测,不同引擎的吞吐曲线可能呈现完全不同的形态。
连续批处理拉开差距
早期推理框架大多使用静态batching,攒够一定数量的请求才一起处理,并发波动时吞吐曲线起伏很大,这类框架的拐点出现得早,平台区还容易抖动。
vLLM之所以受欢迎,核心是实现了PagedAttention和连续批处理(continuous batching),它把KV cache切成固定大小的块,按需分配,显存碎片被大幅压缩,同时允许请求在batch内随时进出,一个请求解码完就能立即腾出位置给新请求,避免等待batch攒满,这让吞吐曲线更平滑,拐点位置明显后移。
TensorRT-LLM则走了另一条路,它针对特定GPU做了激进的内核优化,把算子融合做到很深的层次,在单卡或同构多卡环境下,TensorRT-LLM的峰值吞吐往往比vLLM更高,但如果并发模型和输入长度变化剧烈,它的
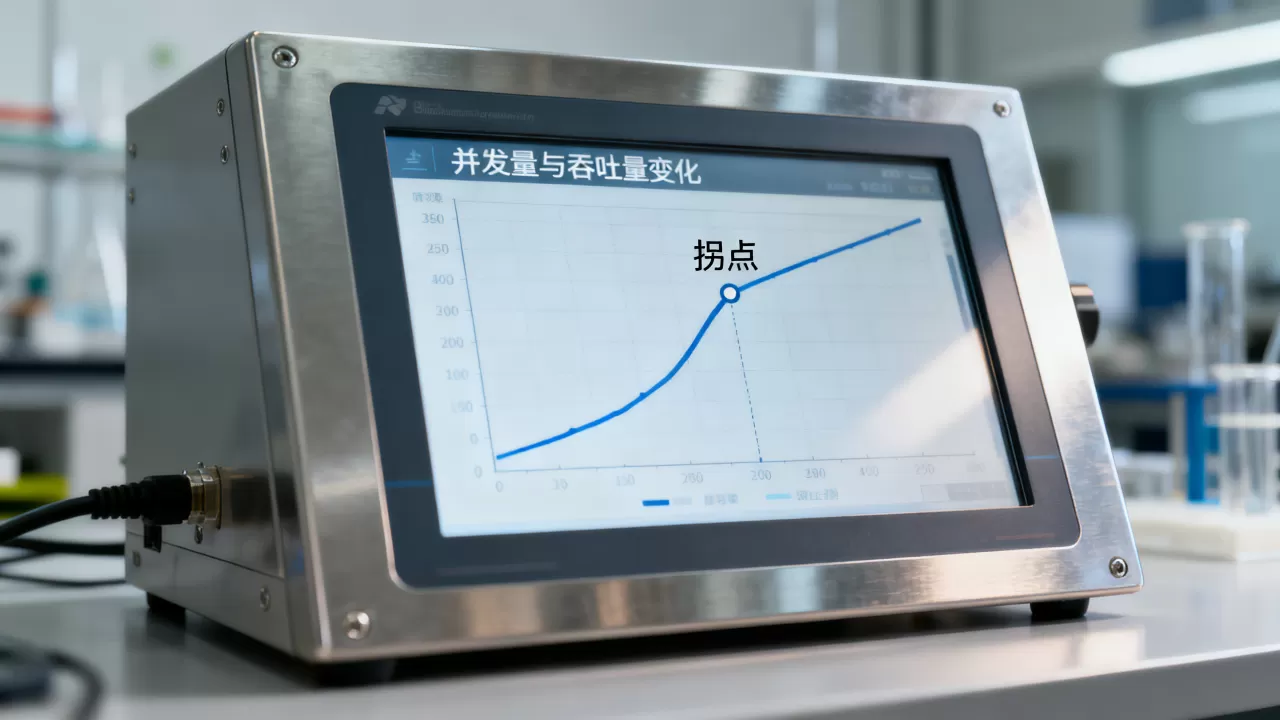
动态适应性略弱,拐点出现后回落速度更快。
动态批处理参数如何调
无论选哪个引擎,都要配置好调度参数,这类参数直接影响拐点位置,值得反复压测调优。
- max_num_seqs:一个batch最多容纳的序列数,调太大容易触发显存压力,调太小则浪费算力。
- max_num_batched_tokens:一次前向计算允许的token总数,它和序列数共同决定batch的“厚度”。
- gpu_memory_utilization:允许引擎占用的显存比例,通常设到0.85以上才能发挥缓存优势,但过高会导致显存换页频发,拐点提前。
- 调度队列长度:等待队列超过一定长度就拒绝新请求或触发限流,能保护在线服务的延迟不失控。
有没有一个通用最优值?没有,不同模型和不同显存容量下,最优配置只能靠分步压测试出来,方法很简单:固定并发,逐渐增加model input长度,观察吞吐和首token延迟;然后把并发往上抬,找到吞吐不再增长的点,回退20%并发量作为安全上线水位。
并发上不去什么原因:排查步骤和优化手段
如果压测结果明显不理想,比如并发只有20出头吞吐就停滞,先别急着怪显卡,按照下面的顺序排查,大多数问题能定位在三个层面之一。
第一层:数据还没到引擎就被堵住了
检查负载均衡、网关、API Server的并发连接数,很多团队压测压的是Python API Server,GIL锁和同步I/O会让请求在进入推理引擎之前就排起长队,业内专家指出,这类纯软件层瓶颈导致的吞吐停滞,约占常见性能问题的三分之一。
排查路径:压测时监控API Server的CPU占用,如果多核打不满但单核跑满,基本可以断定是GIL或框架异步模型的问题,换用支持异步并发更高的服务框架,或者在网关上做连接复用,通常能解决。
第二层:引擎调度参数与GPU算力不匹配
打开推理引擎的监控日志,重点看GPU利用率和显存占用,如果GPU利用率只有三成,说明线程和调度没把数据送满;如果显存快满了但GPU利用率也不高,说明KV cache管理出了内耗,PagedAttention的块大小和预分配比例需要调整。
第三层:模型本身算力消耗超出预期
同样的模型架构,量化前后差距很大,AWQ或GPTQ量化到4bit后,显存占用下降明显,相同显存能承载的并发batch更大,拐点会显著后移,FP8推理则介于两者之间,兼顾精度与吞吐。
推理提速升级方案和价格对比,怎么选不踩坑
当优化和调参都无法满足业务增长需求时,就到了花钱升级的时候,升级方案各有利弊,价格与效果不完全成正比。
加卡横向扩展,还是换更强单卡
加卡走横向扩展,部署简单、弹性好,但多卡间的通信开销会成为新的瓶颈,用Tensor Parallel跑模型,卡与卡之间的通信延迟直接影响decode效率,卡数超过一定规模后,每张卡贡献的吞吐增量会急剧下降。
换更强单卡走纵向升级,省去了分布式通信的烦恼,但单卡价格往往是阶梯式跳跃,前后两代旗舰卡的价格差可能超过40%,而真实吞吐提升通常落在30%到60%之间,如果你的并发需求恰好卡在旧卡拐点附近,换新卡的收益最明显;如果并发需求本身就不大,加一张中端卡反而更划算。
常见升级路径对比
| 方案 | 适用场景 | 优缺点 |
|---|---|---|
| 增加同型号卡 | 并发增长空间大 | 部署简单但机架和供电压力增大 |
| 换用带宽更高的新一代卡 | 拐点过早起主导问题 | 见效直接但价格跳档明显 |
| 多机张量并行 | 单机显存上限卡死 | 提升上限但通信规划复杂 |
| 模型蒸馏/剪枝 | 延迟敏感型业务 | 成本低但精度需做回归验证 |
推理吞吐量并发拐点相关问答
推理吞吐拐点是不是越低越不好?
不是,拐点位置和具体业务形态强相关,离线批处理任务对延迟不敏感,哪怕运行在平台区,只要单位时间能消化完积压任务,吞吐就是达标的,在线交互场景则对首token延迟和token生成速度都有明确诉求,拐点越低,越容易在高并发时出现用户可感知的卡顿,判断拐点“好不好”,要看它和你的业务延迟预算是否匹配。
怎么用最简单的方式找到生产环境的拐点?
压测工具选wrk或ghz这类基于HTTP的就行,固定一个代表性的prompt,从10并发起步,每轮加10,每个并发档位跑5分钟,记录总吞吐和平均首次token时间,当后一轮的吞吐相对前一轮增幅小于5%时,基本可以认为到了拐点附近,再叠加一轮长时间浸泡测试,观察显存是否持续增长,就能确认生产环境的安全水位。
为什么压测时吞吐过了拐点后再次升高是正常的?
部分推理引擎的调度器会在batch满员后将等待请求拆分到多个微批次中,优先保证GPU不空闲,拐点前的回落通常由KV cache换入换出触发,此后引擎一旦完成缓存重排,吞吐可能回到平台区,形成“双峰”曲线,这种二次爬升并不意味着系统恢复了健康,它只是等于把短暂冻结的显存压力摊薄到了更长的时间窗口里,实际每个请求的延迟已经恶化了两倍以上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623177.html