撮合引擎低延迟的关键在于把架构重心从“怎么存数据”转移到“怎么在内存里完成订单匹配”,在操作系统调度、锁竞争和网络距离上压缩一切可压缩的耗时。真正能支撑高并发交易的撮合系统,早已不是简单的数据库读写,而是一整套面向延迟的工程设计。
撮合引擎延迟优化方案中的首要问题:延迟到底从哪儿来
很多团队优化撮合引擎,上来就抠代码细节,结果折腾一个月延迟还是降不下来,行业共识认为,延迟大头通常不在撮合算法本身,而在数据通路的外围,业内专家指出,一条买单从到达服务器到返回成交结果,真正花在“匹配计算”上的时间往往不足总耗时的十分之一,剩下的都消耗在别处。
内核态与用户态的切换代价
一次普通的网络请求,数据要经过网卡、内核协议栈、Socket缓冲区,再被应用层读取,每一次系统调用都有上下文切换成本,当并发量起来之后,这些切换成本会叠加放大,低延迟架构的常用做法是使用DPDK或Solarflare等内核旁路技术,让数据绕过内核协议栈直接进入用户态应用。
锁竞争是延迟刺客
撮合引擎本质上是多线程并发访问订单簿,一旦多个线程同时读写同一个价格档位,锁冲突会直接拉高延迟的尾延迟值,P99延迟变得难看,通常就是锁竞争导致的,多数高性能撮合引擎会采用无锁队列、分片锁或原子操作来规避这个问题。
垃圾回收的不可控停顿
如果用Java或Go开发撮合引擎,GC停顿是绕不开的痛点,与其想尽办法调优GC参数,不少交易团队干脆选择用C++或Rust重写核心撮合链路,把内存管理完全掌握在自己手里,如果团队技术栈受限必须用Java,那就把撮合模块做成独立进程,使用堆外内存或者干脆规避对象分配。
内存撮合和数据库撮合对比:不再是“哪个好”的问题
“怎么样让撮合速度快点”这个问题,变成了“到底该在内存里撮合还是继续用数据库”,这两条路的差异,直接决定了系统的整体形态。
传统数据库撮合的局限
早期交易系统把订单直接写入MySQL或PostgreSQL,用数据库事务来保证一致性,这种方式开发简单,但每一次撮合都伴随磁盘IO、事务日志、行锁竞争,单机吞吐量一旦上千笔每秒就开始告急,多数情况下,数据库方案只能承担账户系统和清算对账的角色,根本顶不住行情剧烈波动时的下单洪峰。
纯内存撮合的正确姿势
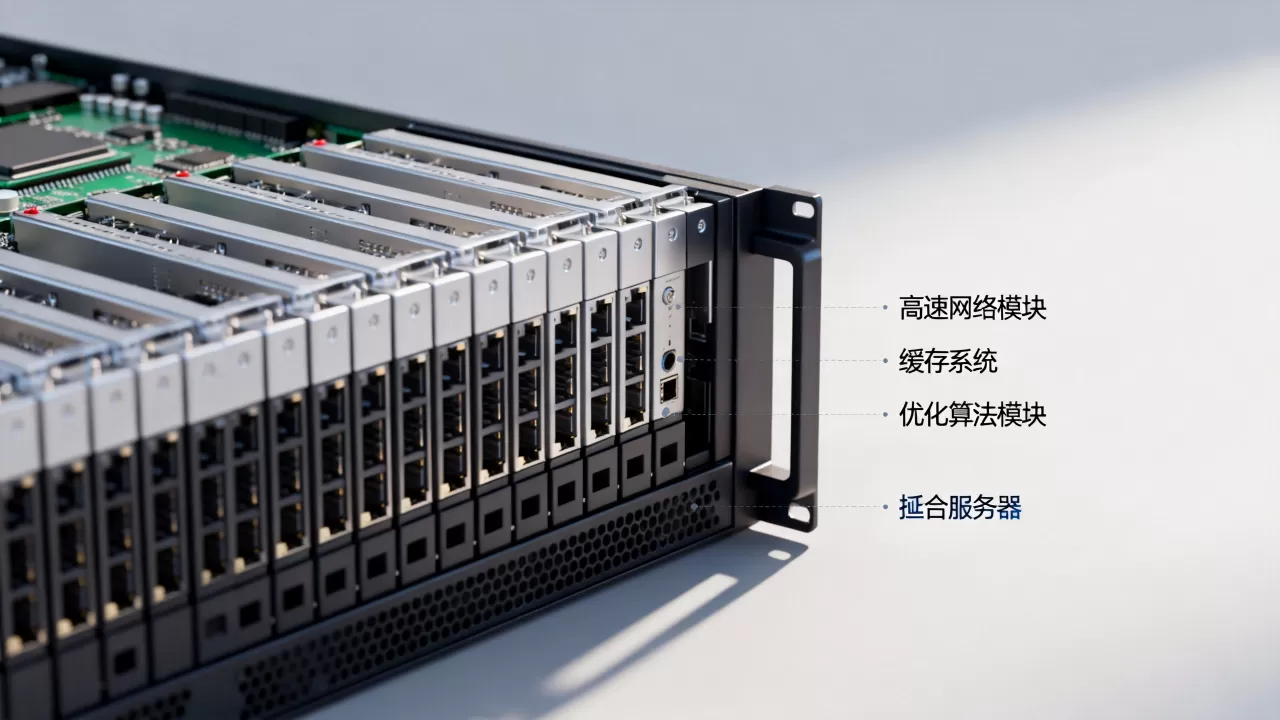
现在主流的设计是:订单簿完全驻留内存,撮合计算全部在内存中完成,系统定期把状态快照和逐笔日志异步写入磁盘,核心链路不落库,落库交给另一个线程池去做,这样的架构在单台物理机上做到每秒几万笔撮合是常见水平,极端调优后能到更高的量级。
内存撮合的可靠性如何保障
内存撮合最大的质疑是“断电了怎么办”,成熟的方案不是不落盘,而是把落盘从同步路径改成异步路径,主线程只管撮合,把每一笔成交记录追加写入一个无锁环形缓冲区,后台线程批量刷盘,再加上主备机热切换,备机通过复制日志维持内存快照的一致性。
撮合引擎低延迟架构的五个落地要点
批量撮合代替逐笔撮合
单笔委托到达系统立即撮合,逻辑简单但效率不高。批量撮合是将一小段时间窗口内的订单收集起来,统一排序后一次完成匹配,这种做法不仅减少上下文切换次数,还能让同价格档位的多笔订单进行批量对手盘匹配,很多衍生品交易所在开市集合竞价阶段就是典型的批量撮合适用场景。
锁无关的订单簿设计
订单簿是撮合引擎的心跳,它的访问效率直接决定性能,核心做法有:
- 价格档位用跳表或红黑树维护,按价格排序后,买卖双方各自从最优价开始匹配
- 每个价格档位下的订单链表用无锁CAS操作追加和移除节点
- 使用读写分离,行情推送线程只读订单簿,下单线程写订单簿,中间用环形缓冲区分隔
业务逻辑与IO线程严格分离
撮合线程千万不要直接处理网络IO或者数据库写入。网络接收线程、撮合线程、行情推送线程、持久化线程必须完全隔离,各线程之间用无锁队列传递消息,一旦某个环节发生阻塞,不能让阻塞传导到撮合主线程。
避免分支预测失败和伪共享
这是底层优化里比较讲究的细节,订单簿的内存布局要尽量贴合CPU缓存的读取习惯,热数据放在同一块连续内存里,订单结构体的字段按读写频度排序,避免多条线程同时修改同一缓存行的不同字段造成伪共享,编译器层面开启
-O3,配合CPU亲和性绑定把撮合线程钉在固定核心上。
行情推送也属于延迟优化范畴
撮合得再快,如果行情推送链路延迟高,做市商的感知就是交易慢,业内积累的经验是:行情推送走独立的TCP或UDP组播通道,不做重组包,不合并深度档位,第一时间推送增量数据,让交易员看到的行情深度和撮合引擎内部的订单簿状态保持一致。
撮合引擎服务器租用哪个机房与部署距离的考量
代码改了几个月,发现延迟数据还是比头部交易所高出一截,这时候要怀疑一下是不是服务器位置选错了,光速在光纤中传播大约是每公里每微秒五分之一毫秒,也就是距离每增加100公里,理论往返延迟就要增加约1毫秒,对于高频交易来说,这个差距比代码层面的几个微秒重要得多。
深圳机房和香港机房的真实差异
做数字货币撮合业务,团队经常在深圳机房和香港机房之间犹豫。深圳机房接入境内网络,物理距离对于境内用户友好,访问速度快;香港机房则是国际线路的汇聚点,欧美用户的连接延迟明显更低,且无需过多考虑IDC备案和合规问题,如果用户群体以国内为主,深圳机房是性价比最高的选择;要是做国际市场,香港机房或者东京机房更有优势。
云服务器和物理机的选择
云服务器方便弹性扩缩容,但同规格的云主机在CPU主频、内存访问速度、网络延迟上不如物理机稳定,业内实践中有相当一部分量化团队自建撮合引擎时选择托管物理服务器,因为多租户的“吵闹邻居”效应会把延迟曲线拉出刺状波动,选型时可以先用云服务器完成开发联调,正式上生产后迁移到物理机。
国家超算互联网与数据中心节点
近年来,国内多个数据中心节点提供低延迟网络专线接入,撮合引擎可以和行情源、清算系统放在同一机房或相邻机房,通过内网通信减少公网抖动,据公开信息,相当一部分合规交易平台把核心撮合系统部署在机房同一机柜内,让所有内部服务之间的通信延迟稳定控制在亚毫秒级。
压测与调优:如何验证低延迟架构的成色
架构设计再漂亮,也要落到测试数字上,团队需要一套可持续复用的压测方法论和排查工具链。
- 用wrk或JMeter模拟HTTP下单请求做基准测试,只测网关转发能力,不包含撮合逻辑
- 用自研的撮合性能测试工具构造海量订单数据,直接灌入撮合核心,在内存中触发GC日志,观察是否有长时间Full GC
- 开启CPU性能剖析工具(perf或火焰图),逐函数确认CPU时间都花在哪里
- 分阶段压测:先测单线程撮合延迟,再测多线程并发撮合的吞吐量,最后测带网络IO的端到端延迟
- P99延迟比平均延迟更有参考价值,平均延迟好看不代表系统健康,尾延迟过于分散会导致部分用户感知到卡顿
线上监控的黄金指标
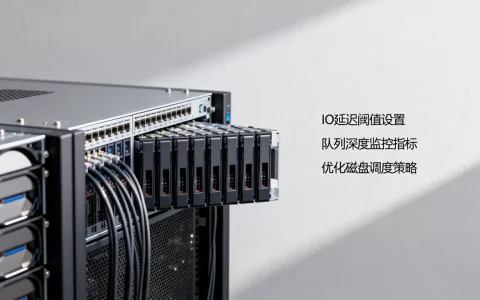
生产环境至少要监控以下指标:撮合线程CPU使用率、等待队列长度、每笔订单撮合耗时、订单簿深度变化频率、GC停顿总时长和最大停顿时间、内核Socket接收队列堆积量,把这些指标实时绘制成仪表盘,配合告警阈值,才能在问题出现的第一时间定位环节。
撮合引擎低延迟调优的核心结论:从系统层面赢回时间
低延迟撮合架构的本质,不是追求某一段代码快,而是让订单在整个数据通路上都不停顿,从内核旁路到无锁数据结构,从CPU亲和性到机房物理选点,每一个细节都是以微秒为单位的博弈,相对于具体选择哪种编程语言或框架,优先把架构层级的时间损耗看清楚,反而更容易拿到显著收益。
撮合引擎低延迟常见问题解答
Q:撮合引擎延迟优化方案中,先优化代码还是先优化部署环境?
A:优先检查物理距离和网络路由,应用代码优化属于微观层面,只能缩短处理器执行耗时;如果服务器离用户群体隔了大半个地球,网络层的几十毫秒延迟很难用代码补偿,业务量大起来之后,再把精力放到无锁队列和内核旁路上。
Q:内存撮合和数据库撮合对比,是不是数据库已经完全不被考虑了?
A:数据库没有被完全排除,但角色变了,撮合动作在内存完成,数据库负责落账、清算和审计,如果强行把订单簿状态管理交给数据库,延迟一定压不下来,合理的架构是内存做主,数据库做次。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/631730.html