服务器一进就崩,最直接的解决办法是:先看监控、再查日志、最后动代码,按这个顺序能在五分钟内找到八成问题的根源。 别急着重启,重启只是把问题延后,不解决根因。
服务器一进就崩的常见原因有哪些
服务器“一进就崩”这个现象,行业内通常叫“触发式宕机”或“临界点崩溃”,它与人一多就崩还不完全一样,更多的像是程序里埋了一个雷,踩中即炸,根据过来人的经验,问题通常出在下面几个环节。

内存溢出:最常见的一进就崩元凶
你打开游戏或应用,客户端请求进来,服务端要分配内存处理数据,如果代码里有内存泄漏,或者一次性加载了超大对象(比如把整个数据库表读进内存),内存瞬间被吃满,操作系统就会启动OOM Killer机制,直接把进程杀掉,表现就是:人一进,服务就没了,后台看日志,最后一行写着OutOfMemoryError或Killed。
排查命令很简单,登录服务器后执行:
free -h
看available列,如果只剩几十MB甚至为0,基本可以锁定,再用:
dmesg | tail -20
如果看到Out of memory: Killed process字样,实锤了。
连接数打满:端口被占死,新请求挤不进来
服务器能同时处理的TCP连接数是有限的,当连接数达到上限(默认值一般是1024或65535),新的连接请求会被挂起或直接拒绝,玩家一进游戏就要建立连接,瞬间几千个连接涌进来,端口直接被占死,外在表现是:游戏能打开,但一点“进入服务器”就卡住,然后服务器崩溃或拒绝响应。
查看当前连接数:
netstat -ant | grep -i established | wc -l
如果这个数字稳定在系统上限附近,问题就在这。
磁盘写入瓶颈或空间耗尽
很多人忽略磁盘,服务器在启动或者玩家进入瞬间,会疯狂写日志、写缓存,如果磁盘空间剩余为0,或者磁盘I/O(读写能力)跟不上,进程会卡在等待I/O的状态,看起来就像“崩了”,实际上是被拖死了。
df -h
看Use%是否接近100%,再用:
iostat -x 1 3
看util是否经常超过80%,超过的话磁盘性能就是瓶颈。
服务器一进就崩怎么排查:五分钟定位法
遇到一进就崩的情况,不要慌,不要反复重启,先按固定路径排查,行业里有个通用排查顺序:先系统层、再应用层、最后代码层。
第一步:看系统负载和CPU状态
top
按P键按CPU排序,按M键按内存排序,如果CPU瞬间飙到100%且不会回落,说明有死循环或高计算量操作在用户进入时触发,如果CPU不高但是系统卡死,重点看wa(等待I/O)那一栏,数值高就是磁盘问题。
第二步:翻应用日志找异常堆栈
日志是服务器崩溃前留下的“遗言”,进入应用的日志目录,常见路径是:
tail -200 /var/log/app/error.log
搜索关键异常词:Exception、Error、Timeout、Full GC,一旦看到java.lang.OutOfMemoryError或Too many open files,答案就出来了。
第三步:复现时抓线程快照
崩溃往往发生在进入瞬间,所以复现时同步抓快照很关键,一边让用户进游戏,一边执行:
jstack {pid} > /tmp/thread_dump.txt
或者用kill -3 {pid}把线程dump输出到日志,看线程快照里是不是很多线程卡在同一个方法上,比如数据库连接、锁等待、网络读取,卡在同一处,说明那片代码就是雷区。
游戏服务器人一多就崩怎么办:扩容与优化
如果你的情况是“进的人少没事,人一多就崩”,那就不是简单的代码BUG,而是容量设计问题,这里要说清楚一个区别:一进就崩是引爆点问题,人一多就崩是容量天花板问题,前者要修雷,后者要加宽路。
简单粗暴方案:水平扩容
把单台服务器扛不住的压力分散到多台机器上,现在主流做法是用负载均衡(Nginx或云负载均衡)在前面分流,后面挂多台应用服务器,比如原来一台8核16G的机器,现在改成三台同样的机器,承载能力近乎线性提升。
操作路径是:在云控制台创建镜像,用镜像批量创建新实例,加入负载均衡后端节点,然后逐步放量测试。
优雅方案:限流降级与队列削峰
不一定要加机器,对于瞬间涌入的请求,可以在入口层加一个队列,让请求排队处理,而不是一次性全部打进来,行业共识认为,合理的限流策略能掩盖大部分性能短板。
具体做法:
- 在Nginx层配置
limit_req,限制每秒请求数 - 在应用层引入消息队列(如RabbitMQ、Kafka),把高并发写操作转成异步
- 设置最大并发数,超出部分直接排队或提示“服务器繁忙”
比如一个副本房间最多30人,那就限制同时进入的请求为30个,其他等待。
代码层优化:查热点方法和慢SQL
如果扩容后还是崩,那问题大概率在代码,最热门的套路是拿性能分析工具(如Arthas)看哪个方法耗时最长,很多情况下,崩溃前总是伴随着一条慢SQL数据库CPU被打满,所有请求都在等数据库响应,然后雪崩。
用Arthas的命令:
trace com.example.GameServer login
看看用户进入时,登录方法里每个子调用花费的时间,发现某个查询超过500毫秒,优化索引或加缓存即可。
租用的服务器一进就崩和配置有关系吗
经常有人问“我租的服务器是不是太差了”,这个问题要拆开看,根据近年来的行业观察,相当一部分“一进就崩”和服务器配置没关系,和程序写法有关系,你拿一台物理机跑一个单线程死循环,照样崩。
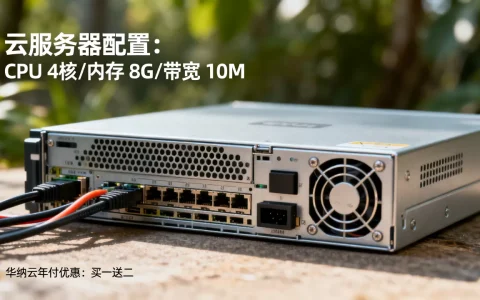
但配置确实有底线,对于一个百人同时在线的游戏或应用,建议最低配置参考:
- CPU:4核以上,低于这个数遇到突发流量很难扛
- 内存:8GB起步,Java系应用建议16GB,因为JVM堆内存通常要占一半
- 磁盘:SSD必备,机械硬盘的随机读写速度在日志爆炸时就是灾难
- 带宽:按峰值计算,单用户在线需要约50KB/s至200KB/s的流量,100人同时在线至少需要10Mbps以上的带宽
如果你的配置已经达到这个水平还崩,问题在软件端,不用再花钱升级硬件了。
云服务器和物理机的选择差异
租用的云服务器通常有CPU积分限制(比如突发性能实例),长时间高负载运行后,CPU被限制在基准线的20%左右,这时候一旦有人进来,直接卡死,如果你用的是这类实例,看控制台上的“CPU积分余额”,见底了就是实例被限流了。
预算允许的情况下,换成独享型实例或者物理机,能解决一部分诡异的崩溃问题,价格上,国内主流云厂商的独享型4核8G实例,包年费用在2000元至4000元的区间,具体看地域,比如北京、上海节点的价格通常比西南节点贵10%到20%。
防止服务器反复崩溃的日常保障
修好一次不难,难在不再犯,行业内在稳定性保障上有一套成熟的打法,照着做能少踩很多坑。
监控报警:别人比你早知道崩溃
不要等用户反馈说“进不去”了才知道出事,在服务器上部署监控工具,推荐Prometheus加Grafana组合,或者直接用云监控,重点盯四项指标:
- CPU使用率,超过85%持续5分钟报警
- 内存使用率,超过90%立即报警
- 磁盘空间,剩余不足10%报警
- TCP连接数,达到上限的80%报警
报警方式选电话或短信,别只发邮件,等看到邮件的时候服务器已经崩了。
压测演练:提前引爆雷区
崩过一次的地方,要反复用压测工具验证是否修好,用Apache Bench或者wrk做简单压测:
wrk -t4 -c100 -d30s http://你的服务器地址/login
看QPS(每秒请求数)和错误率,如果QPS上不去,错误率超过1%,说明还有问题,建议每个版本上线前都做一次压测,成本很低,收益很高。
日志切割与清理:防止磁盘被日志撑爆
很多崩溃其实是日志文件太大导致的,日志写入速度大于切割速度,磁盘写满,应用假死,配置好logrotate按天切割,同时设置日志保留天数,比如只保留7天,大大降低磁盘被日志撑爆的风险。
常见配置写法:
/path/to/app/logs/.log {
    daily
    rotate 7
    compress
    missingok
    copytruncate
}
服务器一进就崩和配置有关系吗:Q&A
每次重启后能正常一会儿,但过一段时间又崩,是什么原因
这通常是资源被缓慢耗尽,重启释放了内存和连接数,但运行一段时间后,泄漏的内存或未关闭的连接又积累到临界点,按前文排查步骤,重点看内存趋势和连接数趋势,找到具体是谁在增长,更推荐的做法是抓崩溃前的快照对比,定位到具体代码行。
多个服务跑在同一台服务器上,互相影响导致崩溃怎么办
行业共识认为,混部是稳定性的大敌,如果条件允许,用Docker或Kubernetes做隔离,限制每个容器的CPU和内存配额,比如游戏逻辑和数据库分离,日志服务单独部署,如果无法拆分,至少在进程级别做资源限制,用cgroup把各服务的CPU和内存隔离,避免一个服务吃光资源拖垮整个服务器。
异地机房或节点配置差异大,导致部分地区用户一进就崩怎么处理
这种多见于全国部署多节点的场景,排查思路是分地域抓包和日志,看崩溃请求在后端节点的具体报错,若排除代码差异,那就是节点所在机房的容量或网络链路问题,可以针对性给高压力区域的节点扩容,或把该区域用户导流到更稳定的相邻节点,让各节点的负载相对均衡。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771885.html