一句话回答
服务器电源冗余不是锦上添花,而是AI训练连续性的底线保障任何单点电源故障都可能让数小时甚至数十小时的算力投入瞬间归零。这一结论适用于从单卡工作站到千卡集群的所有深度学习训练场景。
断电如何摧毁训练任务:远比”重启一下”更严重
检查点机制:训练进度的”存盘点”陷阱
多数人以为训练中断不过是”重新来过”,深度学习框架的断点续训机制存在严格的时间窗口限制,PyTorch Lightning和TensorFlow的ModelCheckpoint回调默认每N个epoch或固定step数才写入一次权重快照,这就意味着,两次检查点之间的所有梯度更新、学习率调度状态、优化器动量数据都会在断电瞬间消失。

假设batch size为32、步长为128秒/step,一个检查点间隔若配置为1000步,那么一次断电可能丢失长达35小时的有效计算进度,这还没算上数据加载管线需要重新打乱、GPU显存需要重新分配的时间成本。
训练中断的隐藏连锁反应
- 分布式训练会话失效:多机训练时,任一节点掉电不仅影响自身,还会触发AllReduce通信超时,导致整个集群的任务管理器强制终止全部worker进程,即使其余节点电源完好,也必须整体重启。
- 学习率调度器状态丢失:CosineAnnealing或OneCycle这类动态学习率策略依赖全局step计数,重启后若从保存的epoch恢复而非step恢复,学习率曲线会错位,模型收敛速度显著下降。
- 数据加载器状态紊乱:自定义Dataset中的shuffle种子、分布式采样器的epoch索引在异常退出后无法自动对齐,可能造成同一批次数据在不同worker间重复或遗漏。
服务器电源冗余有必要吗:从”有没有”到”够不够”
冗余的本质是消除单点故障
行业共识认为,电源是所有服务器组件中平均故障间隔时间最短的部件之一,电容老化、风扇积灰、雷击浪涌、市电波动都可能导致电源模块提前失效,在7×24小时满负荷运行的训练服务器中,电源长期处于60%-80%负载区间,发热和纹波压力远高于普通业务服务器。
单电源设计意味着,任何一个电源模块的损坏都会直接触发整机断电,而冗余电源的意义不在于”多一个备胎”,而在于故障转移后的持续供电能力,金牌/铂金认证电源模块的热插拔设计允许运维人员在机器不停机的情况下更换故障模块,这对动辄数百小时的训练任务至关重要。
冗余但无切换价值:一个容易忽略的误区
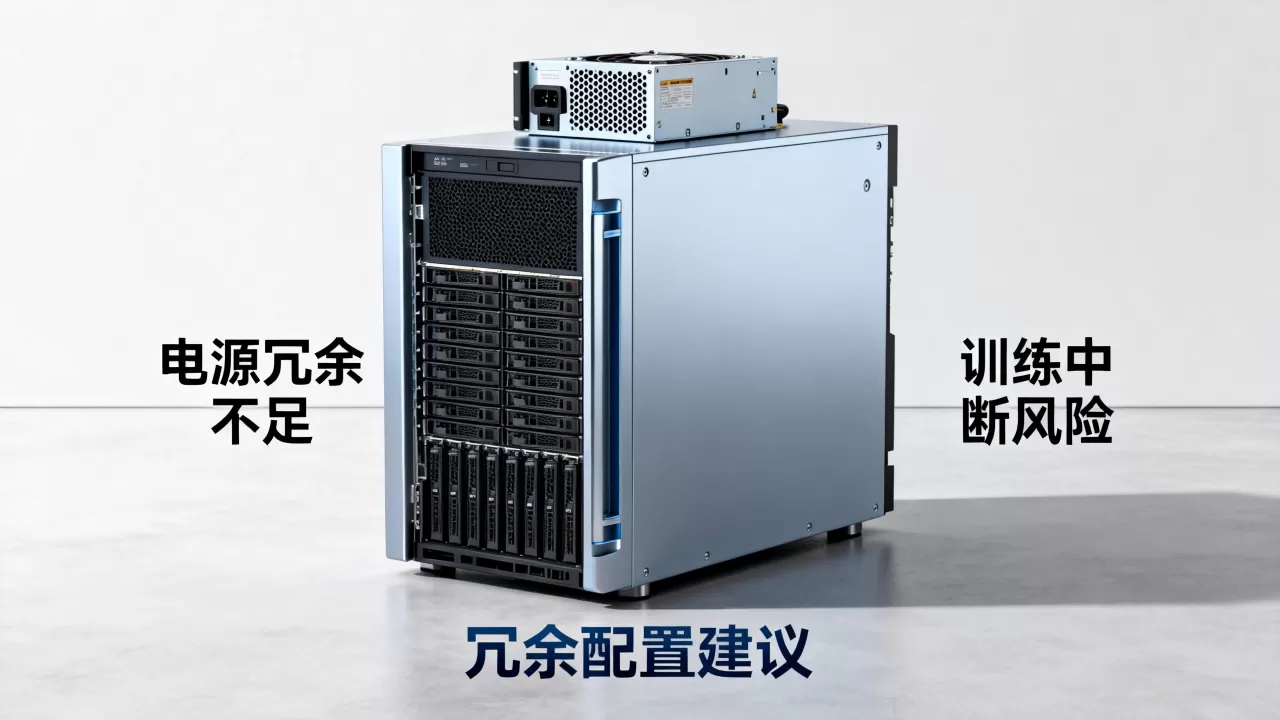
并非所有电源冗余配置都等于高可用,需要区分如下场景:
| 冗余类型 | 配置方式 | 故障切换行为 | 训练连续性保障 |
|---|---|---|---|
| 双模块单路 | 2×800W挂同一路输入 | 模块故障可切换,输入掉电仍宕机 | 仅防模块故障 |
| 双模块双路 | 2×800W挂独立两路市电 | 模块或单路输入故障均可切换 | 常规业务够用 |
| N+N冗余 | 4×800W挂两组独立输入 | 任意组故障不中断供电 | 适合生产级训练集群 |
| 冗余+UPS | 双路+在线式UPS | 市电全断仍可撑N分钟 | 训练连续性最高保障 |
单独的双电源模块并不能应对机房级的输入配电跳闸,如果两路输入来自同一个上游变压器,那么变压器检修时整个机柜照旧断电,真正的连续性需要结合机柜级配电设计。
GPU服务器电源冗余怎么选:按训练场景对号入座
单机多卡训练:2+1备用比双模块更实用
四卡或八卡GPU服务器在满载时功耗普遍在2000W-4000W区间,此时电源模块的负载率接近80%阈值,高温运行环境会进一步加速电容老化,建议选配3个1600W模块(2+1冗余),而非仅仅2个2400W模块(0+1无备用),前者在单模块故障时仍有2个模块支撑约3200W实际输出,足以维持GPU降频运行而非整机断电。
实际操作中,还有一个容易被忽略的细节:NVIDIA驱动在供电不足时不会直接关机,而是先触发GPU的功耗上限保护,将训练性能下降30%-50%后继续运行,你会发现任务没有中断,但每个step耗时明显拉长,总训练时间被动增加,这种情况下的电源冗余反而是性能稳定性的保障。
多机集群训练:机架级冗余优于节点级冗余
当训练任务拆分到4台及以上的服务器时,单节点电源冗余的意义被稀释因为任何一台独占设计节点掉电,整个作业照样失败,多机场景更建议将预算投入到机架级配电方案上:
- 每个机柜配置独立的ATS(自动转换开关)设备,连接两路不同的市电来源
- 为关键训练节点配置机架式UPS(如3kVA在线式),支撑5-10分钟的发电机启动时间
- 将检查点写入共享存储(如NFS或Lustre),而不是节点本地磁盘
以常见的数据并行分布式训练为例,8节点同步训练时,任意节点故障都会导致AllReduce卡死,多数情况下,训练平台设定的超时时间在30-60秒,若电源故障无法在这段时间内完成切换,整个训练任务都会自动终止。
离线调参与断点续训:性价比优先的”软冗余”
对于不需要7×24小时连续运行的场景,更务实的方案是强化软件层面的续训能力,将检查点间隔压缩到每10-15分钟一次,这样即使电源故障导致宕机,最多也只丢失十几分钟的进度,远比升级硬件冗余的成本低得多。
电源冗余的运维实操:保障冗余真正发挥作用的动作
定期验证切换能力,而非只看指示灯
电源模块自带的LED指示灯只能反映”当前是否有电”,不能证明故障切换功能正常,推荐按如下周期进行验证操作:
- 进入服务器BMC管理界面(如iDRAC或IPMI),找到电源模块监控页
- 在线拔下其中一个热插拔电源模块,观察系统日志是否出现”Power Supply Degraded”事件
- 确认GPU训练进程无任何中断,负载状态平稳
- 重新插回模块,等待约1分钟让电源同步完成后,再测试另一个模块
整个测试过程建议每季度执行一次,多数训练集群的宕机事故并非电源模块本身质量问题,而是冗余功能从未被验证过,在真实故障时才发现没有正确同步。
用监控告警替代人工巡检
依赖人工查看BMC页面显然不现实,需要配置SNMP或Redfish协议的告警推送,重点监控四个指标:
- 电源模块输入电压偏移值(超过额定值±10%时触发预警)
- 模块温度与风扇转速(温度超过65℃时故障概率显著上升)
- 输出功率占比(持续超过85%意味着冗余余量不足)
- 电源模块自身的事件日志(通常包含掉电记录和过流保护的次数)
在Kubernetes集群环境中,还可通过节点上的ipmitool命令采集电源状态并上报至Prometheus,设定告警规则后,任何异常都会在5秒内推送至运维钉钉或企业微信群,这套方案不需要额外付费软件,全部是开源组件的常规用法。
电源冗余与训练工程化的综合实践
多级冗余架构是最有性价比的长期投入
从工程实践上看,面向AI训练的基础设施,优先推荐的顺序是:软件检查点压缩 → 节点双电源模块 → 机柜级ATS切换 → 在线式UPS,这四层防护的成本占比和效果各不相同,并不建议将全部预算砸入单一环节。
举一个实际部署案例,某中型AI实验室的4台8卡训练服务器,曾因机房空调故障导致温度攀升,4个电源模块中有2个陆续因过热保护自动关机,由于配置了N+N冗余和主备UPS,训练任务无感知继续运行,后续在计划窗口内先后更换了受损模块,同楼层的另一家创业公司单电源服务器,在同一事故中直接丢失了32小时训练进度。
场景化的电源预算决策
| 需求描述 | 推荐方案 | 预算倾向 |
|---|---|---|
| 单机4卡以下,白天开发调试 | 单电源 + 高频检查点 | 把预算花在更大显存上 |
| 8卡服务器夜间跑长任务 | 双模块冗余 + 每周切换测试 | 电源是稳定运行的基石 |
| 小规模分布式训练(2-4机) | ATS + 节点双电源 | 重点关注共享存储的可靠性 |
| 生产级多机训练集群 | N+N冗余 + 在线式UPS | 面向无人值守的长期运行 |
AI训练服务器电源配置常见疑问解答
问:服务器电源冗余有必要吗,还是单纯增加采购成本?
答:如果训练任务的单次时长在4小时内,且失败后重新启动的代价可控,单电源方案可以接受,但凡是无人值守的过夜训练或多机同步作业,双电源模块带来的成本增幅通常不足整机采购价的3%,却能将电源故障导致的停机概率直接降低一个数量级,从长期运行成本来看,冗余配置的投入基本都能被避免的训练中断损失覆盖。
问:电源冗余对训练连续性到底有多大影响,能具体衡量吗?
答:以批量训练任务的平均故障间隔为参照,电源模组故障在服务器硬件故障中占据相当比例,仅次于硬盘和内存,假设一台训练服务器年度硬件故障概率为2%-3%,其中相当一部分会直接导致整机掉电,双电源模块可将这一特定风险的损失概率分散至可忽略水平,量化的关键是自行统计历史任务的失败原因,若电源排在日志中的前三位,那么冗余投资的回报率会非常直观。
问:GPU服务器电源冗余怎么选才不算浪费预算?
答:核心判断依据是GPU的持续性负载而非TDP峰值,建议查看NVIDIA-SMI在训练稳定期的实际整卡功耗,乘以GPU数量后加上30%的余量,再除以0.9(电源最佳负载率区间),得到的数值就是所需电源总额定功率,例如8张A100训练时稳定功耗约3200W,加上余量和转换效率损耗,至少需要4000W级别的电源输出能力,模块数量上,优先选3+1而非2+2,因为留出更多单模块负载弹性,也能够兼容未来增加PCIe设备后的额外功耗需求。
训练连续性从来不是软件层面的问题,而是基础设施的底气。电源冗余的价值不在于让服务器永不关机,而在于让意外故障发生时训练任务依然稳如磐石,在做AI基础设施规划时,把电源冗余放在与GPU同等重要的位置,是大概率不会后悔的决定。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625171.html