Hive 是构建数据仓库的核心工具,它通过将 SQL 查询转换为 MapReduce 任务,让海量数据的离线分析变得像写普通 SQL 一样简单高效。
在大数据生态系统中,Hive 的地位如同数据库领域的 MySQL,但它的舞台是 PB 级的数据湖,对于许多初次接触大数据的开发者而言,理解 Hive 不仅仅是安装一个软件,更是掌握一种处理海量非结构化或半结构化数据的思维方式,它填补了传统关系型数据库在存储成本和处理能力上的空白,成为企业数据中台建设的基石。
Hive 的核心定位与架构解析
Hive 并非传统意义上的数据库,而是一个建立在 Hadoop 之上的数据仓库基础设施,它的核心价值在于提供了一套标准的数据管理工具,能够将结构化的数据文件映射为一张数据库表,并提供完整的 SQL 查询功能。
为什么选择 Hive 而非原生 MapReduce
原生 MapReduce 编程模型虽然灵活,但开发门槛极高,需要编写大量的 Java 代码来处理简单的数据聚合逻辑,Hive 的出现解决了这一痛点。
- SQL 抽象层:Hive 将 SQL 语句转换为 MapReduce 任务,开发者只需掌握 SQL 语法即可操作 Hadoop 集群。
- 元数据管理:通过 Metastore 组件,Hive 能够统一管理表结构、分区信息等元数据,使得数据资产清晰可见。
- 可扩展性:依托 Hadoop 的 HDFS 存储和 YARN 资源调度,Hive 天然具备水平扩展能力,能够轻松应对数据量的指数级增长。
业内专家指出,Hive 的设计初衷并非为了低延迟查询,而是为了高吞吐量的批量数据处理,在理解其架构时,必须明确它适用于离线分析场景,而非实时交互场景。
Hive 的关键组件功能拆解
要深入理解 Hive,需要厘清其内部各组件的协作关系。
用户接口(Client)
包括 CLI(命令行接口)、JDBC/ODBC 驱动以及 Web UI,CLI 是最常用的交互方式,适合脚本自动化任务;JDBC/ODBC 则允许 Java 程序或其他 BI 工具连接 Hive 进行查询。
元数据存储(Metastore)

这是 Hive 的大脑,它存储了表名、列、分区、属性以及表数据所在的 HDFS 目录等元信息,默认情况下,Metastore 使用嵌入式 Derby 数据库,但在生产环境中,通常配置为 MySQL 或 PostgreSQL,以确保高可用性和多用户并发访问。
驱动器(Driver)
负责解析 SQL 语句,生成执行计划,并协调任务的执行,它包括编译器、优化器和执行器,是将逻辑 SQL 转化为物理执行计划的关键环节。
Hive 在实际业务场景中的应用策略
在实际的企业级应用中,如何设计 Hive 数据仓库模型直接决定了查询效率和数据质量,许多团队在初期容易陷入“大宽表”或“过度规范化”的误区。
数仓分层架构的最佳实践
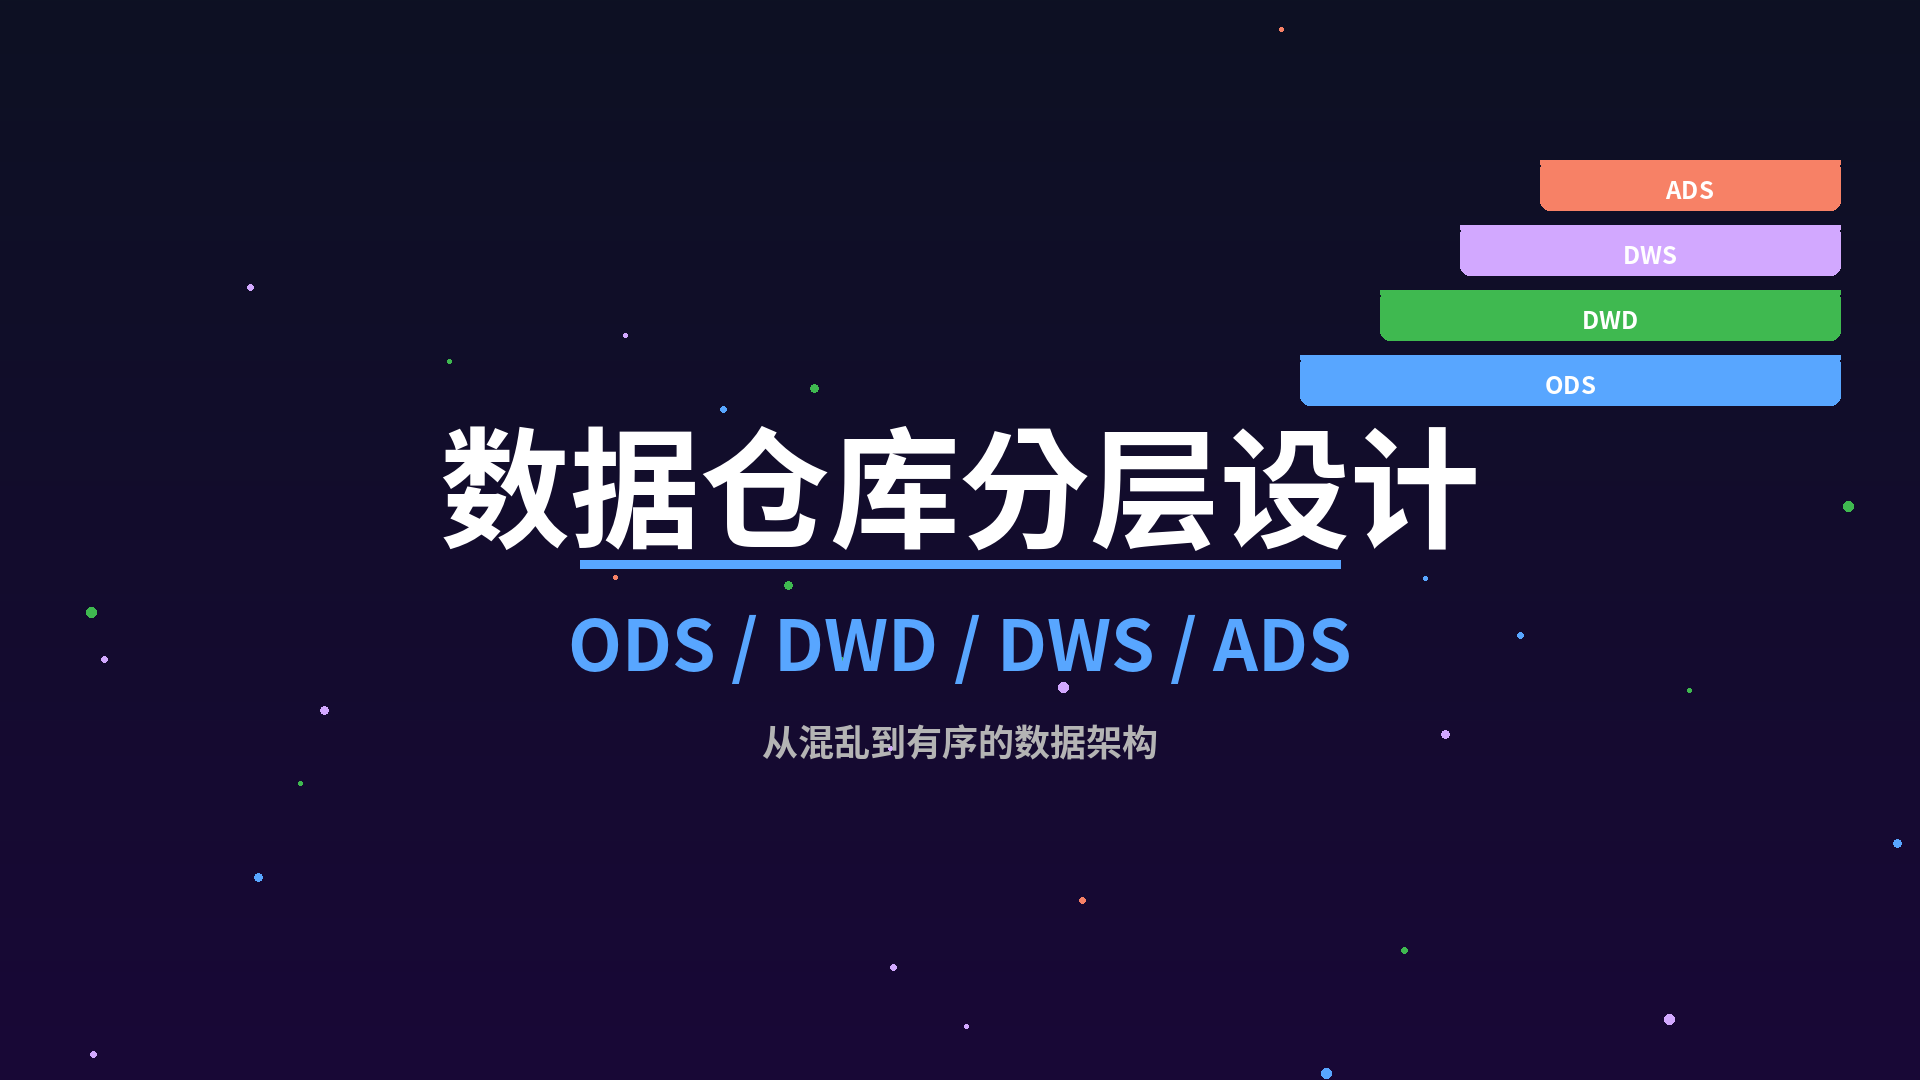
构建稳健的数据仓库,通常遵循 ODS、DWD、DWS、ADS 的分层理念。
- ODS 层(原始数据层):直接同步业务数据库或日志数据,保持数据原貌,不做任何清洗。
- DWD 层(明细数据层):进行数据清洗、标准化、脱敏,形成明细事实表,将用户点击日志中的时间戳统一转换为标准格式,并关联用户维度表。
- DWS 层(服务数据层):基于 DWD 层进行轻度汇总,形成主题宽表,按天统计每个用户的活跃时长、订单金额等指标。
- ADS 层(应用数据层):面向具体业务需求,生成高度汇总的报表数据,直接支撑前端展示或决策分析。
这种分层结构不仅降低了数据耦合度,还极大地提升了查询性能,当业务方需要调整某个指标的计算逻辑时,只需修改 DWS 或 ADS 层的 SQL,而无需重新处理底层海量数据。
分区与分桶的优化技巧
Hive 的性能瓶颈往往出现在数据扫描量过大时,合理使用分区和分桶是优化的关键手段。
分区(Partition)
分区相当于文件系统的目录结构,通过在表定义中加入 `PARTITIONED BY (dt STRING)`,Hive 会将不同日期的数据存储在 HDFS 的不同目录下,查询时,通过 `WHERE dt = ‘2026-01-01’` 可以触发分区裁剪,仅扫描特定目录下的数据,从而将查询时间从小时级缩短至秒级。

分桶(Bucket)
分桶是对数据进行更细粒度的划分,基于某个字段的哈希值将数据分散到固定数量的文件中,分桶主要服务于 MapJoin 和采样查询,在对用户 ID 进行分桶后,进行连接操作时,Hive 可以确保相同 ID 的数据在同一个 Reduce 任务中处理,避免数据倾斜。
常见问题与性能调优指南
尽管 Hive 功能强大,但在实际运行中,开发者常遇到查询缓慢、内存溢出等问题,以下是基于行业共识的调优建议。
解决数据倾斜
数据倾斜是指某些 Reduce 任务处理的数据量远大于其他任务,导致整体作业卡住。
- 空值过滤:在 Join 操作中,如果关联键存在大量 NULL 值,会导致所有 NULL 值被分发到同一个 Reduce,解决方案是在 SQL 中将 NULL 值替换为随机字符串,分散到不同 Reduce。
- 参数调整:启用 `hive.optimize.skewjoin` 参数,Hive 会自动检测倾斜键并采用特殊的处理逻辑。
小文件合并
HDFS 不适合存储大量小文件,这会消耗 NameNode 的内存资源并降低 Map 任务效率。
具体操作命令
可以在 Hive 会话中执行以下设置,自动合并小文件:
SET hive.merge.mapfiles = true;
SET hive.merge.mapredfiles = true;
SET hive.merge.size.per.task = 256000000;
在数据加载完成后,可以使用 ALTER TABLE table_name CONCATENATE; 命令手动合并分区内的文件。
Hive 与其他大数据组件的对比
在选择技术栈时,明确 Hive 的边界至关重要,许多初学者容易混淆 Hive、Spark SQL 和 Presto 的适用场景。
Hive 与 Spark SQL 的对比
Spark SQL 基于内存计算,速度远快于基于磁盘的 Hive MapReduce,Hive 在数据持久化、元数据管理和生态兼容性上仍有优势。
- 计算引擎:Hive 默认使用 MapReduce,也可配置为 Tez 或 Spark 引擎,Spark SQL 原生支持内存计算。
- 适用场景:Hive 适合离线批处理,数据延迟要求不高;Spark SQL 适合迭代计算和实时性要求稍高的场景。
- 学习成本:两者 SQL 语法高度相似,但 Spark 的 API 更丰富,支持 RDD 等高级抽象。

Hive 与 Presto/Trino 的对比
Presto 是专为交互式查询设计的引擎,延迟在秒级甚至毫秒级,而 Hive 的延迟通常在分钟级。
- 架构差异:Presto 采用分布式查询引擎,直接查询 HDFS 或 S3 上的数据,不依赖 Hadoop YARN;Hive 依赖 Hadoop 生态。
- 数据源支持:Presto 支持多数据源异构查询,如同时查询 MySQL 和 HDFS;Hive 主要面向 HDFS 数据。
业内共识认为,现代数据架构通常采用“Hive 存储 + Spark/Presto 计算”的混合模式,兼顾成本与性能。
Q&A:Hive 数据仓库的常见疑问
Hive 数据仓库搭建需要多少硬件成本
Hive 本身是软件,无授权费用,但依赖底层 Hadoop 集群,成本取决于数据规模,对于小型团队,使用云服务器搭建 3-5 节点的 Hadoop 集群即可起步,初期投入主要在服务器租赁和运维人力,随着数据量增长,需增加 DataNode 节点以扩展存储和计算能力,据工信部相关数据显示,中小企业构建基础数据仓库的初期硬件投入通常在数万元至十万元级别,具体视云服务商定价而定。
Hive 是否支持实时数据插入
Hive 传统上不支持低延迟的实时插入和更新,因为 HDFS 是追加写模型,不支持随机修改,若需实时写入,需结合 Kafka 和 Flume 等组件,先将数据落地到 HDFS 或 HBase,再通过 Hive 进行离线分析,对于强实时性需求,建议直接使用 HBase 或 ClickHouse,而非 Hive。
如何确保 Hive 查询结果的数据准确性
数据准确性依赖于严格的数据治理,在 ETL 过程中加入数据校验规则,如主键唯一性检查、非空约束和范围校验,建立数据血缘追踪机制,记录每个字段从源头到报表的转换逻辑,定期进行数据比对测试,将 Hive 计算结果与源系统或其他计算引擎(如 Spark)的结果进行抽样对比,确保逻辑一致。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/205420.html