构建高效数据仓库团队的核心在于打破“技术”与“业务”的壁垒,建立以数据产品思维为导向的敏捷协作机制,而非单纯堆砌高薪技术人员。
很多企业在搭建数据团队时,往往陷入一个误区:认为只要招来几个顶尖的架构师,数据仓库就能自动运转起来,事实并非如此,数据仓库不仅是技术的堆叠,更是组织能力的映射,一个高效的数据仓库项目团队,必须像一家精密的工厂,既有设计图纸的架构师,也有铺设管道的工程师,更要有懂得如何把数据变成商品的分析师,这种协作模式,直接决定了数据资产能否真正转化为业务价值。
明确角色分工:从“单打独斗”到“特种部队”
传统的数据团队往往分工模糊,导致责任推诿,高效团队需要清晰的边界与协作接口,业内专家指出,明确的角色定义是提升协作效率的第一步。
数据架构师:团队的“总设计师”
数据架构师不需要天天写代码,但必须懂业务,他们的核心职责是制定数据标准、规划模型层级以及确保数据的一致性,在选型阶段,他们需要根据企业当前的数据规模和技术栈,决定是使用开源方案还是商业软件,在评估不同数据仓库解决方案价格时,架构师不仅要考虑软件授权费,更要计算后续的维护成本和人才培训成本,他们制定的规范,是所有后续工作的基石。
数据工程师:数据的“搬运工”与“加工厂”
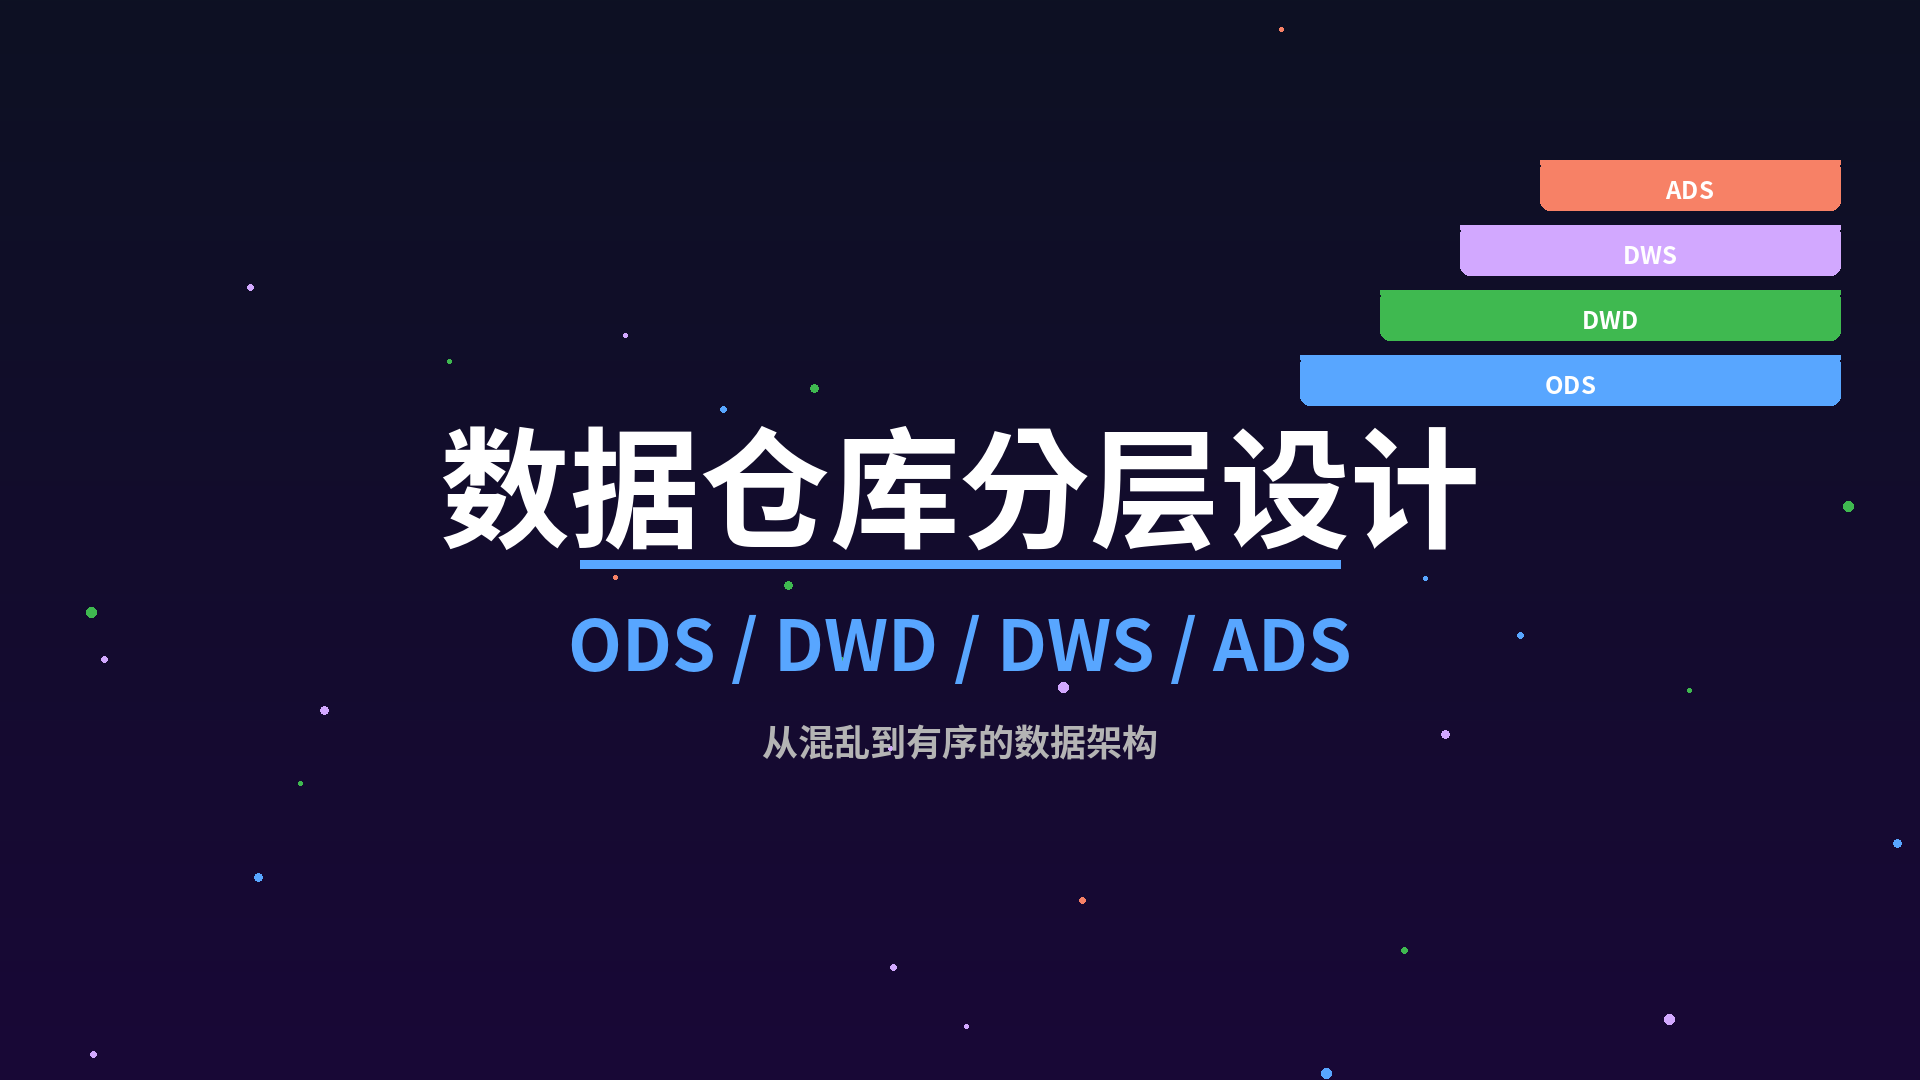
这是团队中人数最多的群体,负责ETL(抽取、转换、加载)流程的开发与维护,他们的工作场景非常具体:每天凌晨,当业务系统产生海量日志时,数据工程师编写的调度脚本必须准时启动,将数据从MySQL、Oracle或API接口中抽取出来,经过清洗、脱敏、聚合,最终落入数仓的ODS(原始数据层)和DWD(明细数据层)。
关键实操步骤
- 建立自动化监控:配置数据质量监控规则,一旦数据延迟超过15分钟或字段空值率异常,立即触发报警。
- 代码版本管理:所有ETL脚本必须纳入Git版本控制,严禁直接在生产环境修改代码。
- 资源隔离:将计算任务与存储任务分离,避免大数据量查询拖垮在线业务数据库。

数据分析师:业务的“翻译官”
很多公司招了分析师,却让他们去写SQL取数,这是极大的资源浪费,高效团队中的分析师,应专注于从数据中发现洞察,提出业务建议,他们不需要精通底层架构,但必须熟练掌握BI工具(如Tableau、PowerBI或国内的神策数据、GrowingIO等),并能将业务问题转化为数据指标体系。
优化协作流程:解决“数据孤岛”与“需求黑洞”
数据仓库项目最大的痛点不是技术难题,而是沟通成本,业务部门想要什么,技术部门理解的是什么,往往存在巨大偏差。
建立统一的数据指标字典
“营收”这个词,财务看的是确认收入,销售看的是签约金额,运营看的是GMV,如果缺乏统一标准,数据就会打架,团队必须建立一份全员可见的《数据指标字典》,明确每个指标的计算口径、数据来源、更新频率和负责人。
实操建议
- 定期评审:每月召开一次指标评审会,由数据架构师牵头,业务方确认指标定义。
- 工具化落地:将指标字典嵌入到BI工具中,用户在选择指标时,直接看到定义和口径,减少重复沟通。
- 变更管理:任何指标口径的变更,必须经过审批并通知所有下游用户,避免“数据突变”引发信任危机。
推行“数据产品化”思维
不要被动响应取数需求,高效团队会将高频、通用的数据需求封装成标准数据产品或自助分析看板,将“每日销售报表”封装成一个自助BI看板,让业务人员可以通过筛选维度自行查看,而不是每次都要找数据工程师写SQL。
应对“北京地区数据仓库建设”的特殊性
在一线城市,尤其是北京地区,数据人才竞争激烈,且业务迭代速度极快,据行业观察,北京地区的企业往往对数据实时性要求更高,且合规要求更严格,在构建团队时,需特别注重数据安全和隐私保护能力的建设,确保数据采集和使用符合《个人信息保护法》等法规要求。

技术选型与基础设施:为未来留有余地
技术选型没有最好,只有最合适,团队需要根据自身发展阶段,选择灵活且可扩展的技术栈。
云原生架构的优势
近年来,越来越多的企业选择云原生数据仓库(如Snowflake、阿里云MaxCompute、腾讯云数仓等),其核心优势在于存算分离,弹性扩容,这意味着在双11等大促期间,可以瞬间增加计算资源应对高峰,而在平时则保持低成本运行。
选型对比参考
| 维度 | 传统本地部署 | 云原生数据仓库 |
|---|---|---|
| 初始投入 | 高(硬件采购) | 低(按需付费) |
| 运维复杂度 | 高(需专职DBA) | 低(厂商托管) |
| 扩展性 | 差(需停机扩容) | 好(秒级弹性) |
| 适用场景 | 数据敏感、合规要求极高 | 大多数互联网及传统数字化转型企业 |
数据治理:长期主义的胜利
数据治理不是一次性的项目,而是持续的过程,团队中应设立专门的数据治理角色,或由各角色兼职承担,治理的重点包括:元数据管理、数据质量监控、数据生命周期管理。
具体操作路径
- 元数据自动采集:利用工具自动采集表结构、字段注释、血缘关系,形成数据地图。
- 冷热数据分层:将3个月以上的历史数据迁移到低成本存储介质,提升查询性能并节省成本。
- 僵尸表清理:定期扫描使用频率低于阈值的表和字段,进行归档或删除,保持数仓整洁。
团队文化与人才成长:保持活力
技术更新迭代极快,团队必须保持学习能力。
建立内部知识库
鼓励团队成员分享技术心得、踩坑经验和最佳实践,通过Wiki或内部论坛,沉淀团队知识资产,新员工入职时,可以通过知识库快速上手,减少“重复造轮子”。
轮岗机制
鼓励数据工程师与数据分析师进行短期轮岗,工程师了解业务痛点,能写出更贴合需求的代码;分析师理解技术限制,能提出更可行的分析方案,这种跨界融合,能极大提升团队的整体效能。

激励机制
除了薪资,成就感也是重要的激励因素,设立“数据价值奖”,表彰那些通过数据分析直接带来业务增长或成本节约的团队和个人,让数据团队的工作成果被看见、被认可。
常见问题解答:数据仓库团队构建指南
数据仓库团队规模如何根据企业阶段配置?
初创期(0-1):建议配置1名全栈数据工程师和1名业务分析师,侧重快速搭建最小可行性数据平台(MVP),满足核心业务报表需求,成长期(1-10):引入专职数据架构师,拆分ETL开发与分析职能,建立初步的数据治理规范,团队规模扩展至5-10人,成熟期(10-100):细化角色,设立数据产品经理、数据治理专员、实时计算工程师等,团队规模可达20人以上,侧重数据资产化和智能化应用。
如何解决业务部门对数据准确性的质疑?
建立数据质量监控体系,对关键指标进行实时校验,确保数据无丢失、无异常,推行“数据溯源”机制,当业务方质疑数据时,能迅速提供数据来源、计算逻辑和加工过程的完整链路证明,保持透明沟通,定期发布数据质量报告,主动暴露问题并展示改进措施,逐步重建信任。
数据仓库团队如何衡量自身价值?
不应仅以“支持了多少个需求”来衡量,而应关注“数据驱动的业务结果”,核心指标包括:数据产品覆盖率(多少业务场景使用了自助分析)、数据需求响应时效(从提出到上线的时间)、数据准确率(业务投诉率)以及数据带来的直接业务增量(如通过用户画像分析提升的转化率),这些指标能更客观地反映团队对业务的实际贡献。
构建高效的数据仓库团队,是一场关于技术、流程与人的系统工程,只有将清晰的角色分工、标准化的协作流程、灵活的技术架构以及持续学习的文化有机结合,才能真正释放数据的力量,驱动企业持续增长。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/204792.html