


生产AI大模型系统并非单纯的技术堆砌,而是数据治理、算力调度与算法优化的系统工程,其核心在于构建从高质量语料清洗到模型微调、再到推理部署的全链路闭环能力。
很多人误以为训练一个大模型就是买几台显卡跑个代码,这其实是对技术复杂度的严重低估,真正的生产级AI系统,更像是一座精密运转的化工厂,每一个环节都需要极高的稳定性和可解释性,对于企业而言,选择自研还是采购,往往取决于业务场景的垂直深度和对数据隐私的敏感度。


生产AI大模型系统的核心架构拆解
要理解如何生产AI大模型系统,首先得打破“黑盒”思维,一个成熟的系统通常由四个关键层级组成,它们环环相扣,缺一不可。
数据基础设施层:质量的决定性因素
业内专家指出,数据质量直接决定了模型的上限,在2026年的今天,通用语料的红利已基本耗尽,竞争焦点转向了垂直领域的高质量数据。
- 数据清洗与去重:原始数据中充斥着大量噪声、重复内容和低质文本,高效的系统需要自动化流水线,利用规则引擎和轻量级模型进行初步过滤。
- 多模态对齐:现代大模型不再局限于文本,系统需具备处理图像、音频、视频的能力,这要求底层架构支持多模态数据的统一嵌入表示。
- 隐私合规处理:针对医疗、金融等敏感行业,系统必须内置差分隐私或联邦学习模块,确保在数据不出域的前提下完成模型训练。
算力调度与工程层:效率的关键
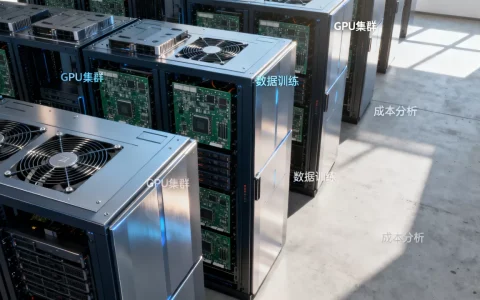
算力是AI生产的燃料,但如何高效使用燃料才是技术难点。
- 异构算力兼容:生产环境往往混合使用NVIDIA、AMD甚至国产AI芯片,系统需要具备底层硬件抽象能力,屏蔽不同芯片的指令集差异。
- 分布式训练优化:采用ZeRO等显存优化技术,结合通信压缩算法,解决千卡集群下的通信瓶颈。
- 弹性伸缩机制:根据训练任务负载,动态分配GPU资源,避免算力闲置或过载。

算法与模型层:智能的核心
这是最容易被误解的部分,生产级系统通常不从头预训练,而是基于开源基座进行微调。
- 指令微调(SFT):通过构建高质量的指令数据集,让模型学会遵循人类意图,这一步骤比预训练更耗时,因为需要人工标注和RLHF(人类反馈强化学习)。
- 参数高效微调(PEFT):如LoRA技术,仅训练少量参数即可适配特定任务,大幅降低算力成本。
- 思维链(CoT)构建:在数据中注入推理步骤,提升模型在复杂逻辑任务中的表现。
推理与服务层:落地的最后一公里
模型训练完成只是开始,如何让用户稳定使用才是关键。
- 高并发处理:采用vLLM等推理引擎,优化KV Cache管理,提升吞吐量。
- 模型量化:通过INT8或INT4量化,减少显存占用,使大模型能在边缘设备或普通服务器上运行。
- API网关与监控:实时追踪Token消耗、响应延迟和错误率,确保服务SLA。
企业构建AI能力的路径选择与成本考量
面对高昂的技术门槛,企业通常面临两条路径:自研或采购,这不仅是技术选择,更是商业决策。
自研模式的适用场景与风险
自研适合拥有独特数据资产且对定制化要求极高的企业,如大型金融机构或头部互联网平台。

- 数据壁垒:只有自研才能确保核心业务数据完全私有化,避免泄露风险。
- 深度定制:可根据特定业务逻辑调整模型架构,例如在医疗诊断中融入特定的医学知识图谱。
- 长期成本高:初期投入巨大,包括硬件采购、团队组建和持续迭代,据统计,组建一个百人规模的AI工程团队,年度运营成本通常在数千万元级别。
采购与云服务模式的性价比分析
对于大多数中小企业,直接调用API或购买私有化部署方案更为现实。
- 快速上线:无需等待漫长的训练周期,几天内即可集成智能客服或内容生成能力。
- 维护成本低:底层基础设施由云厂商维护,企业只需关注应用层开发。
- 灵活性受限:模型黑盒特性可能导致不可控的输出,且在极端长尾场景下效果不如自研模型。
混合架构:平衡之道
越来越多的企业选择“云边结合”的混合模式,通用能力使用云端大模型API,敏感或实时性要求高的任务部署本地小模型,这种架构既保证了智能水平,又兼顾了数据安全和响应速度。
2026年生产AI大模型系统的实战建议
技术迭代迅速,但底层逻辑不变,以下是基于行业共识的实操建议,帮助团队避开常见陷阱。
第一步:明确业务边界,拒绝大而全
不要试图训练一个“什么都会”的通用模型,从具体痛点入手,自动提取合同关键条款”或“生成个性化营销文案”,聚焦细分场景,数据更容易获取,效果评估也更清晰。
第二步:建立数据飞轮,持续迭代
模型上线不是终点,而是起点。
-

收集反馈
:在应用中嵌入用户点赞/点踩机制,收集真实交互数据。 - 主动学习:利用不确定性采样,挑选模型置信度低的样本进行人工标注,补充训练集。
- 定期重训:根据数据分布漂移情况,每季度或半年对模型进行增量更新。

第三步:重视安全与伦理合规
随着监管趋严,AI安全已成为生产系统的标配。
- 内容过滤:部署敏感词过滤和价值观对齐模块,防止生成违规内容。
- 水印技术:为生成内容添加数字水印,便于溯源和版权保护。
- 红队测试:定期邀请安全专家进行对抗性攻击测试,发现潜在漏洞。
常见问题解答
生产AI大模型系统需要多少启动资金?
启动资金取决于规模,若采用云服务API调用,初期成本可控制在数万元以内,主要用于应用开发,若选择私有化部署开源模型,需考虑服务器租赁或购买费用,通常数十万至百万级,若从头预训练千亿参数模型,则需千万级以上的算力投入和专业的算法团队支持。
自研大模型与调用API有什么区别?
自研大模型拥有数据主权和深度定制能力,适合核心业务场景,但研发周期长、维护成本高,调用API则开箱即用,迭代速度快,适合非核心业务或快速验证场景,两者并非互斥,企业可根据业务重要性分层使用。
如何解决大模型幻觉问题?
幻觉是大模型固有缺陷,可通过多种手段缓解,一是引入检索增强生成(RAG),让模型基于外部可信知识库回答;二是优化提示词工程,明确约束生成范围;三是使用知识蒸馏技术,将小模型的确定性知识注入大模型。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/376875.html



评论列表(1条)
大厂卷了三年,这帮人光谈数据治理,不提算力调度有多坑。我为了调个参头发都快掉光了,还低成本?哈哈同款社畜,懂的都懂。