考试季题库随机组卷的高并发读优化,核心在于把热点数据尽可能推向离用户最近的位置,采用“本地缓存+Redis+CDN”三级加速,同时配合读写分离与熔断降级,才能稳稳扛住短时间内的流量冲击。
考试季一到,题库系统就像被按下了快进键,考生刷题、模拟考、正式组卷,海量请求几乎在同一时段涌进来,随机组卷和普通读接口不一样,每次请求的题目组合都可能不同,这给缓存设计带来了不少麻烦,很多团队平时觉得系统够快,一到考试季就出现接口超时、数据库连接打满,甚至整个服务宕掉,这篇文章就把组卷读优化的关键路径拆开讲清楚。

高并发读的瓶颈到底卡在哪里?先看清家底
随机组卷的请求链路并不复杂:用户发起组卷请求 → 服务端从题库里随机取题 → 组装试卷 → 返回结果,看起来简单,实际压力都在“随机取题”这一步,题库数据量大、题目属性多(学科、题型、难度、知识点覆盖度),如果不做任何优化,每次请求都去数据库执行全表扫描加随机排序,数据库会非常吃力。
随机组的“随机”才是优化的大敌
常规缓存通常是key-value按ID取数据,但随机组卷每次返回的题目集合都不一样,无法直接缓存最终结果,业内专家指出,解决这个问题的核心思路是“把随机范围变小,把确定部分缓存起来”,比如把题库按学科分成N个片,每个片内先缓存题目ID列表,再从ID列表里用本地随机算法选出题目ID,最后按ID批量取题目内容,这样缓存命中率会高很多,因为题目ID列表的变化频率远低于题目本身。
考试季流量特征:短时脉冲,读写比例失衡
考试季的流量规律非常明显,开考前后几分钟内并发量突然拉升,之后缓慢回落,据公开技术社区分享,在线考试系统的读请求占比通常在九成以上,写请求只有交卷、成绩上传等少量操作,行业共识认为,高并发读优化的优先级远高于写优化,读路径上任何一层没有扛住,就会拖垮整个链路。
题库系统缓存策略:Redis与本地缓存的分层实践
缓存层级的核心逻辑很简单:越靠近用户的层,速度越快、容量越小;越靠后的层,容量越大、速度稍慢,对题库系统来说,常用的三级缓存是本地缓存、Redis集群和CDN,下面分别聊聊每一层怎么设计。
第一级:本地缓存挡住最热的题面包
本地缓存(如Caffeine、Guava)存在于应用服务器内存中,延迟是纳秒级,它适合存放被反复命中的热点题目,比如高频考点题、必考题、经典错题,缓存容量不需要太大,几百MB就够,每个节点只存一部分热点即可,需要注意的是,本地缓存的一致性维护成本较高,题库系统发布新题或修改题目时,可以通过版本号或广播消息通知各节点清空本地缓存,否则会出现“老题库还在线上”的尴尬情况。
第二级:Redis集群扛住大规模随机读
Redis是题库读优化的中坚力量,用Redis Cluster分片存题目信息,key设计成question:{bankId}:{questionId},value建议用JSON或压缩后的二进制格式,对于随机组卷,可以先把每个分片的题目ID列表缓存到Redis,比如srand:{bankId}:{subjectId},列表里只存ID和权重,每次组卷时从Redis取ID列表,在本地用加权随机算法选出需要的ID,再通过mget或pipeline批量取题目内容,这样一次组卷请求只产生两三次Redis读取,而不是几百次。
| 缓存层级 | 访问延迟 | 容量 | 一致性维护成本 | 推荐场景 |
|---|---|---|---|---|
| 本地缓存 | 纳秒级 | 小 | 高 | 高频热点题、卷子模板 |
| Redis集群 | 毫秒级 | 大 | 中 | 全量题目内容、ID列表 |
| CDN | 取决于网络 | 很大 | 低 | 预生成试卷、静态资源 |
缓存穿透、击穿、雪崩的应对
考试季流量大,恶意请求或无效参数很容易打穿缓存,三个经典问题都得提前做好预案。
- 穿透:请求的题目ID根本不存在,缓存和数据库都没有,用布隆过滤器提前拦截无效ID,或者在缓存里存空值(注意设置极短TTL)。
- 击穿:某个热点key在过期瞬间被大量请求同时打到数据库,用互斥锁(Redis SETNX)让只有一个请求去重建缓存,其他请求短暂等待或返回降级内容。
- 雪崩:大量key同时过期导致数据库压力骤增,过期时间加随机偏移,比如基础TTL 30分钟,实际设为30分钟+0到5分钟随机值。
组卷接口性能优化:从SQL到分库分表的进阶路径
缓存给力,数据库压力依然存在,因为缓存永远有冷启动和过期时刻,数据库必须能兜底,如果数据库层不做优化,高并发一来照样挂。
读写分离:主库只写,从库只读
把题库的读和写彻底分开,主库负责题目维护、成绩写入,从库负责组卷读取,部署上至少一主两从,从库可以横向扩展,考试季期间,把组卷请求全部路由到从库,主库负载几乎为零,很多团队担心主从同步延迟,实际上题库数据的同步延迟一般在毫秒级,对出题几乎没有影响。
分库分表:按学科或租户拆分题库
题库表数据量动辄千万级甚至上亿,单表查询很难快起来,分片方式建议按学科(bank_id)或者按租户(学校/机构)拆分,例如把数学题库、英语题库拆到不同库,这样随机组卷的SQL天然只命中一个分片,避免跨库扫描,分片后要注意随机策略不能破坏公平性,可以在每个分片内部先随机选出候选题目,再汇总拼接。
SQL层避免深分页和高成本排序
很多团队的组卷SQL还在用ORDER BY RAND(),这会让数据库全表扫描并生成临时表,数据量一大必然超时,正确的做法是:
ID列表,用随机偏移量定位起始位置,比如WHERE id > 随机值 ORDER BY id LIMIT 200,再从中过滤和排序。
- 或者干脆不用SQL随机,把题目ID和权重提前加载到Redis或本地内存,在代码里完成随机选择。
- 无论哪种方式,都应该为
bank_id、subject_id、status建立联合索引,确保过滤和排序都走索引。
静态化与CDN:把题库边缘化,离用户更近
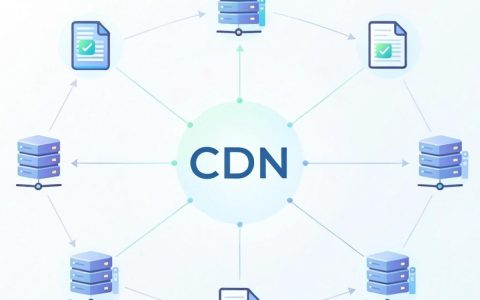
考试季里大部分流量是重复的、可预测的,比如同一场模拟考试,所有考生做的是同一套随机规则下的试卷,这时候没有必要让每个请求都打到应用服务器,可以用静态化把压力转移到CDN。
预生成试卷包:把随机变成“伪随机”
在流量高峰来临前,按考试规则预生成一批试卷,每套试卷由固定比例的题目组成,把这些试卷以JSON或HTML格式存到对象存储,再推送到CDN,用户请求时,根据用户ID或考试场次哈希到某一份预生成卷,直接返回,这样既保留了随机组卷的多样性,又避免了实时计算,为了防止考生互相传答案,可以在一份预生成卷中加少量动态题目,或者把题目的顺序打乱,以简单成本换来安全性。
CDN缓存策略:给静态资源设置短TTL
预生成试卷包的TTL不需要太长,10到15分钟就够了,考试季核心时段,可以设置更短,避免泄题风险,CDN的缓存在边缘节点上,离用户最近,回源率很低,加上URL版本号(例如/papers/exam2026/math/v3/paper_001.json),一旦题库有调整,直接换版本号即可,近年来的实践表明,CDN能承接相当大的流量占比,应用服务器只需要处理少量动态请求,整体稳定性明显提升。
高并发模拟压测:验证优化效果的实操方法
优化做得对不对,不能靠感觉,要压测,考试季之前必须做全链路压测,模拟真实考生行为,把缓存命中率、数据库连接数、接口时延都测一遍。
压测工具选型:JMeter与wrk对比
- JMeter:图形化界面,灵活定义路由、参数和断言,适合复杂业务流程,比如注册、登录、随机组卷、交卷的完整链路。
- wrk:命令行工具,安装简单,适合单接口吞吐量测试,比如压测组卷接口:
wrk -t8 -c200 -d30s http://your-api/random-paper-t表示线程数,-c表示并发连接数,
-d
如果压力机资源有限,可以同时多台机器压一个入口,但要记录总QPS,保证数据准确。
压测前中后的关键指标
- 吞吐量(TPS):每秒成功组卷的请求数,这是系统能力的直接体现。
- P95时延:95%的请求在多少毫秒内返回,考试场景下,P95建议控制在500ms以内,超过1秒就很影响体验。
- 错误率:压测期间5xx和超时占比,应该低于0.1%。
- Redis命中率:正常情况下应超过90%,如果低于70%,说明缓存设计有问题。
- 数据库慢日志:压测中要同时抓慢查询,有没有出现全表扫描或临时表排序的SQL。
容量评估与限流降级
压测得到单节点TPS之后,乘以集群节点数,再留出30%到40%的冗余,就是考试季需要准备的容量,同时要在网关层配置限流,比如每接口每秒最多2000次,超出的请求直接返回“稍后再试”或者排队,护航阶段还要开启熔断策略(如Sentinel或Hystrix),当依赖的Redis或数据库异常时,快速降级到预生成试卷或静态题库,保护核心体验。
考试季题库随机组卷的高并发读优化,本质上是一场缓存分层、数据拆分和流量治理的综合实践,没有一劳永逸的方案,但把热点数据提前缓存、把文档性的内容推到CDN、把数据库从查询压力中解放出来,就能让系统在流量洪峰中从容应对。
Q&A:考试季题库随机组卷与高并发读优化常见疑问
随机组卷能不能完全靠缓存解决?
不能,缓存能解决大部分重复读压力,但随机组卷的“随机”特性决定了每次要动态做组合,完全靠缓存会导致命中率低,缓存价值大打折扣,更合理的方式是缓存题目ID和题目内容,把随机逻辑放在服务端内存中,再配合预生成试卷兜底。
Redis缓存和本地缓存各适合存什么?
本地缓存适合存热点中的热点,比如高频必考题、考试场次信息、试卷模板,容量小但访问极快,Redis缓存适合存全量题目内容、题目ID列表、用户临时会话状态,容量大且支持集群扩展,两者配合使用时,要注意更新顺序:先更新Redis,再异步清理本地缓存,避免一致性问题。
考试季高峰期数据库连接池怎么调整?
从库连接池可以适当调大,因为读请求数量远大于写请求,建议从库最大连接数设为主库的2到3倍,同时设置连接等待超时,比如500毫秒,应用层应该使用连接池监控工具,压测时观察空闲连接和等待线程数,找到合理阈值,不应盲目调大导致数据库本身资源耗尽。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/768393.html