虚拟机共享板卡实现高效资源隔离与性能保障,核心答案是:采用SR-IOV或硬件辅助虚拟化方案细分物理资源,配合驱动层的显存/算力隔离与实时监控,在损耗可控的前提下做到互不干扰。
很多朋友第一次接触虚拟机共享板卡时,想的都是“能不能省钱”,省钱当然没错,可如果只图便宜不看隔离方案,后面你可能会被性能抖动、显存溢出、驱动冲突折磨到怀疑人生,下面就把这条技术路径掰开揉碎,从方案对比到实操细节一次讲透。
虚拟机共享显卡性能损失大吗?先看清三种隔离方案
这个疑问几乎每个入门者都问过,直接给结论:损失大小完全取决于你用哪种隔离方案,选错了可能损失三成以上,选对了可以逼近裸机,主流方案有三条路。
PCIe直通:性能最实但隔离最“硬”
直通就是把物理板卡完整分配给某个虚拟机,由虚拟机独占整块卡的所有资源,优点很明显:性能几乎不损耗,也不存在邻居虚拟机抢占资源的问题,缺点也很拧巴,一块卡只能服务一台虚拟机,如果虚拟机只有轻负载任务,物理卡大部分算力就闲着,这种方案适合对性能极度敏感、且虚拟机数量少的场景,比如做低延迟交易系统。
SR-IOV硬件虚拟化:一块卡拆成多张“虚拟卡”
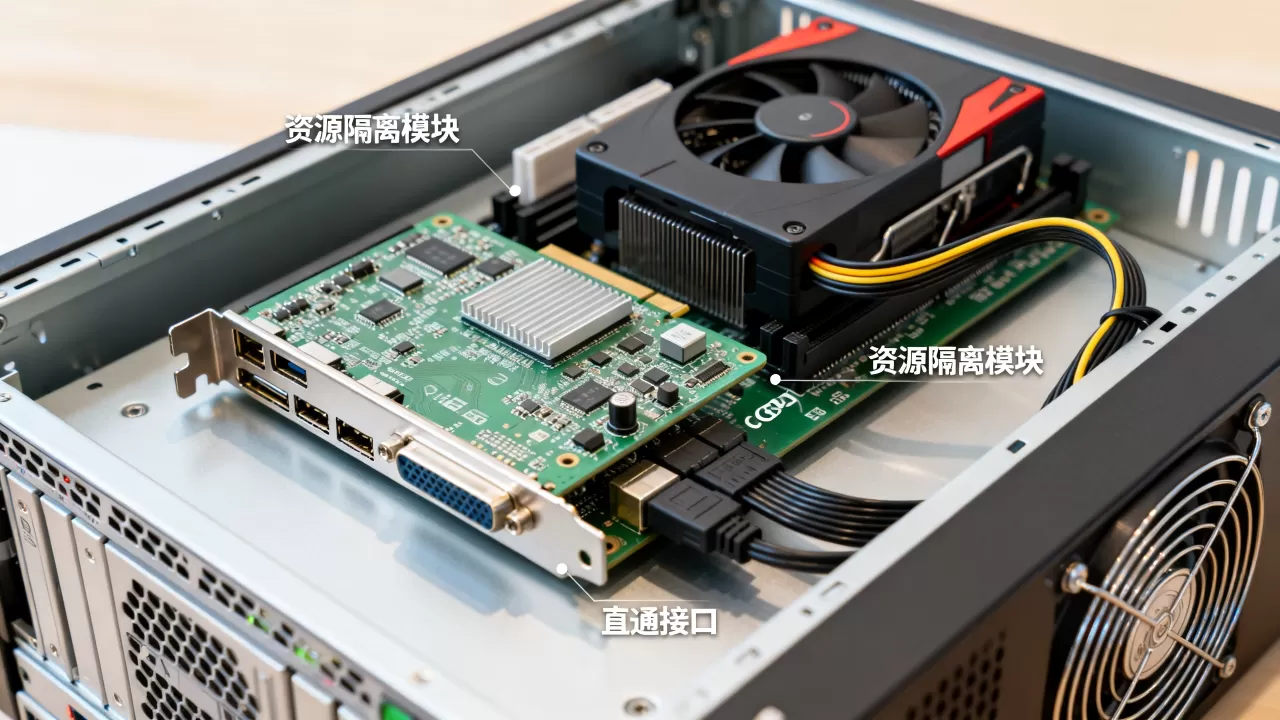
SR-IOV通过板卡硬件的虚拟化引擎生成多个虚拟功能,每个虚拟功能都有独立的DMA通道、中断队列和显存窗口,虚拟机看到的是一张实实在在的卡,实际却在共享物理板卡,现在主流网卡和GPU(如NVIDIA vGPU)都走这条路线,它的优势在于硬件层面切隔离,互相影响较小,性能损耗也低于纯软件方案,需要注意的是,虚拟化功能得靠厂商授权和驱动配合,部分板卡需要额外购买许可。
软件层vGPU/Mdev:灵活但开销要算清楚
当硬件不支持SR-IOV时,就走软件模拟,宿主机驱动把物理板卡切割成多个虚拟设备,每个虚拟机分到一块虚拟GPU,通过修改驱动层来限制算力和显存,配置非常灵活,但代价是每次虚拟化都要经过软件转发,延迟和吞吐都会打折扣,行业共识认为,这种方案更适合开发测试、云桌面这类低敏感场景,高并发生产环境建议优先用SR-IOV。

| 隔离方案 | 隔离粒度 | 性能损耗 | 典型应用 |
|---|---|---|---|
| PCIe直通 | 物理卡独占 | 几乎无 | 高性能计算、低延迟业务 |
| SR-IOV | 虚拟功能隔离 | 较低,约小个位数 | GPU训练、云游戏、NFV |
| 软件vGPU | 驱动层显存/算力分片 | 较高,多任务易抖动 | 桌面虚拟化、功能测试 |
性能保障的关键:隔离粒度与调度策略
选好方案只是起点,真正拉开差距的是隔离粒度和调度策略,也就是说,你得让每个虚拟机拿到的显存和算力都有边界,同时还能灵活让出资源给高优先级任务。
显存隔离怎么做到不互相干扰
先解决“吃显存”的问题,以NVIDIA vGPU为例,在宿主机上创建虚拟GPU时,可以给每个虚拟机指定显存大小,比如从一张48GB的A6000切出6块6GB的虚拟GPU,实际操作中你可能会遇到某个虚拟机申请超过配额的显存,这时候驱动有两种反应:一是直接报错,二是偷偷借用其他虚拟机的显存,生产环境务必设置成严格模式,宁可用完报错,也不要让邻居的数据被挤掉,检查隔离状态时可以用nvidia-smi -q看每个实例的显存限制,配合vGPU_util和vGPU_fb_total指标定期盯防。
算力分配:别让一个任务饿死其他虚拟机
显存隔离相对容易,算力隔离才是难点,同一张物理卡上跑着好几个虚拟机,一个训练任务可能把GPU核心全部占满,其他虚拟机瞬间卡成PPT,解决办法是设置算力份额,例如通过云平台管理工具给每台虚拟机配置百分比上限,在KVM环境中,可以使用cgroup的cpu.cfs_quota_us参数限制虚拟机的CPU时间,同时在GPU驱动层用time-sliced模式轮转,另外推荐开启板卡自带的QoS功能,很多商用虚拟化方案都支持最小算力与最大算力双阈值,保证每个虚拟机至少拿到基础算力。
排队与抢占:生产环境必须考虑的调度机制
上面解决了空间隔离,时间维度也不能忽略。当一个物理GPU同时服务多个高负载虚拟机时,调度器会按时间片切分算力,优先级低的虚拟机可能会长期饥饿,所以你要设置抢占策略,让高优先级任务可以中断低优先级任务,但要给低优先级任务设定最长等待时间,以免它永远跑不完,调度器日志里要记录抢占次数,如果某个虚拟机频繁被抢占,说明你分配的算力份额和实际业务不匹配,需要重新规划。
场景化调优:AI训练、云游戏与FPGA共享
不同业务对隔离和性能的容忍度完全不一样,下面按三类常见场景说下实操侧重点。
AI训练场景:显存与带宽优先
训练任务最怕的是显存不够和卡间通信慢,共享板卡时优先选择支持SR-IOV的高端GPU,因为它的显存通道是独立隔离的,不容易受到其他虚拟机的带宽争抢,如果你用的卡支持NVLink,一定要把同一条NVLink链路上的vGPU分配给同一个训练任务,否则跨通信会让训练时间翻倍,训练过程中用nvidia-smi topo -m查看拓扑关系,确保虚拟GPU分布在最优的NVLink组内。
云游戏场景:延迟敏感怎么办
云游戏玩家对鼠标键盘输入到画面响应的延迟极度敏感,这时候虚拟机共享板卡要尽量缩短数据链路,推荐使用直通或者SR-IOV,避免软件层vGPU带来的额外延迟,另外建议给云游戏虚拟机开启实时调度,并关闭宿主机后台的图形化界面,减少抢占,实测下来,多数情况下软虚拟化方案的延迟会比SR-IOV高出一个可感知的档位。
FPGA板卡共享:比GPU更看重隔离
FPGA比GPU更需要资源隔离,因为FPGA逻辑通常直接操作内存区域,遇到恶邻可能直接导致逻辑错误,目前常用做法是使用PCIe的物理功能分区,配合FPGA厂商的虚拟化IP核,把逻辑资源划分成独立区域,操作上要注意,每个分区的bitstream必须独立加载,且DMA地址空间必须隔离,否则缓冲区溢出会影响整个物理板卡。
北京GPU服务器虚拟化价格与性能怎么平衡
有朋友习惯在搜索引擎里带上地域词,因为不同地区IDC的虚拟化方案价格差异蛮大,以北京为例,你可能会问“北京GPU服务器虚拟化价格多少”,其实没有统一答案,计价方式主要看三个维度:

- 物理卡型号:A100、H20这类高端卡共享价格远高于消费级卡;
- 虚拟化粒度:按单个虚拟GPU计费还是按整卡独享计费,价格能差出好几倍;
- 管理与支持:带独立调度平台、实时监控服务的方案通常要加服务费。
业内专家指出:选北京机房时一定要问清网络和板卡物理位置,很多低价共享板卡方案没有可用的BGP带宽,业务换来的延迟反而把便宜价格抹平了,建议先用短租方式试运营,跑一周业务看性能曲线,再决定是否长期采购,如果你在北京做GPU虚拟化,优先找支持SR-IOV且能提供故障转移的云服务商,别为省几块钱去碰裸vGPU。
Q&A:虚拟机共享板卡资源隔离与性能保障常见问题
问:虚拟机共享显卡和独享显卡性能差多少?
答:要看隔离方案,PCIe直通几乎没有损耗,SR-IOV在多数场景下性能损耗可忽略,而软件vGPU在图形渲染和并发任务下损耗比较明显,如果你跑的是AI推理这类高吞吐任务,建议至少用SR-IOV;如果是云办公办公场景,软件vGPU也够用,核心是确认你的业务瓶颈到底在显存还是算力。
问:vGPU隔离失败时会有哪些异常表现?
答:最典型的是显存分配溢出,虚拟机会出现图形撕裂或驱动报错,日志里能看到vGPU failed to allocate memory之类的提示,算力隔离失败则表现为多虚拟机同时高负载时,所有虚拟机性能集体下降,且个别虚拟机出现高延迟,排查优先级依次是驱动版本、虚拟化配置、宿主机BIOS设置。
问:有没有开源工具能自己做资源隔离和监控?
答:有,管理层面可以使用Libvirt的virsh命令动态调整虚拟机的最大内存和CPU份额;监控层面可以用Prometheus的nvidia_gpu_exporter主动拉取GPU指标,配合AlertManager设阈值告警,如果你用Kubernetes管理虚拟机,还可以部署NVIDIA的device plugin插件,让K8s根据显存和算力自动调度虚拟GPU实例,这套方案能覆盖大部分隔离与监控需求,但仍需要你理解底层的驱动模型。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761762.html