训练推理类负载,训练阶段建议优先考虑专用GPU实例,推理阶段则要分场景平稳高吞吐流量选专用实例,突发性强、空闲率高的推理任务用函数计算更划算。这个结论不是拍脑袋,而是从任务形态、资源利用率和计费逻辑三个维度推出来的,下面展开聊清楚,帮你少走弯路。
训练为什么离不开专用实例
训练任务的特性决定了它几乎无法被函数计算的架构优雅承接,这不是谁不够好,而是两者的设计目标相差太远。


训练是长跑,不是冲刺
一次模型训练通常要跑几百上千个epoch,每个epoch又包含前向传播、反向传播、参数更新三个步骤,整个过程可能持续几小时甚至几天,函数计算平台对单次请求有超时限制,虽然云端GPU函数正在逐步放宽这个限制,但长时间稳定运行的训练任务依然更适合跑在专用实例上毕竟我们不需要为了触发一次训练请求去关心“还剩几分钟超时”。
断点续训和分布式通信是硬门槛
训练过程中宕机、断网、OOM几乎是家常便饭,所以成熟训练框架都依赖断点续训机制,定期保存checkpoint,出问题后从最近一次ckpt恢复,在专用实例上,这个流程很自然:挂载持久化存储,重启实例后直接加载ckpt继续跑,但函数计算的实例是短生命周期、可被随时回收的,框架层面对这种“随时可能被杀死”的场景支持并不友好。
多卡分布式训练需要高频的梯度同步通信,集体通信库要求GPU实例之间拥有低延迟、高带宽的互联通道,并且要稳定存在于同一个集群内,函数计算虽然也在提供GPU实例,但实例的调度、组网和专用训练集群相去甚远,行业共识认为,单机多卡或跨机分布式训练,主流方案依然是包年包月或按量付费的GPU裸金属/虚机。
函数计算和GPU专用实例选型对比:推理场景的分水岭
推理任务就不一样了,推理的“重量级”远低于训练,弹性要求却高得多,这正是函数计算的舒适区,放哪个平台,关键看流量画像。
平稳流量推理更适合专用实例
如果你负责的是一个对外提供稳定API的推荐模型:每天流量在固定区间波动,并发峰值可以提前预估,且服务等级协议要求P99延迟稳定在几十毫秒或百毫秒级,这种情况下,专用GPU实例合适得多。
原因是函数计算在冷启动时会有额外延迟,即使平台已经通过镜像预热、沙箱复用等手段把冷启动时间压缩到秒级甚至毫秒级,但相比“常驻实例+连接池复用”的专用部署,性能稳定性还是不够极致,对于在线服务,每一次超时都意味着用户流失和真金白银的损失。
这类负载适合的部署方式是:买一台或几台固定配置的GPU云服务器,用容器或Kubernetes托管推理服务,配合负载均衡把流量打散,架构简单,排查问题直接登录到机器上看日志,不用跟平台的调度机制绕弯子。
突发与碎片化推理任务:函数计算的真正主场
另一种典型场景是:你有一个内部工具,团队十几个人偶尔上传图片做一些分类推理;或者你运营一个电商小程序,大促期间流量瞬间冲到日常的十倍,大促结束又归于平静;又或者你是一个独立开发者,做一个AI绘画应用,用户活跃时间集中在晚上8点到11点。
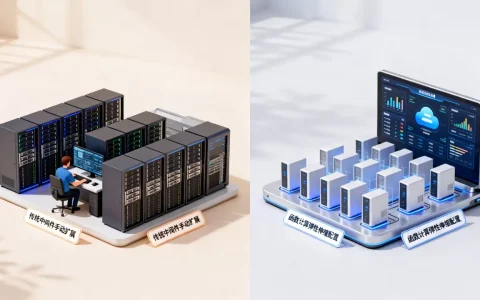
这类场景用专用实例,要么日常闲置浪费钱,要么高峰期扩容来不及,运维上要预留GPU库存、配置弹性伸缩组、写各种定时策略,麻烦得很。
函数计算的价值就在这里:
- 请求来了自动拉起GPU实例,请求结束自动缩零,不用操心容量管理
- 冷启动的几秒延迟对非实时任务(比如异步图片处理)完全没影响
- 计费粒度细化到请求数和执行时长,没有流量就没有费用
两者对比一览:
| 维度 | 函数计算(GPU) | 专用GPU实例 |
|---|---|---|
| 计费粒度 | 按调用次数+执行时长 | 按秒/小时/包年包月 |
| 弹性伸缩 | 毫秒级自动扩缩,支持缩零 | 手动或伸缩组,分钟级 |
| 冷启动 | 存在,秒级优化空间 | 无(常驻进程) |
| 延迟稳定性 | 受冷启动影响,适合非实时 | 高,适合在线服务 |
| 运维开销 | 几乎为零 | 需处理镜像、驱动、监控告警 |
| 适合负载 | 突发型、碎片化、低频 | 持续稳定、高吞吐 |
模型推理用函数计算还是GPU实例,成本账要分开算
除了流量特征,成本是选型时最敏感的因素。“函数计算和GPU服务器哪个划算”这个问题没有标准答案,取决于你的实际用量和峰值倍数。
按量付费的核心逻辑:用多少付多少
函数计算的计费模型是:GPU实例规格单价 × 实例运行时长 + 调用次数费用,这个时长是实例从拉起服务到处理完请求的实际运行时间,精确到毫秒级,也就是说,如果一个推理请求从进入到返回总共消耗了3秒的GPU,那么你就为这3秒付费。
举个例子,你有一个Batch推理任务,每天需要处理一万张图片,单张图片推理耗时约0.5秒,用函数计算跑,每天累计的GPU执行时长大概是5000秒,也就是约1.4小时,一个月下来GPU成本大约42小时。
这类低频任务用函数计算,月度成本可能只有专用实例包月费用的零头。
反过来,如果模型每天被调用10万次,每次也耗时0.5秒,那么累计执行时长约13.9小时/天,一个月就是417小时,这个用量级别,函数计算的按量费用会迅速逼近甚至超过一台包月GPU实例的价格,而且专用实例还提供了一定的并发处理能力,同样的吞吐用一台实例就能扛住。
函数计算推理部署每日多少费用,看这两个数字
想估算函数计算推理的日费用,只需要盯住两个数字:单次请求的平均执行时长和日请求总量。
具体操作路径如下:
- 先在生产环境用压测工具(如简米云性能测试PTS或wrk)逼出单次请求的P95执行时长
- 再根据业务预测或历史日志统计出日请求总量
- 用两数相乘得到日GPU用量,再乘以对应GPU规格的单价,得到日均费用
另外一个容易被忽略的坑是冷启动期间的计费,虽然这段时间没有业务请求,但平台从镜像仓库拉取镜像、启动容器、初始化CUDA环境,都是算在执行时长里的,因此对于单次执行时长非常短的请求,比如只有50毫秒,冷启动成本占比会非常高,导致实际单价看起来比预期贵,解决办法是对这类模型启用平台的预留并发能力,提前预热若干实例,牺牲少量闲置费用来换取启动开销的降低。
地域选择影响最终价格
不同地域的GPU资源价格有差异,以国内主流云厂商为例,上海地区的GPU实例供应量相对充足,价格通常低于一些边缘地域,如果你对数据合规性没有严格的地域约束,又希望控制成本,可以先对比一下华东、华北、华南几个主要地域的函数计算GPU定价,部分地域还有针对函数计算的新用户免费额度,可以先把业务跑通再决定长期部署位置。
决策流程:给一个简单的判断框架
与其拿着问题苦苦纠结,不如套用下面这套逻辑走一遍:
- 需求是全天的、稳定的在线API服务吗?→ 是,走专用实例
- 有严格的P99延迟要求且低于500毫秒吗?→ 是,走专用实例
- 需要多卡分布式推理或模型并行吗?→ 是,走专用实例
- 已经是低频或弹性波动任务,且能容忍秒级冷启动吗?→ 试试函数计算
- 运维人力不足,不想处理GPU驱动、容器编排和弹性伸缩组吗?→ 函数计算能省一只团队的手
实操:在函数计算上部署一个推理服务
以一个基于PyTorch的图像分类模型为例,流程如下:
- 将模型文件连同依赖打包为OCI镜像,推到容器镜像仓库
- 在函数计算控制台创建GPU函数,选择GPU实例规格(显存、算力按需选择)
- 在“运行时配置”中设置请求处理入口,比如加载模型的handler函数
- 配置环境变量,包括模型路径、并行线程数等
- 上传1-2张测试图片验证推理结果,同时启用日志查询功能监控耗时
- 如需保障稳定时延,在“弹性伸缩策略”中配置预留实例数量,建议预留1-2个实例覆盖冷启动高峰
整套流程大约需要半天到一天的时间,远比搭建自建推理服务的Kubernetes集群要快。
怎么选取决于你的负载画像
回到最初的问题,答案其实明确:训练任务放到函数计算里不现实,推理任务则要对照流量特征做选择。在线、稳定、低延迟场景,认准专用GPU实例;突发、低频、碎片化推理场景,函数计算的按量付费和极简运维是真正的解药。 没有哪个方案绝对正确,找到符合自己负载画像的技术方案,才是最优解。
函数计算与专用实例选型常见问题
函数计算可以跑模型训练吗?
少量轻量级的模型微调、小规模数据集的训练实验,可以用函数计算跑通,但大规模的正式训练不建议,函数计算实例的存储是临时性的,训练产生的checkpoint需要自动同步到对象存储或NAS,否则实例释放后数据即丢失,分布式训练需要实例之间的高速通信,函数计算的网络架构对此支持较弱,如果只是跑一个经验证的脚本,函数计算可以救急,但不可作为训练主力。
函数计算推理部署价格高不高?
价格高低取决于调用量和平均执行时长,一天累计GPU使用时间只有几小时的碎片化任务,函数计算的月账单远低于包月专用实例,一个每日请求量数万次、单次执行秒级以内的推理服务,按量付费的月度费用大约和一台入门级GPU专用实例的包月价格相当或更低,大多数实践表明,利用率低于30%的GPU任务适合用函数计算,高于这个阈值则包月实例更划算。
函数计算支持GPU实例做AI绘画或语音合成吗?
支持,主流云厂商的函数计算平台已经提供多尺寸的GPU实例规格,常见的Stable Diffusion文生图、Whisper语音识别、TTS语音合成模型都能直接部署,部署时需要注意镜像内需包含CUDA运行时和对应的Python依赖库,首次冷启动拉取大尺寸镜像耗时较长,建议为这类模型设置预留实例预算,通过函数计算跑AI绘画,高峰期并发弹性扩展、闲时缩到零实例,对于个人开发者和中小企业控制成本非常有效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/636391.html