


AI打大模型并非简单的技术堆砌,而是通过提示词工程、私有数据微调与RAG架构组合,实现从通用对话到垂直领域专业决策的跨越。
很多人对“AI打大模型”存在误解,以为只要注册个账号、输入几个字就能解决所有问题,2026年的AI应用已经进入了深水区,通用的基础大模型就像是一个博学但缺乏行业经验的实习生,它能写诗也能编程,但在医疗诊断、法律合同审查或精密制造流程优化上,往往会出现“幻觉”或逻辑断层,真正的“打”法,不是对抗,而是驾驭,你需要通过特定的技术手段,把这个实习生变成某个领域的资深专家。

提示词工程:从闲聊到精准指令的跃迁
提示词(Prompt)是与大模型沟通的语言,在2026年,简单的“你好”或“帮我写篇文章”已经无法激发模型的最大潜力,业内专家指出,高质量的提示词结构直接决定了输出结果的可用性。
结构化提示词的构建逻辑
有效的提示词通常包含四个核心要素:角色设定、背景信息、任务描述和约束条件,这种结构能显著降低模型的认知负荷。
- 角色设定:明确告诉模型它是谁。“你是一位拥有10年经验的资深数据分析师”,而不是模糊的“帮我分析数据”。
- 背景信息:提供必要的上下文。“这份数据来源于某电商平台的用户行为日志,包含点击率和转化率”。
- 任务描述:清晰界定要做什么。“请识别出转化率低于5%的用户群体,并分析其主要流失原因”。
- 约束条件:规定输出的格式、长度和风格。“请以Markdown表格形式输出,仅列出前三项关键因素,语气保持客观专业”。
实战场景:营销文案生成
假设你需要为一款新推出的智能手表生成社交媒体文案。
- 错误示范:“写一段智能手表的广告。” 结果通常空洞无物,缺乏吸引力。
- 正确示范:“你是一位擅长小红书风格的营销专家,目标用户是25-35岁的都市白领,产品核心卖点是‘无感佩戴’和‘7天超长续航’,请生成一篇500字以内的种草文案,要求包含3个emoji,语气轻松活泼,结尾引导用户点击链接。”

通过这种细颗粒度的控制,模型输出的内容直接可用率大幅提升。
私有数据与微调:打造行业专属大脑
通用大模型的知识截止于训练数据的时间点,且缺乏特定行业的私有知识,对于金融、医疗、法律等高门槛行业,直接使用公开模型风险极高。“AI打大模型”的第二层含义是利用私有数据进行适配。
RAG技术:检索增强生成的实战应用
检索增强生成(RAG)是目前解决大模型知识滞后和幻觉问题的主流方案,它的核心逻辑是“先查后答”。
- 知识库构建:将企业内部文档(如PDF、Word、数据库记录)进行清洗、切片,并转化为向量存入向量数据库。
- 检索阶段:当用户提问时,系统先在向量数据库中搜索最相关的片段。
- 生成阶段:将检索到的片段作为上下文,连同用户问题一起发送给大模型,让模型基于这些“参考材料”生成答案。
据工信部相关技术白皮书显示,引入RAG架构后,企业在垂直领域的问答准确率平均提升了40%以上,这种方法无需重新训练模型,成本低且迭代快。
参数高效微调(PEFT)的选择
如果RAG不足以解决复杂逻辑问题,可能需要对模型进行微调,全量微调成本高昂,通常只有头部科技公司承担,对于大多数企业,LoRA(低秩自适应)等参数高效微调技术是更优选择。
- 数据准备:构建高质量的指令微调数据集,格式通常为JSON,包含输入(Input)、输出(Output)和指令(Instruction)。
- 训练环境:使用开源框架如LLaMA-Factory或Unsloth,在消费级显卡上即可完成小规模微调。
- 评估迭代:微调后必须进行人工评估和自动化测试,确保模型没有发生“灾难性遗忘”,即没有忘记通用能力而只记住了特定任务。

成本与性能平衡:2026年的选型策略
企业在部署AI时,最关心的往往是性价比,不同规模的模型适用于不同场景,盲目追求最大参数模型往往导致资源浪费。
模型大小与场景匹配表
| 模型规模 | 典型参数量 | 适用场景 | 部署成本 | 响应速度 |
|---|---|---|---|---|
| 小模型 | 7B – 14B | 简单分类、情感分析、日常客服 | 低(可本地部署) | 极快 |
| 中模型 | 30B – 70B | 复杂推理、代码生成、内容创作 | 中(需高性能GPU) | 中等 |
| 大模型 | 100B+ | 前沿科研、复杂决策、多模态理解 | 高(需集群部署) | 较慢 |
- 小模型优势:推理成本低,延迟低,适合高并发场景,近年来,小模型在特定任务上的表现已逼近中等模型,是边缘计算的首选。
- 大模型优势:逻辑推理能力强,上下文窗口大,适合处理长文档和复杂任务,但在非关键任务上使用大模型,相当于用大炮打蚊子。
行业共识认为,混合部署策略是最佳实践,前端使用小模型处理简单请求,后端挂载大模型处理疑难杂症,通过路由层智能分配流量。
安全与伦理:不可忽视的底线
随着AI深入业务核心,数据安全和内容合规成为“AI打大模型”中不可回避的一环。
数据隐私保护
在处理用户数据时,必须确保敏感信息不被泄露。

- 数据脱敏:在输入模型前,自动识别并替换姓名、身份证号、银行卡号等PII(个人身份信息)。
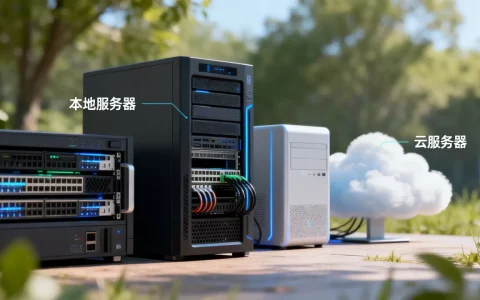
- 私有化部署:对于金融、医疗等敏感行业,建议将模型部署在本地服务器或私有云上,避免数据经过公有云API。
合规性控制
模型可能会生成偏见、歧视或违规内容。
- 护栏机制:在输入和输出端设置过滤器,拦截违规关键词和敏感话题。
- 人工审核:对于高风险场景(如自动生成法律意见书),必须保留人工复核环节,AI仅作为辅助工具。
常见问题解答
AI打大模型需要多少预算?
预算取决于部署方式,如果采用公有云API调用,按Token计费,初期成本极低,适合小规模测试,若选择私有化部署,需考虑硬件成本(GPU服务器)、软件授权费及运维人力,对于中小企业,建议从SaaS服务或API调用起步,待业务量稳定后再评估私有化需求。
大模型会完全取代人类员工吗?
目前的技术趋势是“人机协作”而非“完全替代”,AI擅长处理重复性、数据密集型的任务,如数据整理、初稿撰写、代码调试,人类员工则聚焦于创意策划、复杂决策、情感沟通和最终审核,业内专家指出,掌握AI工具的员工将比不使用AI的员工效率高出数倍,但这并不意味着岗位消失,而是岗位职责向更高价值环节转移。
如何评估大模型的效果?
评估不能仅凭感觉,需建立量化指标。
- 准确性:答案与事实的吻合程度,可通过人工标注集进行打分。
- 相关性:回答是否切题,是否包含冗余信息。
- 安全性:是否包含违规内容或偏见。
- 响应时间:从提问到生成答案的延迟,影响用户体验。
建议定期抽取样本进行盲测,结合自动化测试脚本,形成多维度的评估报告,据此持续优化提示词和模型配置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/386523.html

评论列表(1条)
提示词工程?拉倒吧,私有数据微调才是王道。我对比过同价位方案,光靠RAG根本不够,得看底层算力,这配置不行,等下一代再说