AI大模型RAG模块的核心价值在于通过外挂知识库解决大模型幻觉问题,实现企业私有数据的精准检索与实时回答,是目前构建企业级智能应用的最优技术路径。参考2
为什么RAG成为2026年企业AI落地的首选方案
在2026年的技术语境下,单纯依赖大语言模型(LLM)进行回答已经无法满足企业对准确性和实时性的严苛要求,大模型虽然具备强大的逻辑推理和生成能力,但其训练数据存在截止时间,且缺乏对企业内部敏感数据的访问权限,检索增强生成(RAG)技术通过引入外部知识库,让模型在生成回答前先去“查阅”相关文档,从而显著降低了事实性错误的发生率。参考2

业内专家指出,RAG架构通过解耦“知识存储”与“逻辑推理”,使得企业无需重新训练庞大的基础模型,即可快速赋予AI新的业务能力,这种架构不仅降低了算力成本,还提高了数据的安全性和可控性,对于大多数寻求AI转型的企业而言,RAG模块是连接通用大模型与垂直业务场景的关键桥梁。参考2
RAG与传统微调技术的深度对比
许多企业在构建AI应用时,常在RAG和模型微调(Fine-tuning)之间犹豫不决,两者并非互斥关系,但在不同场景下各有优劣。参考2
- 知识更新频率:微调后的模型知识固化,若要更新知识需重新训练,成本高且周期长;RAG只需更新向量数据库中的文档,即可实现秒级知识更新。
- 幻觉控制能力:微调主要改变模型的表达风格或特定领域的推理逻辑,对事实性错误的纠正能力有限;RAG通过强制模型基于检索到的原文片段生成答案,能大幅抑制幻觉。
- 可解释性与溯源:微调模型的回答往往黑盒化,难以追溯依据;RAG回答通常附带引用来源,便于人工审核和责任界定。
场景化选择指南
若业务涉及大量事实性查询、法律法规解读或实时新闻分析,RAG是绝对的首选,若业务侧重于特定风格的文案生成、代码风格统一或复杂逻辑推理能力的提升,则建议结合微调技术,多数情况下,最佳实践是将两者结合,即使用微调优化模型的指令遵循能力,使用RAG提供准确的事实依据。

构建高性能RAG模块的实操关键步骤
一个优秀的RAG系统不仅仅是简单的“检索+生成”,其效果取决于数据预处理、检索策略和生成优化等多个环节的精细打磨,以下是构建高可用性RAG模块的核心操作路径。
数据清洗与向量化处理
数据质量直接决定检索效果,在将企业文档转化为向量之前,必须进行严格的清洗和分块处理。参考2
- 文档解析:使用专业的解析工具处理PDF、Word、Excel等多格式文件,保留表格、标题层级等结构信息。
- 智能分块(Chunking):避免简单按字符数切分,应采用语义分块算法,确保每个文本块包含完整的语义单元,将一段连续的对话或一个完整的段落作为一个块,避免上下文断裂。
- 向量化嵌入:选择适合中文语境且支持长文本的Embedding模型,将文本块转化为高维向量,近年来,主流厂商推出的混合检索模型在语义匹配精度上有了显著提升。
混合检索策略优化
单一的向量检索难以应对所有查询场景,混合检索成为行业共识。
- 稠密向量检索:基于语义相似度匹配,适合处理模糊查询和意图识别。
- 稀疏向量检索(BM25):基于关键词匹配,适合处理专有名词、精确代码片段或特定术语查询。
- 重排序(Re-ranking):在初步检索出Top-K个文档后,使用重排序模型对结果进行精细化打分,剔除无关文档,保留最相关的片段,这一步骤通常能将最终回答的准确率提升10%-20%。
检索增强生成的进阶技巧
在获取相关文档后,如何引导大模型生成高质量回答至关重要,可以采用以下策略:
- 上下文压缩:剔除检索结果中的冗余信息,仅保留与查询最相关的句子。
- 引用标注:强制模型在生成答案时标注引用来源,便于用户验证。
- 多跳推理:对于复杂问题,设计多轮检索机制,让模型根据前一轮的检索结果生成新的查询词,进行二次检索,以获取更全面的信息。

2026年企业选型RAG模块的核心考量因素
随着RAG技术的成熟,市场上出现了众多解决方案,企业在选型时,不应仅关注算法的先进性,更应关注系统的稳定性、易用性和生态兼容性。参考2
技术架构与部署灵活性
不同的企业IT环境对RAG模块的部署方式有不同要求。
- 私有化部署:对于金融、医疗等对数据隐私要求极高的行业,选择支持本地化部署的RAG框架至关重要,这确保了数据不出域,符合合规要求。
- 云端SaaS服务:对于初创企业或中小型企业,使用云端托管的RaaS(Retrieval as a Service)服务可以快速上线,降低运维成本。
- 混合云架构:结合私有数据的安全性和公有云的算力弹性,成为许多大型企业的折中方案。
生态集成与开发效率
RAG模块需要与企业现有的业务系统无缝集成。
- API接口标准化:提供RESTful API或GraphQL接口,便于与ERP、CRM等系统对接。
- 低代码/无代码平台:部分厂商提供可视化配置界面,允许业务人员通过拖拽方式构建知识库,降低技术门槛。
- 主流框架兼容:确保模块兼容LangChain、LlamaIndex等主流开源框架,方便开发者进行二次开发。
成本效益分析
构建RAG系统的成本主要包括算力成本、存储成本和人力成本。
| 成本项 | 说明 | 优化建议 |
|---|---|---|
| 算力成本 | 向量检索和重排序需要GPU资源 | 采用量化技术降低模型精度要求,使用CPU进行向量检索 |
| 存储成本 | 向量数据库和原始文档存储 | 定期清理过期数据,使用冷热数据分层存储 |
| 人力成本 | 数据清洗、Prompt工程、系统维护 | 引入自动化数据预处理工具,建立标准化的Prompt模板库 |

据统计,采用自动化数据预处理工具的企业,其数据准备周期可缩短50%以上,在预算有限的情况下,优先优化数据质量和检索策略,往往比盲目追求大模型规模更能带来显著的效果提升。
常见问题解答
AI大模型RAG模块如何解决数据隐私安全问题
RAG模块本身不改变数据的存储位置,而是通过权限控制实现安全访问,企业应在向量数据库层面实施严格的访问控制列表(ACL),确保只有授权用户才能检索特定文档,在数据传输过程中采用加密通道,防止数据泄露,对于敏感数据,可采用本地化部署方案,确保数据完全在企业内部闭环。
RAG模块的检索准确率如何量化评估
评估RAG效果主要关注两个指标:检索准确率(Recall@K)和生成准确率(Answer Relevance),Recall@K衡量的是在检索出的前K个文档中,包含正确答案的比例;Answer Relevance则通过人工标注或自动化评估模型,判断生成答案是否与查询意图匹配,业内通常建议结合自动化指标和人工抽检,建立多维度的评估体系,定期监控效果变化。
2026年RAG模块的技术发展趋势是什么
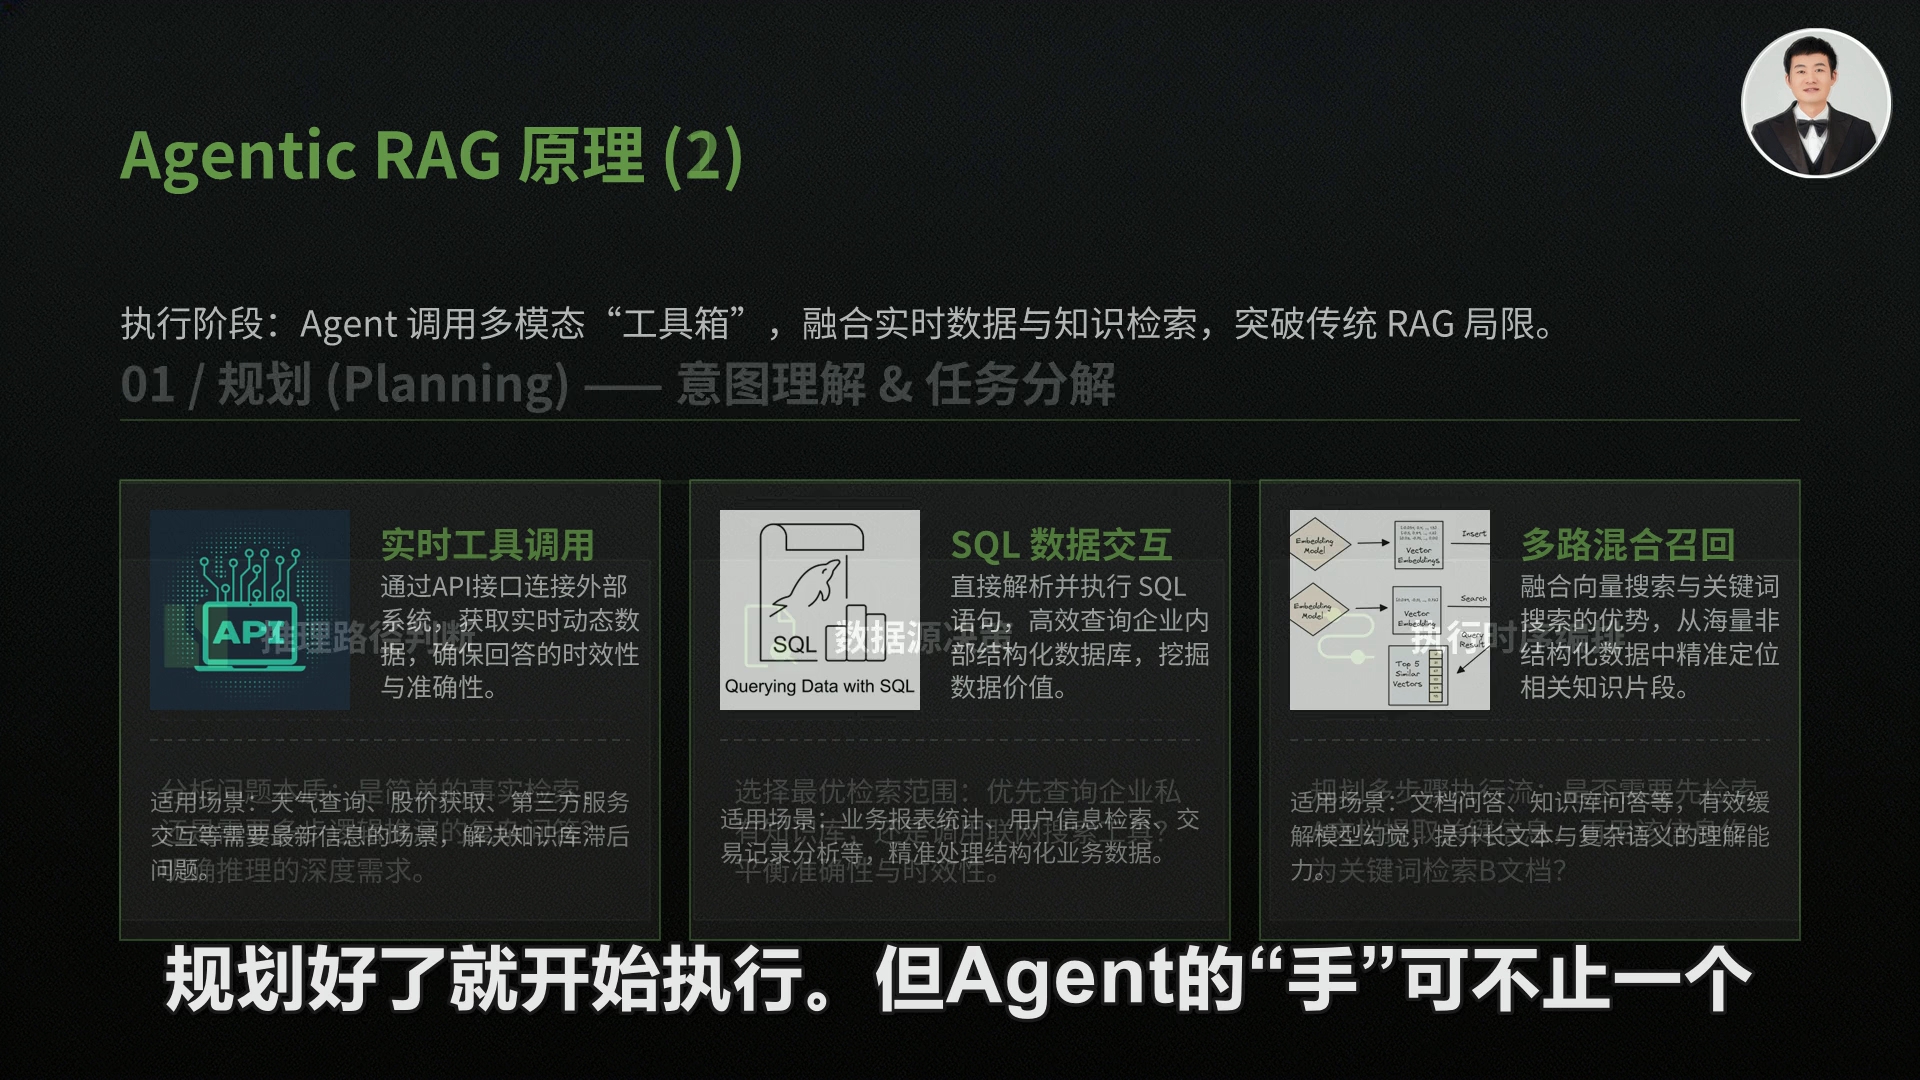
未来RAG技术将向更智能、更自动化的方向发展,Agent(智能体)技术的融入将使RAG具备自主规划检索路径的能力,实现多步推理和动态知识获取;多模态RAG将支持图像、音频、视频等非结构化数据的检索与生成,拓展应用场景,端侧RAG技术的成熟,将使低功耗设备也能运行高效的检索增强生成模型,推动AI应用的边缘化部署。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/379127.html