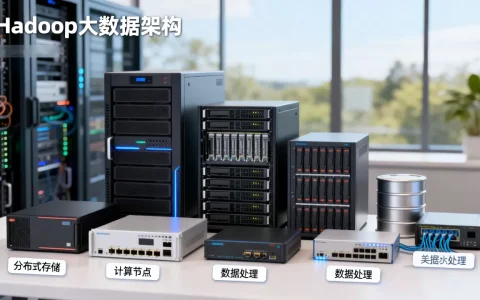
Hadoop处理大量小文件的核心痛点在于NameNode内存耗尽与数据块管理效率低下,最佳解决方案是通过合并小文件、使用SequenceFile/HFile等二进制格式或引入HBase/Kafka等专用存储组件来优化集群性能。
在Hadoop分布式文件系统(HDFS)的架构设计中,每一个文件、目录和数据块都会在NameNode的内存中占用约150字节的元数据空间,当数据量达到PB级别且包含数十亿个小文件时,NameNode的内存资源会迅速枯竭,导致集群无法启动或响应极慢,业内专家指出,这种元数据膨胀是Hadoop集群性能瓶颈的主要来源之一,因此理解并解决小文件问题不仅是运维需求,更是架构设计的基石。

为什么小文件会成为Hadoop集群的“隐形杀手”
HDFS的设计初衷是为了处理大规模流式数据,而非随机读写的小文件,其默认块大小通常为128MB或256MB,这意味着即使是一个只有1KB的文件,也会占用整个数据块的空间,这种空间浪费在存储成本上可能看似微不足道,但在元数据管理上却是致命的。
NameNode内存压力与启动风险
NameNode作为HDFS的大脑,负责维护整个文件系统的命名空间和客户端对文件的访问,它需要将所有文件的元数据加载到内存中。
- 元数据占用激增:每个小文件都独立占用150字节左右的内存,若集群中有10亿个小文件,仅元数据就需要约150GB的内存,这还不包括目录结构和权限信息。
- 集群启动缓慢:当NameNode重启时,它需要从FsImage和EditLog中恢复元数据,小文件数量越多,加载时间越长,可能导致集群长时间处于安全模式,影响业务可用性。
- 扩展性受限:随着数据增长,NameNode内存成为硬瓶颈,增加NameNode内存只能延缓问题,无法根本解决,因为内存成本远高于磁盘存储成本。
数据读取效率低下
除了内存问题,小文件对数据读取性能也有显著影响。
- 寻址开销大:读取一个小文件需要建立网络连接、解析协议、定位数据块位置,这些固定开销对于几KB的数据来说,效率极低。
- MapReduce任务碎片化:在MapReduce计算中,每个小文件通常会启动一个Map任务,如果小文件数量巨大,会产生成千上万个Map任务,导致资源调度混乱,TaskTracker负载不均,整体作业执行时间大幅延长。

解决hadoop存储大量小文件的实用策略
面对小文件问题,不能仅靠单一手段,而应根据数据生命周期和业务场景采取组合策略,以下是经过验证的几种主流解决方案。
文件合并:最直接的成本优化手段
文件合并是将多个小文件打包成一个或几个大文件的过程,这是最简单且见效最快的方法,尤其适用于日志文件、CSV数据等静态数据。
使用Hadoop Archive (HAR)
HAR是Hadoop自带的一种归档格式,它将多个文件打包成一个归档文件,同时保留文件的独立元数据,允许直接读取归档内的单个文件。
- 创建归档:使用命令`hadoop archive -archiveName myarchive.har -p /source/dir /dest/dir`将源目录下的文件归档。
- 访问归档:通过路径`har:///dest/dir/myarchive.har`即可像访问普通目录一样读取内部文件,无需解压。
这种方式减少了NameNode中的文件数量,但归档文件本身仍是一个大文件,若内部文件极多,读取特定文件时仍需遍历索引,性能提升有限。
使用SequenceFile或RCFile
对于需要频繁读取和计算的数据,将小文件转换为二进制格式是更优选择。
- SequenceFile:一种键值对存储格式,支持压缩和分割,它将多个小文件合并为一个SequenceFile,每个小文件作为一条记录。
- RCFile/ORC:列式存储格式,不仅合并文件,还优化了存储结构和压缩比,特别适合OLAP查询场景。
通过编写简单的MapReduce作业或Spark程序,可以批量将HDFS上的小文件读取并写入SequenceFile,从而将数百万个小文件合并为几个GB级别的大文件。
引入专用存储组件:架构层面的根本解决
如果业务场景涉及海量小文件的随机读写或高频更新,HDFS并非最佳选择,引入HBase、Hive或Kafka等专业组件是更明智的决定。
HBase:适合随机读写的海量数据
HBase基于HDFS构建,但通过RegionServer和MemStore机制,专门优化了小文件和高并发读写场景。
- 自动合并:HBase内部会自动将小的StoreFile合并为大文件,无需人工干预。
- 低延迟访问:通过RowKey设计,可实现毫秒级的单行数据读取,完美解决小文件读取慢的问题。

对于物联网传感器数据、用户行为日志等场景,直接写入HBase比写入HDFS更高效。
Hive + ORC:适合分析型查询
Hive将数据仓库功能引入Hadoop,支持SQL查询,配合ORC文件格式,可以将小文件合并为列式存储的大文件,大幅提升查询效率。
- 创建ORC表:使用`STORED AS ORC`语法创建表。
- 动态合并:启用`hive.merge.mapfiles`和`hive.merge.tezfiles`参数,在MapReduce或Tez作业结束后自动合并小文件。
这种方案特别适合数据湖场景,既能保留HDFS的存储能力,又能通过Hive优化查询性能。
不同场景下的方案选择对比
为了帮助决策者更好地选择方案,以下表格对比了不同策略的适用场景和优缺点。
| 方案 | 适用场景 | 优点 | 缺点 | 实施难度 |
|---|---|---|---|---|
| HAR归档 | 冷数据备份、低频访问 | 实施简单,保留文件独立性 | 读取特定文件仍慢,压缩率低 | 低 |
| SequenceFile合并 | 批量处理、离线分析 | 显著提升MapReduce效率,支持压缩 | 不支持随机读取,需重写数据 | 中 |
| HBase存储 | 实时查询、高频更新 | 低延迟,自动管理文件,支持随机读写 | 架构复杂,运维成本高,不适合批量分析 | 高 |
| Hive+ORC | 数据仓库、SQL查询 | 兼容SQL,查询性能优异,自动合并 | 写入延迟高,不适合实时写入 | 中 |

如何评估合并小文件的成本效益
在决定合并小文件前,需评估其带来的收益。
- 存储成本:合并后文件数量减少,NameNode内存压力降低,可能允许使用更少节点的集群,从而节省硬件成本。
- 计算成本:减少Map任务数量,降低YARN资源调度开销,缩短作业执行时间,节省计算资源。
- 运维成本:简化管理,减少因小文件导致的集群不稳定风险。
据统计,在多数大数据平台中,小文件合并可带来30%-50%的计算性能提升,具体数值取决于数据分布和合并策略。
预防小文件产生的最佳实践
解决小文件问题不仅是事后补救,更应前置到数据生产环节。
优化数据写入逻辑
在数据接入层,避免逐条写入HDFS。
- 批量写入:使用Kafka作为缓冲,消费端批量处理数据后写入HDFS或HBase。
- 动态分区:在Hive中合理设置分区字段,避免分区过多导致小文件激增。
定期清理与归档
建立数据生命周期管理策略。
- 自动清理:配置定时任务,定期删除过期的小文件。
- 冷数据归档:将超过一定时间未访问的数据归档到廉价存储或HAR格式中,释放NameNode资源。
hadoop处理小文件常见问题解答
合并小文件会影响正在运行的作业吗?
合并小文件通常需要在作业间隙或低峰期进行,因为合并过程本身需要读取和写入数据,会占用集群资源,若在作业运行期间合并,可能导致作业重试或性能波动,建议通过脚本自动化合并流程,并监控集群负载,确保合并操作不影响核心业务。
HBase是否完全取代HDFS?
HBase和HDFS并非替代关系,而是互补关系,HBase底层存储仍依赖HDFS,HDFS提供高吞吐量的批量写入和存储能力,HBase提供低延迟的随机读写能力,对于大多数大数据架构,两者结合使用能发挥最大效能。
如何监控HDFS小文件数量?
可通过HDFS Web UI查看NameNode的元数据统计信息,或使用HDFS命令行工具hdfs dfsadmin -report获取集群概况,可编写脚本定期扫描HDFS目录,统计文件数量和数据块数量,设置阈值告警,以便及时发现小文件激增问题。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/439854.html