


Hive与MySQL同步的核心在于利用数据集成工具(如DataX或Sqoop)进行离线批量迁移,或通过Kafka+Flink构建实时流处理链路,以解决异构数据库间的数据孤岛问题,实现从关系型事务库到大数据仓库的无缝流转。
在数字化转型的深水区,企业往往面临一个痛点:MySQL承载着高频交易和实时业务,而Hive则负责海量数据的离线分析与挖掘,如何将这两者高效打通,不仅是技术选型的问题,更是数据资产变现的关键,业内专家指出,构建稳定、低延迟的数据同步链路,能够显著降低数据延迟带来的决策滞后风险,让数据真正“活”起来。

同步方案选型:离线批处理与实时流处理的博弈
选择同步方案时,不能盲目追求最新技术,而应基于业务场景的容错率和时效性要求,目前主流的方案分为离线批处理和实时流处理两大类,二者各有优劣,适用于不同的业务场景。
离线同步:稳定压倒一切
对于大多数企业而言,T+1的日报、月报需求占据了数据分析的较大比例,在这种情况下,离线同步方案因其成熟稳定、易于维护而成为首选。
- 工具选择:Apache Sqoop是早期最经典的选择,但随着生态演进,阿里开源的DataX和SeaTunnel因其更高的并发能力和更好的插件生态,逐渐取代了Sqoop成为主流。
- 执行逻辑:通常采用全量+增量的模式,全量同步用于初始化历史数据,增量同步则通过监听MySQL的Binlog或使用时间戳字段,定期抽取新增或更新的数据。
- 优势分析:
高吞吐量
离线任务可以在夜间低峰期运行,利用集群全部资源进行高速传输,对在线业务影响极小。
容错性强
一旦任务失败,可以简单重启,且数据一致性容易通过主键去重或时间窗口校验来保证。
实时同步:毫秒级响应的代价
当业务需要实时监控大屏、即时风控或个性化推荐时,分钟级甚至秒级的数据延迟是不可接受的,基于CDC(Change Data Capture)技术的实时同步方案成为必选项。
- 技术栈组合:MySQL Connector -> Kafka -> Flink/Spark Streaming -> Hive/HBase。
- 核心难点:
数据乱序处理
网络波动或MySQL主从切换可能导致事件顺序错乱,需要Flink设置合理的Watermark和允许乱序的时间窗口。
状态管理
实时计算需要维护巨大的状态信息,对内存和Checkpoint机制要求极高,一旦故障恢复,需确保不丢不重。

技术实现路径与关键配置细节
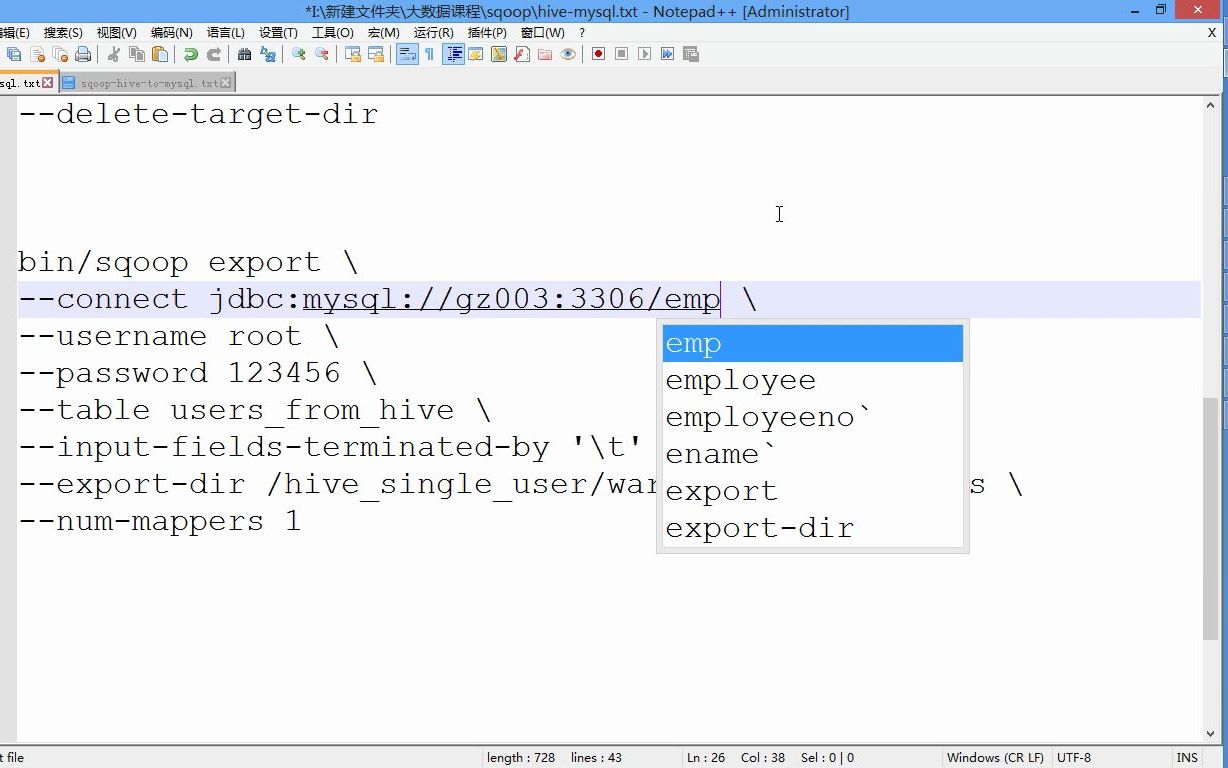
明确了方案选型,接下来是具体的落地执行,这里以目前业界较为通用的DataX离线同步和Flink CDC实时同步为例,拆解实操步骤。
离线同步实操:DataX配置指南
DataX的核心在于JSON配置文件,它定义了Reader(源端)和Writer(目标端)的参数。
- 安装与部署:下载DataX包,解压后无需复杂安装,直接运行脚本即可,确保MySQL和Hive集群的网络互通,且Hive Metastore服务正常。
- 编写JSON配置:
- Reader部分:配置MySQL连接URL、用户名、密码、查询语句(如`select from orders where update_time > ‘${last_sync_time}’`)。
- Writer部分:配置Hive JDBC URL、表名、字段映射、以及写入模式(overwrite或insert)。
- 性能调优:
- 通过调整`writer`插件中的`preSql`和`postSql`处理数据清洗。
- 增加`channel`数量以提高并发度,但需注意不要超过Hive NameNode的连接限制。
- 对于大字段(如TEXT/BLOB),建议单独处理或转换为String类型,避免内存溢出。
实时同步实操:Flink CDC链路搭建
实时同步的复杂度远高于离线,重点在于Debezium连接器与Flink作业的集成。
- 开启MySQL Binlog:确保MySQL配置文件中`log-bin`和`binlog-format=ROW`已开启,这是CDC捕获变更的基础。
- 构建Flink作业:
- 引入`flink-connector-mysql-cdc`依赖。
- 配置Source端,指定MySQL主机、端口、用户名及需要监控的数据库表。
- 配置Sink端,将数据写入Kafka Topic,或直接写入Hive表(需注意Hive的ACID支持情况,建议使用Iceberg或Hudi作为中间层)。
- 处理Schema变更:
当MySQL表结构变更(如新增列)时,Flink作业需具备动态感知能力,可通过配置`scan.startup.mode`为`latest-offset`避免全量扫描,或利用Schema Evolution特性自动适配新字段。


常见痛点与避坑指南
在实际生产环境中,同步链路往往不是“配置完就万事大吉”,而是充满了各种隐性陷阱,以下是基于行业共识总结的高频问题及解决方案。
数据一致性难题
MySQL是强一致性的关系型数据库,而Hive最终一致性且支持追加写,在同步过程中,极易出现“数据丢失”或“重复数据”。
- 重复数据:离线同步中,若任务重试导致同一时间段数据被多次抽取。
解决方案
在Hive端使用`INSERT OVERWRITE`覆盖分区,或在Hive表设计中引入唯一键,通过Upsert逻辑去重。
- 数据丢失:实时同步中,Flink Checkpoint失败或Kafka积压导致数据未消费。
解决方案
开启Flink的精确一次(Exactly-Once)语义,并确保Kafka消费者提交Offset的时机在数据处理成功后。
性能瓶颈与优化
随着数据量增长,同步延迟可能从分钟级恶化到小时级。
- MySQL压力:频繁的全表扫描或大事务查询会拖慢在线业务。
解决方案
务必使用增量同步,并建立合适的索引,若必须全量同步,建议在MySQL只读副本(Slave)上进行抽取,避免影响主库性能。
- Hive写入小文件:实时同步产生大量微小文件,导致Hive查询极慢。
解决方案
在Flink Sink端合并小文件,或定期运行Hive的`MSCK REPAIR TABLE`及小文件合并任务。
网络与安全
跨VPC或跨地域同步时,网络抖动是最大敌人。
- 断点续传:确保同步工具支持断点续传功能,记录上次同步的时间戳或Binlog Position,重启后从断点继续,而非从头开始。
- 加密传输:使用SSL/TLS加密MySQL与Hive之间的连接,防止敏感数据在传输过程中被窃听。
成本考量与资源规划
搭建Hive MySQL同步链路,除了技术投入,还有不可忽视的经济成本。
计算与存储成本
Hive底层通常基于HDFS,存储成本较低,但计算资源(YARN/K8s)消耗巨大。

- 资源隔离:建议将同步任务与在线分析任务隔离,避免高峰期资源争抢。
- 压缩策略:在Hive端使用Snappy或ZSTD压缩格式,可节省相当一部分存储成本,同时提升IO效率。
人力维护成本
实时同步链路复杂,需要专门的运维人员监控Job状态、Kafka Lag和Binlog延迟。
- 自动化监控:建立完善的告警体系,当同步延迟超过阈值(如5分钟)时,自动触发钉钉或邮件通知,将被动救火转变为主动预防。
Hive MySQL同步常见问题解答
如何选择合适的Hive MySQL同步工具?
选择工具需基于数据量级和时效性要求,对于T+1离线报表,DataX或Sqoop足够稳定且易于维护,适合大多数传统企业,对于需要分钟级更新的实时大屏或风控场景,应选用基于Flink CDC的方案,虽然搭建和维护成本高,但能提供更低的延迟,若预算有限且数据量不大,也可考虑商业ETL工具如Kettle,但其并发能力和大数据生态集成度较弱。
同步过程中出现数据格式不一致怎么办?
MySQL与Hive的数据类型映射存在差异,例如MySQL的DATETIME在Hive中可能对应STRING或TIMESTAMP。
- 显式转换:在同步工具的配置中,使用`reader`的`column`配置进行类型强制转换,或在Flink SQL中使用`CAST`函数。
- 统一标准:在数据源层(MySQL)统一时间格式为`YYYY-MM-DD HH:mm:ss`,避免时区问题。
- 清洗层处理:在写入Hive前,增加一个数据清洗环节,剔除格式错误的数据并记录日志,确保脏数据不污染数仓。
Hive MySQL同步延迟高的原因及优化手段?
延迟高通常由三个因素导致:源端查询慢、网络传输瓶颈、目标端写入慢。
- 优化源端:确保抽取语句命中索引,避免全表扫描;使用增量抽取而非全量。
- 优化传输:增加并发通道数,使用压缩算法减少网络IO。
- 优化目标端:调整Hive的`mapreduce.reduce.memory.mb`参数,增加写入并行度;避免向单个小分区频繁写入,采用批量提交策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/440367.html





评论列表(1条)
转给朋友看看,之前搞同步被坑惨了哈哈,Flink那个确实稳,已转发朋友圈,必须安利