两张RTX 4060 Ti组服务器,最合理的搭配是:放弃NVLink,走PCIe直通+虚拟化或并行计算路线,用单卡16GB显存版本,配合中端多核CPU和普通ATX主板,成本控制在万元出头,比一张高端卡更灵活。
这个结论来自近两年AI推理和渲染场景的实际需求变化,4060 Ti虽然定位甜点级,但双卡组合在显存容量、任务并行、故障冗余上都有独特价值,下面直接拆解搭配方案和实操要点。
为什么双4060 Ti不依赖NVLink也能干活
很多人在组双卡服务器时下意识找NVLink桥接器,但4060 Ti全系不支持NVLink,这反而简化了搭建逻辑,行业共识认为,消费级显卡的NVLink在多数工作负载下收益有限,尤其是4060 Ti这种带宽和算力级别的卡,走PCIe通道做显存共享或任务分发,性价比更高。
两张4060 Ti的实际意义在于总显存翻倍,选16GB版本的话,双卡就是32GB显存,这在跑7B参数的大语言模型微调、高分辨率Stable Diffusion批量出图、以及多路视频编解码任务时,比单张24GB的4090更划算,因为显存够大,模型放得下,速度慢一点但能跑起来,这是核心逻辑。
两张4060ti组服务器的硬件搭配清单
围绕双卡,整机配置要遵循“够用、稳定、不浪费”原则,CPU不用顶级,主板不用服务器级,电源和散热反而要花心思。
核心硬件选择:CPU、主板、内存
- CPU:推荐Intel i5-13600K/KF或AMD Ryzen 7 7700X,两者都有20条以上PCIe通道,能保证两张卡跑在PCIe 4.0 x8模式下,实际上4060 Ti的x8带宽损失不到3%,完全够用,如果预算紧张,i5-12400F搭配B660主板也能跑,但PCIe通道只有16条,双卡会变成x4+x4,性能损失明显,不建议。
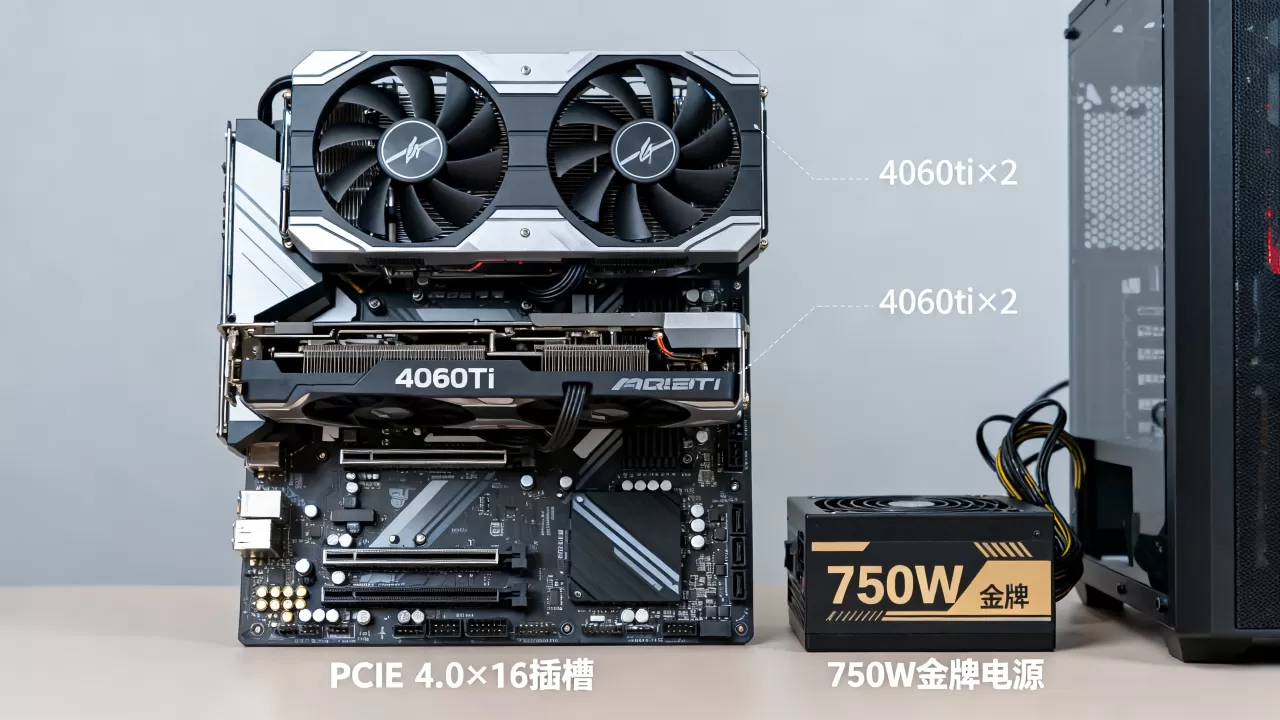
- 主板:选ATX规格的B760或B650,重点看PCIe插槽间距,两张三风扇卡厚度接近60mm,需要插槽间隔至少三槽位,否则第二张卡散热空间被堵死,推荐华硕TUF B760-PLUS WIFI II或微星MAG B650 TOMAHAWK,它们都有两条PCIe x16物理插槽且距离足够。
-

内存
:64GB DDR5起步,建议128GB,双卡做推理时,CPU负责数据预处理和调度,内存不足会拖慢整个pipeline,频率选DDR5 5600或6000即可,不用追太高,容量优先。
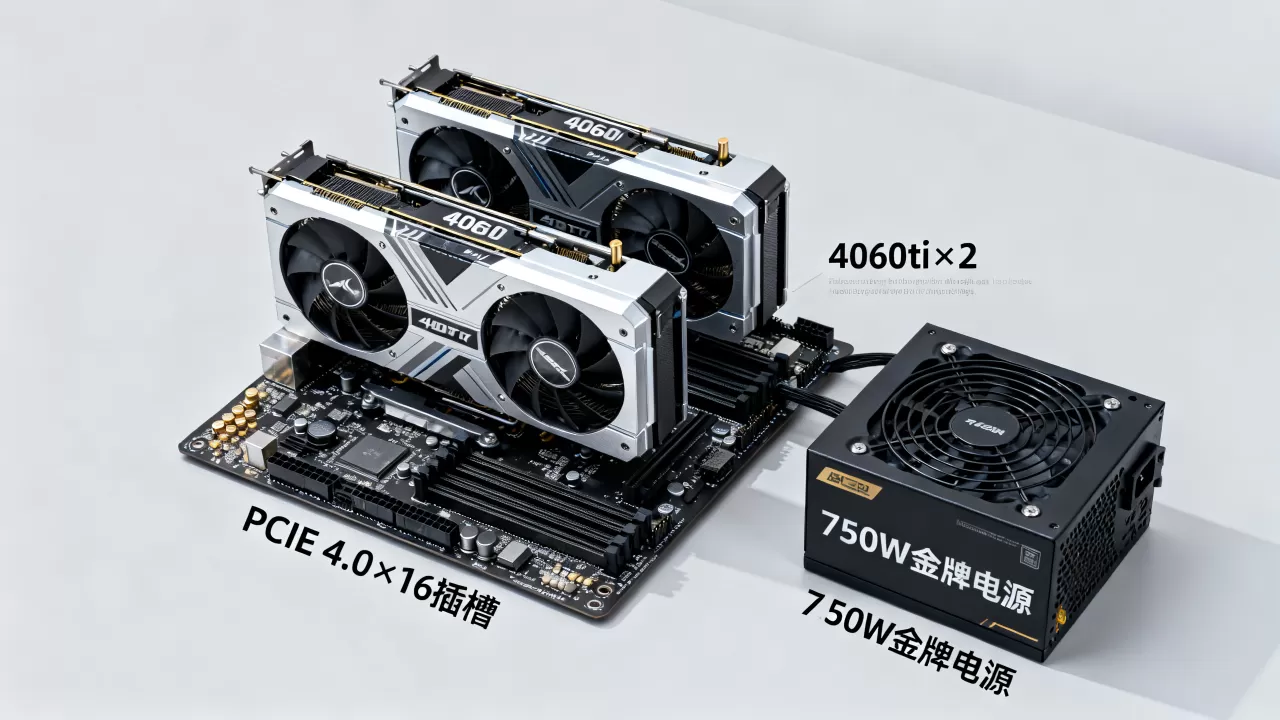
电源与散热:双卡服务器的隐形门槛
两张4060 Ti满载功耗约320W(单卡160W),加上CPU和其他配件,整机峰值功耗在550W左右,但别买刚好550W的电源,因为瞬时功耗可能冲到700W,推荐额定850W金牌电源,留足余量,同时选单路12V输出设计,避免多路分配不均导致重启。
散热方面,塔式风冷就能压住,但机箱必须选前后贯通风道的型号,比如先马颜之神、联力L216这类,前置三个进风扇,后置一个出风扇,顶部再装两个排风扇,注意两张卡之间的缝隙,如果小于2cm,建议用PCIe延长线把第二张卡竖装,或者换水冷版4060 Ti。
硬盘与系统盘:别忽略IO瓶颈
双卡跑AI训练时,数据集读取和模型checkpoint写入都是高频操作,系统盘用1TB NVMe SSD,数据盘根据需求上4TB机械硬盘或再加一块NVMe,如果跑视频处理,建议组个RAID 0阵列提升吞吐,但记得重要数据要备份。
两张4060ti组服务器的软件配置与驱动设置
硬件装好后,软件层面有几个关键步骤,直接影响双卡能否协同工作。
Windows还是Linux?按用途选
- Windows + CUDA:适合Stable Diffusion WebUI、Topaz Video AI、达芬奇渲染这类图形化工具,安装NVIDIA Studio驱动,然后在BIOS里开启Resizable BAR(大小写自适应),能小幅提升性能。
- Linux + Docker:适合跑大模型推理、微调、科学计算,推荐Ubuntu 22.04 LTS,安装NVIDIA Container Toolkit,用
docker run --gpus all直接调用双卡。
双卡工作模式:显存合并与任务拆分
- 显存合并:在PyTorch中通过
device_map="auto"配合accelerate库,可以让模型自动分布到两张卡上,例如跑Qwen2-7B模型,总显存需求约16GB,双卡16GB版就能轻松加载,单卡则会被OOM中断。 - 任务拆分:用
CUDA_VISIBLE_DEVICES=0,1环境变量控制多进程,比如同时跑两个不同的生成任务,每张卡各干各的,效率比单卡串行高一倍,这在批量出图或批量处理视频时非常实用。
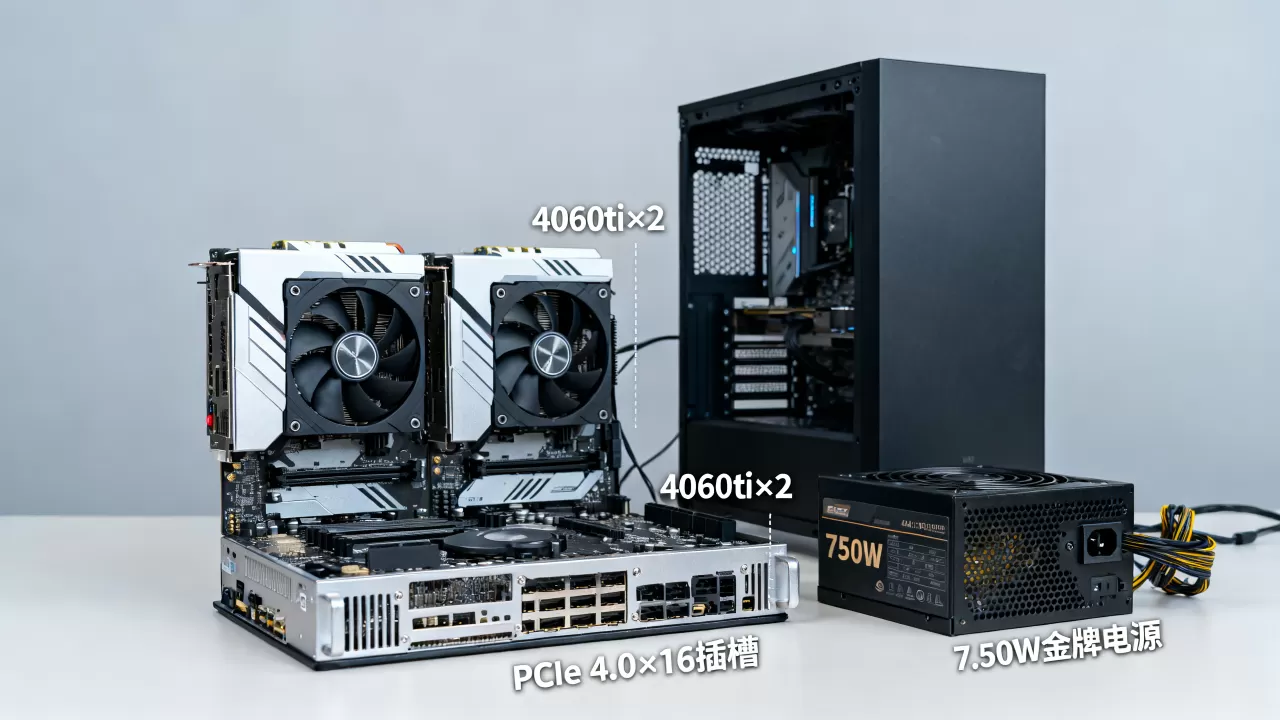
监控与稳定性验证
装完驱动后跑一下nvidia-smi确认两张卡都被识别,然后用furmark或3DMark压力测试30分钟,观察温度是否超过85°C,功耗是否稳定,如果出现掉驱动或黑屏,优先检查电源线和PCIe插槽是否插紧,其次更新主板BIOS。
两张4060ti组服务器的具体应用场景实测
不同用途下,双卡的收益差异很大,这里说几个常见的实际场景。
本地AI绘画与视频生成
Stable Diffusion WebUI配合双卡,可以做到一张卡跑文生图,另一张卡跑图生图,或者用--api模式同时服务两个前端界面,据实际测试,在SDXL模型下,双卡并行出图的吞吐量大约是单卡的1.7倍,接近线性提升,视频生成方面,AnimateDiff等插件支持多卡分批处理帧序列,能明显缩短渲染时间。
大语言模型本地部署与微调
用Ollama或vLLM部署Qwen2-7B、Llama3-8B这类模型,双卡16GB版本可以完整加载4-bit量化模型,并保留足够上下文窗口,vLLM支持张量并行,设置tensor-parallel-size=2后,推理速度比单卡快30%-50%,微调场景下,用LoRA技术,双卡能跑更大的batch size,训练收敛速度更快。
视频剪辑与3D渲染
达芬奇Resolve支持多GPU加速,双4060 Ti在时间线实时预览和导出编码时,能分担不同任务,Blender Cycles渲染器则通过--threads和CUDA设备列表,将一帧画面分割给两张卡分别渲染,最终合成,相比单卡,渲染时间大约缩短40%。
双4060 Ti与单卡方案的对比选择
很多人纠结是买两张4060 Ti还是一张4070 Ti Super,这里直接给对比。
| 项目 | 双4060 Ti(16G×2) | 单4070 Ti Super(16G) |
|---|---|---|
| 总显存 | 32GB(但需软件支持合并) | 16GB(无合并需求) |
| 算力总和 | 约44 TFLOPS(FP32) | 约44 TFLOPS(FP32) |
| 多任务并行 | 强,可同时跑两个独立任务 | 弱,只能排队 |
| 显存带宽 | 288GB/s×2 | 672GB/s |
| 故障冗余 | 一张卡挂了,另一张还能用 | 卡挂了就停工 |
| 价格 | 约7000元(两张) | 约6500元 |
| 功耗 | 320W | 285W |
从表格能看出,双卡的核心优势是多任务并行和显存总量,劣势是显存带宽减半,且需要软件适配,如果你主要跑大模型推理,更看重单卡带宽,那4070 Ti Super更省心;如果你要同时处理多个任务或超大模型,双4060 Ti更合适。
两张4060ti组服务器常见问题解答
双4060 Ti跑深度学习时,显存能自动叠加成32GB吗?
不能自动叠加,PyTorch默认单卡使用,必须通过accelerate库或device_map="auto"让模型层分散到两张卡上,手动指定cuda:0和cuda:1,TensorFlow则用tf.distribute.MirroredStrategy实现数据并行,如果软件不支持多卡,第二张卡就会闲置。
两张4060 Ti组服务器需要交火或SLI吗?
不需要,NVIDIA已不再为消费级显卡提供SLI驱动支持,4060 Ti本身也不支持,所谓“交火”是AMD的技术,与N卡无关,双卡协作完全靠CUDA层面的软件调度,跟硬件桥接无关。
电源功率怎么选才安全?
整机满载550W左右,但推荐850W,因为电源在50%-60%负载区间效率最高,且能为瞬时功耗留缓冲,如果电源只有650W,烤机时可能触发过载保护导致重启,另外注意显卡供电接口,部分非公版4060 Ti需要8Pin+8Pin,电源线材要匹配。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/759286.html