把状态外置到存储层,函数才能真正做到无状态,这是分布式系统设计中绕不开的底线。不管你是做微服务拆分、容器化改造,还是正在折腾Serverless架构,只要函数还揣着本地状态,扩容、重启、故障转移这三座大山迟早会压到你头上,下面我们把这个话题彻底聊透,顺便看看在实际项目里到底该怎么落地。
无状态函数为什么需要外部存储:先搞懂状态从哪来
行业共识认为,无状态并不是说系统里没有状态,而是状态压根不该待在函数进程内部,很多开发者一开始会犯一个直觉性错误把用户session、临时文件、业务计数直接塞进函数所在的内存或磁盘,这在单机时代没毛病,但一旦部署到多实例环境,问题立刻现出原形。
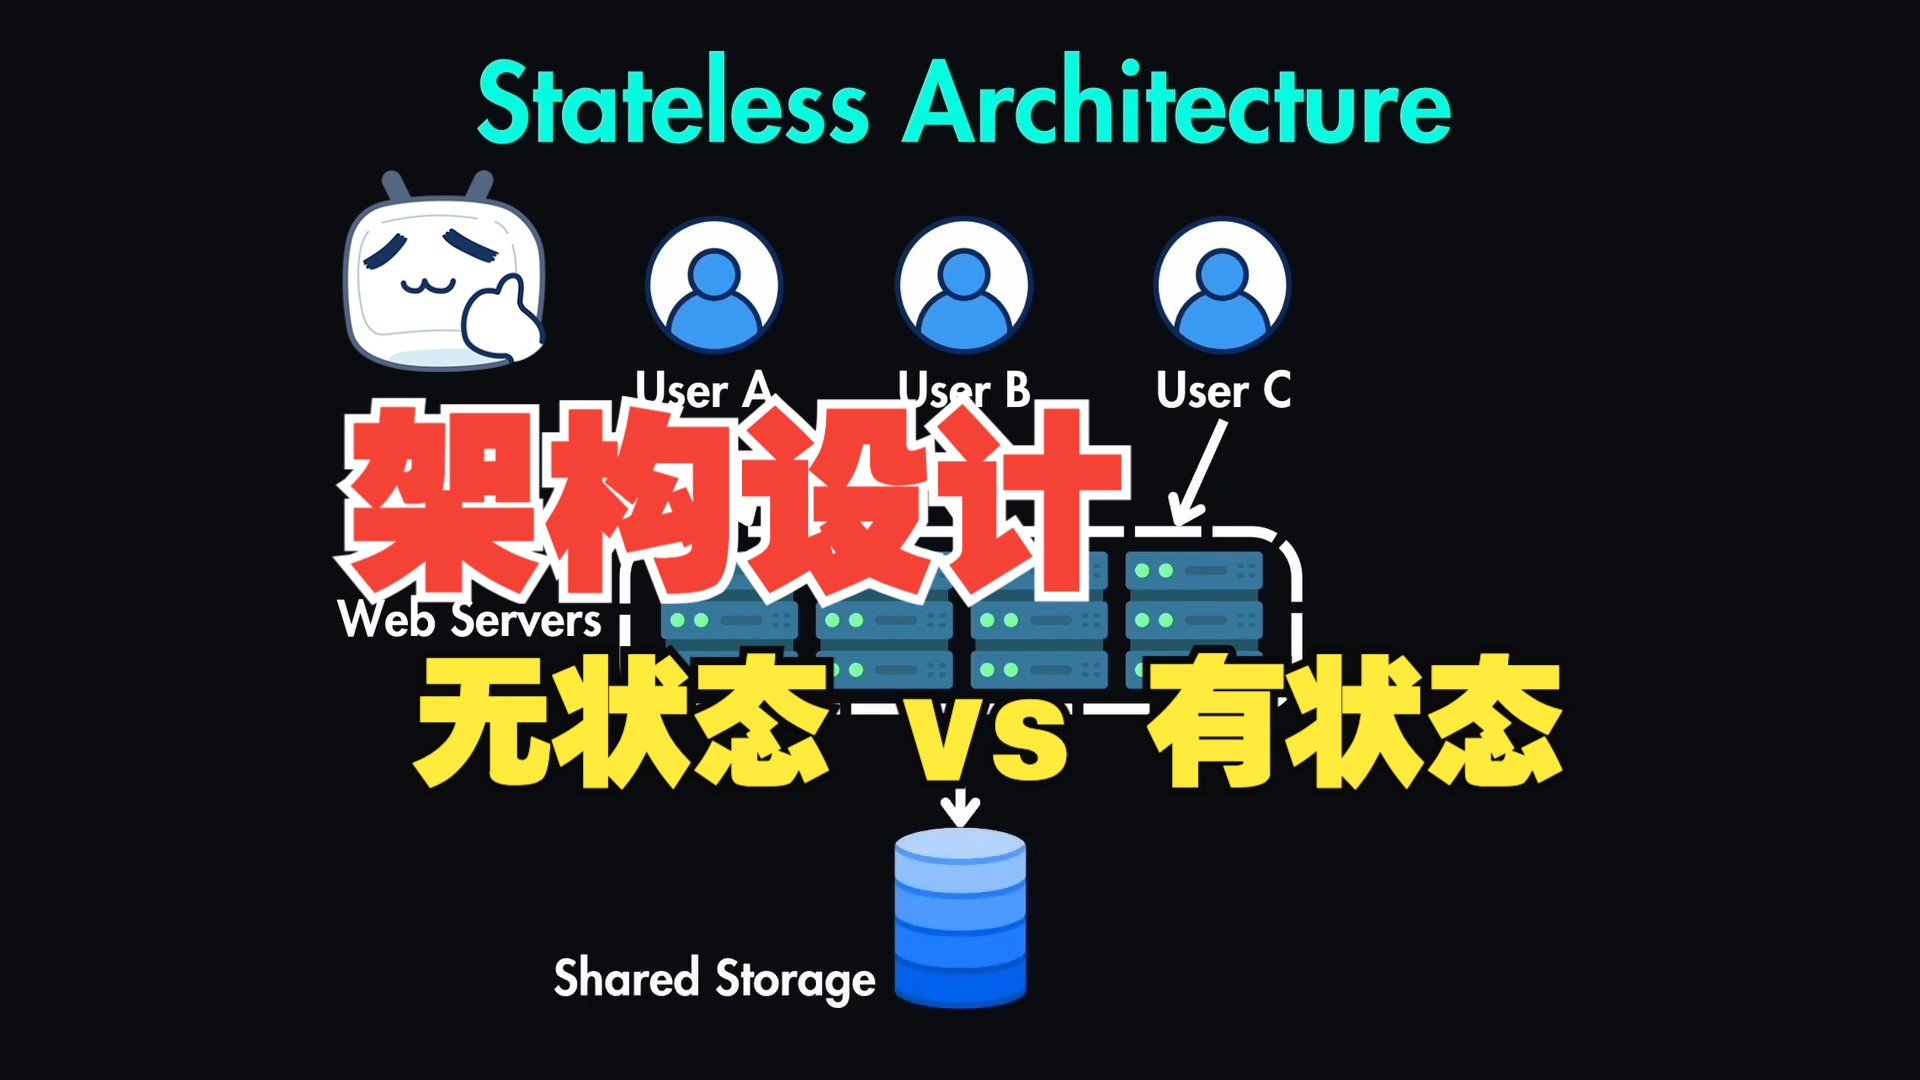
举个例子,你写了这样一个函数逻辑:用户登录后往本地内存里写一条session记录,下次请求直接读,在开发环境跑得欢,部署到Kubernetes里一缩放,负载均衡把第二个请求打到另一个Pod上,内存里翻个底朝天也找不到那条session,用户被强制登出还算小事,如果存的是购物车数据,那直接就是资损事故。
把状态外置到存储层,本质上是把“函数的临时记忆”变成了“系统的共享记忆”,函数只负责接收输入、处理逻辑、返回结果,所有可变数据统统交给远端的存储介质去管,这样一来,任何一台机器上的任何实例,面对同一个请求都能算出同样的结果,谁来处理请求根本不重要。
函数无状态化改造方案:五个常用存储选型对比
状态外置看似简单,选哪个存储却有讲究,不同状态类型、不同访问频率、不同一致性要求,对应的方案完全不是一回事。
Redis:适合高频读写的热状态
如果你需要存储的是session、分布式锁、实时计数这类读多写多、对延迟极度敏感的数据,Redis几乎是默认答案,业界做无状态化改造,八成以上场景首选Redis,原因就俩字:快,而且数据结构丰富。
操作路径也很直接:把原本函数内存里的Map或List换乘Redis的Hash或ZSet,然后通过客户端SDK读写,需要注意的点是必须设置过期时间,否则僵尸key堆积起来,Redis内存迟早爆掉,到时候就不是无状态改造问题,而是运维事故了。
MySQL/PostgreSQL:适合强一致性的核心业务状态
订单状态、账户余额、库存数量,这类关系型数据想都别想,直接落库,很多团队纠结性能问题,其实这是伪命题函数挂了业务还能忍,数据错了那就是原则问题,行业数据表明关系型数据库在事务支持和ACID保证上依然是无可替代的存在。
改成走数据库之后,通常需要配合连接池组件,比如HikariCP或Druid,并且要注意事务边界必须控制在函数单次调用内,业内专家指出,超过2/3的分布式数据不一致问题,根源都是事务跨了多次函数调用。
对象存储:适合大文件和小文件混杂的场景
头像图片、导出报表、用户上传的附件,这类数据扔到云上的OSS或S3就行,好处是不占函数本地磁盘,也天然支持CDN加速,前端拉取静态资源根本不需要回源到你的业务服务器。
本地磁盘:唯一合法的使用场景是临时缓存
也别把话说死,函数挂一块临时盘也不是完全不行,但必须接受两个前提是可有可无的缓存,或者即使丢失也能自动重建,比如存放一份从配置中心拉下来的配置快照,每次更新时回源校验,但凡数据丢了会报错、会丢钱、会引发客诉,就不该呆在本地。
分布式缓存中间件:一致性要求更高的场景
如果你觉得单机Redis不够稳,可以上Codis、Tendis或云厂商提供的分布式缓存产品,区别在于这些中间件帮你做好了分片和高可用,函数侧根本感知不到后端到底有几台机器。
| 存储类型 | 适合状态 | 延迟 | 一致性 | 典型成本 |
|---|---|---|---|---|
| Redis | 会话/缓存/计数 | 亚毫秒 | 最终一致 | 内存成本 |
| MySQL | 订单/账户 | 毫秒级 | 强一致 | 运维成本 |
| 对象存储 | 文件/图片 | 稍高 | 强一致 | 存储成本 |
| 本地磁盘 | 临时缓存 | 最快 | 不保证 | 极低 |
无状态服务状态存在哪里:改造过程中的四个实操步骤
理论说得再好,不落地都是白搭,这里直接给一套可复用的改造路径,按照这个顺序做,能少踩不少坑。
-
盘点函数内部所有可变数据:打开代码库,把每个类里的非final字段、每个静态变量、每个写文件的逻辑全部列出来,这一步要求有点耐心,很多状态隐藏得很深,比如日志对象内部可能维护了buffer,凡是看到synchronized关键字的地方,优先怀疑是不是有共享状态。
-
按数据性质打标签:分成“会话类”“业务类”“临时缓存类”“配置类”四堆,分完之后你会惊讶地发现,真正需要外置的通常只占三成左右,剩下的要么能删,要么能改成只读配置。
-
选定存储并迁移代码:Redis解决会话和缓存,MySQL解决业务数据,配置类统一挪到配置中心,改代码时建议先接存储再删本地变量,保持可回滚状态。
-
验证无状态性:最有效的验证方式就是杀进程,随机杀掉正在运行的生产实例,然后观察整体服务是否依然正常,如果杀掉一个实例后所有请求仍然能成功处理,那说明改造基本到位了,更严谨的做法是写一个混沌测试脚本,定期自动杀实例,并断言错误率为零。

以Java Spring Boot项目为例,改造前你可能用了@SessionAttributes或者ConcurrentHashMap存数据,改造后需要用Spring Session配上Redis,把spring.session.store-type设成redis,然后加一段初始化脚本确保Redis里建好索引,部署完跑一遍全链路测试,重点看看session还能不能续上。
无状态函数的设计边界:哪些状态根本不该被外置
说了半天外置,有些东西你反而要警惕不是所有状态都需要塞进存储层,强行外置只会把简单问题搞复杂。
可计算的状态别外置,典型的比如用户年龄,你存了出生日期就能算出来,那就不用在Redis里再放一份,类似的还有总额统计,能用明细算出来的,就不要单独存一个“总额”字段。
一次性状态别外置,消息队列里的消费位点、分布式事务里的分支事务状态,这些跟着业务生命周期走的状态,丢给存储层保管反而会导致清理逻辑变得一团糟,正确的做法是让消息队列自己管位点,让事务管理器自己记状态。
噪音状态别外置,比如函数内部的临时排序结果、一次性流水号生成,这种东西外置出去的开销比重新计算还大,无状态不代表愚蠢,该在函数内做的临时计算还是要做,只是这个计算不产生跨请求依赖而已。
无状态和外置存储之间的成本账
你可能会问,把状态扔到存储层,网络开销变大了,这代价划算吗?短期看确实多了一次RTT,但算总账会发现收益大得多。
- 扩容从分钟级变秒级:原来一个实例只能扛10个并发,现在能无限水平扩展,高峰期多加20个实例,负载均衡自动分发,哪个实例都不欠谁的数据。
- 故障恢复时间趋近于零:某个实例宕机了,流量自动切到另一个,用户根本感知不到,原来可能得花半小时捞日志、重启、补数据。
- 代码可读性大幅提升:函数没有隐藏状态,输入-输出对完全自解释,新同事接手代码不用猜这个局部变量是不是在别处被修改过,某种程度上,无状态化改造等于免费的代码重构。
以跨境电商场景为例,每到促销节点流量峰值能达到平日的几十倍,如果用老架构,运维在活动前三天就开始扩机器、调参数,活动当晚还睡不安稳,改成无状态架构之后,状态都在存储层,应用层随便扩缩容,运维只需关注存储集群的容量和水位线就行。
无状态函数的存储层选型要避免的坑
最后提醒几个翻车重灾区,这些坑基本每个搞过无状态改造的团队都会踩一遍。
坑一:Redis挂了全站瘫痪,Redis作为状态存储解决了函数的状态问题,但它自己成了单点,因此一定要做哨兵或集群模式,并且开启持久化策略,AOF刷盘频率设置为everysec比较合适,兼顾性能和数据安全。
坑二:网络分区导致数据不一致,跨可用区部署时,专线抖动会导致函数读不到存储层的数据,改造时就要想清楚失败策略,比如读不到session就静默重新登录,而不是抛500,用Hystrix或Sentinel做降级隔离,是每个函数调用存储层前都应该具备的标配。
坑三:存储层连接数被打爆,函数的冷启动特性意味着客户端连接不用就断,数量一上来很容易占满存储层的连接上限,解决方案是使用连接池做收敛,同时在Storage端开启连接复用,一般设置最小空闲连接数10、最大连接数50就够用了。
把状态外置到存储层不是一个可选项,而是一个必选项,只要你的函数要部署在多个实例上、要应对突发流量、要承受硬件故障,这条路就是唯一解,越早完成这个转变,你的架构就越接近那种“随便拆、随便扩、随便挂”的理想状态。记住一句话:无状态的函数是廉价的打工仔,有状态的存储层才是真正的老板,让打工仔随处可换,让老板稳如泰山,这个系统才能睡得着觉。
无状态函数为什么需要外部存储:常见问题解答
函数用库表缓存算不算状态外置?
不算完整外置,库表缓存如果保存在函数JVM内部、用来减少对存储层的查询,这本质上是本地状态,一旦实例重启缓存就丢了,会造成缓存击穿或短暂不一致,标准做法是用Redis这类独立缓存,函数侧无状态,缓存侧挂掉也有存储兜底,如果你只是想减轻数据库压力,优先在函数和存储之间加一级Redis,而不是在函数内部做二级缓存。
无状态化改造需要重写多少代码?
多数情况下无需重写业务代码,改动集中在数据访问层,Spring生态里切换本地Session到Redis Session通常只改配置和加依赖,业务代码里的session.setAttribute和session.getAttribute完全不用动,真正麻烦的是那些静态变量和本地文件写入的逻辑,需要手工挪到存储层,小工程一两百行改动能完成,大工程如果有跨模块共享状态则可能涉及接口调整,建议按模块逐个推进,每个模块都跑一遍序列化兼容性测试再上线。
改了无状态之后接口性能会不会变差?
取决于网络延迟和存储选型,通常只会增加几百微秒的开销,在局域网内Redis读写普遍在0.5毫秒内,加上序列化和连接池开销也不超过2毫秒,相比原来本地内存的几十纳秒确实慢了,但换来的是可靠性翻了几个数量级,只要业务接口原本的响应时间在50毫秒以上,完全感知不到差异,但如果函数和存储层跨地域部署,比如函数在国内存储却在海外,那个延迟差就是两个数量级了,所以无状态化改造的前提是把存储层放在同一可用区或同地域内。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/638156.html