构建数据仓库的核心原因在于打破数据孤岛,将分散、杂乱的业务数据转化为统一、可信的决策资产,从而支撑企业从“凭经验做事”向“凭数据说话”的根本性转变。
在数字化浪潮席卷全球的今天,企业每天产生的数据量呈指数级增长,面对来自ERP、CRM、电商后台、社交媒体等各个渠道的海量信息,如果仅仅把它们堆砌在普通的数据库里,不仅查询速度慢如蜗牛,更难以从中提炼出有价值的商业洞察,这就是为什么越来越多的企业开始重视数据治理,并着手搭建专门的数据存储与分析平台。
解决数据孤岛与提升查询效率的必要性
很多企业在发展初期,为了快速上线业务,往往采用“烟囱式”的系统建设模式,这种模式下,每个业务系统都拥有自己的数据库,数据彼此隔离。
打破部门间的数据壁垒
想象一下,销售部门想知道某个客户的复购率,需要联系市场部获取用户画像,再找财务部核对付款记录,最后让IT部门从后台导出原始日志,这种跨部门的数据流转不仅效率极低,而且极易出错,业内专家指出,构建统一的数据存储层能够彻底消除这种协作摩擦。
通过建立中央数据枢纽,企业可以实现以下目标:
- 统一数据标准:将不同来源的数据进行清洗和标准化,确保“客户ID”在销售系统和客服系统中代表同一个实体。
- 消除重复劳动:分析师无需每次重新编写复杂的SQL语句去拼接多个系统的数据,只需从统一的数据集市获取即可。
- 提高数据一致性:避免因口径不一导致的决策失误,比如财务统计的营收与销售统计的营收出现巨大差异。
应对海量数据的性能瓶颈
传统的在线事务处理(OLTP)数据库擅长处理高频的增删改查操作,比如用户下单、支付扣款,但如果要在这些数据库上进行大规模的历史数据分析,比如分析过去五年的销售趋势,往往会拖慢甚至拖垮生产系统。
将分析型负载从生产库中剥离出来,是构建数据仓库的关键一步,这种架构分离带来了显著的性能提升:
- 读写分离:生产系统专注于事务处理,数据仓库专注于复杂查询,互不干扰。
- 列式存储优化:数据仓库通常采用列式存储引擎,在聚合分析场景下,查询速度比传统行式存储快

10倍以上。
- 并行计算能力:现代数据仓库支持分布式并行计算,能够轻松处理PB级别的数据量,而传统数据库可能在TB级别就出现性能瓶颈。

支撑复杂分析与历史趋势追踪
业务系统通常只保留当前活跃的数据,或者只保留最近几年的记录,但对于战略规划来说,历史数据的完整性至关重要。
保留完整的历史快照
在电商场景中,商品的价格、库存、描述可能会频繁变动,如果直接查询业务数据库,你只能看到当前状态,无法知道一个月前这个商品卖多少钱,数据仓库通过“缓慢变化维”(SCD)技术,能够完整记录数据随时间变化的轨迹。
这种能力对于以下场景不可或缺:
- 价格弹性分析:对比不同时间段同一商品的价格变化与销量关系,优化定价策略。
- 用户行为演变:追踪用户从注册、首次购买到流失的全过程,识别关键转化节点。
- 合规审计:满足金融、医疗等行业对数据变更留痕的严格监管要求。
支持多维度的即席查询
业务人员的需求往往是多变且不可预测的,他们可能需要按地区、按产品线、按时间段、按渠道等多个维度自由组合进行查询,如果每次需求都让开发团队重新写代码,响应周期太长,会严重阻碍业务敏捷性。
数据仓库通过预建模和数据集市(Data Mart)的方式,为业务人员提供了自助式分析的能力。
- 数据建模:分析师将原始数据转化为星型或雪花型模型,形成易于理解的业务主题。
- 指标封装:将复杂的计算逻辑封装成标准指标,如“毛利率”、“活跃用户数”。
- 自助探索:业务人员通过BI工具拖拽字段,即可快速生成报表,无需编写SQL代码。
保障数据安全与提升数据质量
数据是企业最核心的资产之一,其安全性和准确性直接关系到企业的生命线。
集中化的权限管控
在分散的数据架构下,权限管理极其复杂,不同系统的管理员权限不一致,容易导致敏感数据泄露,构建统一的数据平台后,可以实现集中化的权限管控。
具体操作包括:
- 角色定义:根据职位定义数据访问角色,如“数据分析师”、“财务专员”、“高管”。
- 行列级权限:精细控制到具体字段,普通客服只能看到用户脱敏后的手机号,而客服主管可以看到完整信息。
- 操作审计:记录所有数据的访问、查询和导出行为,确保责任可追溯。

数据清洗与质量监控
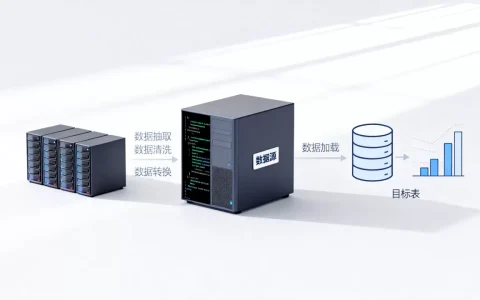
原始数据中往往充斥着脏数据,如重复记录、缺失值、格式错误等,如果直接使用这些数据进行决策,结果将毫无意义,数据仓库在ETL(抽取、转换、加载)过程中,内置了严格的数据清洗规则。
在导入销售数据时,系统会自动执行以下检查:
- 完整性检查:确保订单ID、金额等关键字段不为空。
- 一致性检查:确保订单金额与商品单价乘以数量一致。
- 有效性检查:确保日期格式正确,且不存在未来的交易日期。
据统计,多数企业在数据准备阶段花费的时间超过80%,而在数据仓库中固化这些清洗逻辑,可以大幅减少重复劳动,提高数据可信度。
如何选择合适的数据仓库解决方案
面对市场上琳琅满目的数据仓库产品,企业该如何选择?这取决于企业的规模、技术栈和预算。
云原生 vs 本地部署
近年来,云原生数据仓库因其弹性伸缩、免运维的优势,成为许多企业的首选。
| 对比维度 | 本地部署数据仓库 | 云原生数据仓库 |
|---|---|---|
| 初始成本 | 高(需购买硬件服务器) | 低(按需付费,无硬件投入) |
| 扩展性 | 差(需停机扩容,周期长) | 好(秒级弹性伸缩,支持海量数据) |
| 运维复杂度 | 高(需专业DBA团队维护) | 低(厂商负责底层维护,专注上层应用) |
| 适用场景 | 数据敏感度高、有严格合规要求的国企或政府机构 | 互联网企业、中小企业、快速成长的创业公司 |
主流技术选型参考
对于国内企业而言,选择数据仓库时还需考虑生态兼容性。
- 国内主流平台:如阿里云MaxCompute、华为云GaussDB、腾讯云TDSQL等,这些平台与国内的大数据生态(如Hadoop、Spark)集成良好,且符合国内数据合规要求。
- 开源方案:
如Apache Hive、ClickHouse、StarRocks,适合拥有强大技术团队、希望完全掌控底层架构的大型企业。
- 国际主流方案:如Snowflake、BigQuery,适合有出海业务或跨国协作需求的企业。

构建数据仓库的常见误区与避坑指南
许多企业在建设数据仓库时容易陷入误区,导致项目失败或效果不佳。
一上来就追求大而全
不要试图一次性建成涵盖所有业务领域的数据仓库,正确的做法是“小步快跑”,优先解决最痛点的数据分析问题,先从销售数据入手,打通销售与库存数据,快速产生业务价值,再逐步扩展到其他领域。
忽视数据治理
数据仓库不是垃圾桶,不能把脏数据直接丢进去,在构建初期,就必须建立数据标准和质量监控机制,否则,随着数据量的增加,“垃圾进,垃圾出”的问题会愈发严重,最终导致用户对数据失去信任。
重技术轻业务
数据仓库建设的核心目标是赋能业务,而不是展示技术实力,在建模阶段,必须深入业务场景,与业务人员充分沟通,确保数据模型贴合实际业务逻辑,否则,做出来的报表再漂亮,业务人员也用不起来。
常见问题解答
数据仓库与数据湖有什么区别?
数据仓库主要存储经过清洗、结构化的高质量数据,适合做精确的报表分析和商业智能(BI)查询,强调数据的准确性和一致性,数据湖则存储原始数据,包括结构化、半结构化和非结构化数据,适合做机器学习、深度探索和分析,强调数据的灵活性和多样性,现代架构通常采用“湖仓一体”,结合两者的优势。
中小企业有必要构建数据仓库吗?
对于数据量较小、业务逻辑简单的中小企业,可能不需要构建完整的数据仓库,可以使用轻量级的BI工具直接连接业务数据库,或者使用云上的Serverless数据服务,只有当数据量达到一定规模,或者业务复杂度导致数据孤岛问题严重时,才需要考虑构建独立的数据仓库。
构建数据仓库需要多长时间?
这取决于企业的规模和数据复杂度,一个小型的数据仓库项目,从需求调研到上线,可能需要1-3个月,而大型企业的核心数据仓库建设,往往需要6-12个月甚至更久,建议采用敏捷开发模式,分阶段交付,让用户尽早看到价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e4%b8%ba%e4%bb%80%e4%b9%88%e8%a6%81%e6%9e%84%e5%bb%ba%e6%95%b0%e6%8d%ae%e4%bb%93%e5%ba%93%ef%bc%8c%e6%95%b0%e6%8d%ae%e4%bb%93%e5%ba%93%e7%9a%84%e4%bd%9c%e7%94%a8/