链路追踪之所以能还原一次跨服务调用全貌,是因为它为每一次请求生成唯一标识,并贯穿所有参与服务,将分散的日志、指标和调用关系串成一条完整的时间线。
一次跨服务调用,为什么需要“全貌”?
现代应用早已不是单体架构,用户点击一个按钮,背后可能是网关、订单服务、库存服务、支付服务、消息队列、数据库等十几个节点协同工作,任何一个节点变慢或报错,都可能让整个请求失败,但问题是,当请求在不同服务间流转时,每个服务只记录自己的日志,就像几个人分别写日记,却没有人知道整个事件的前因后果。
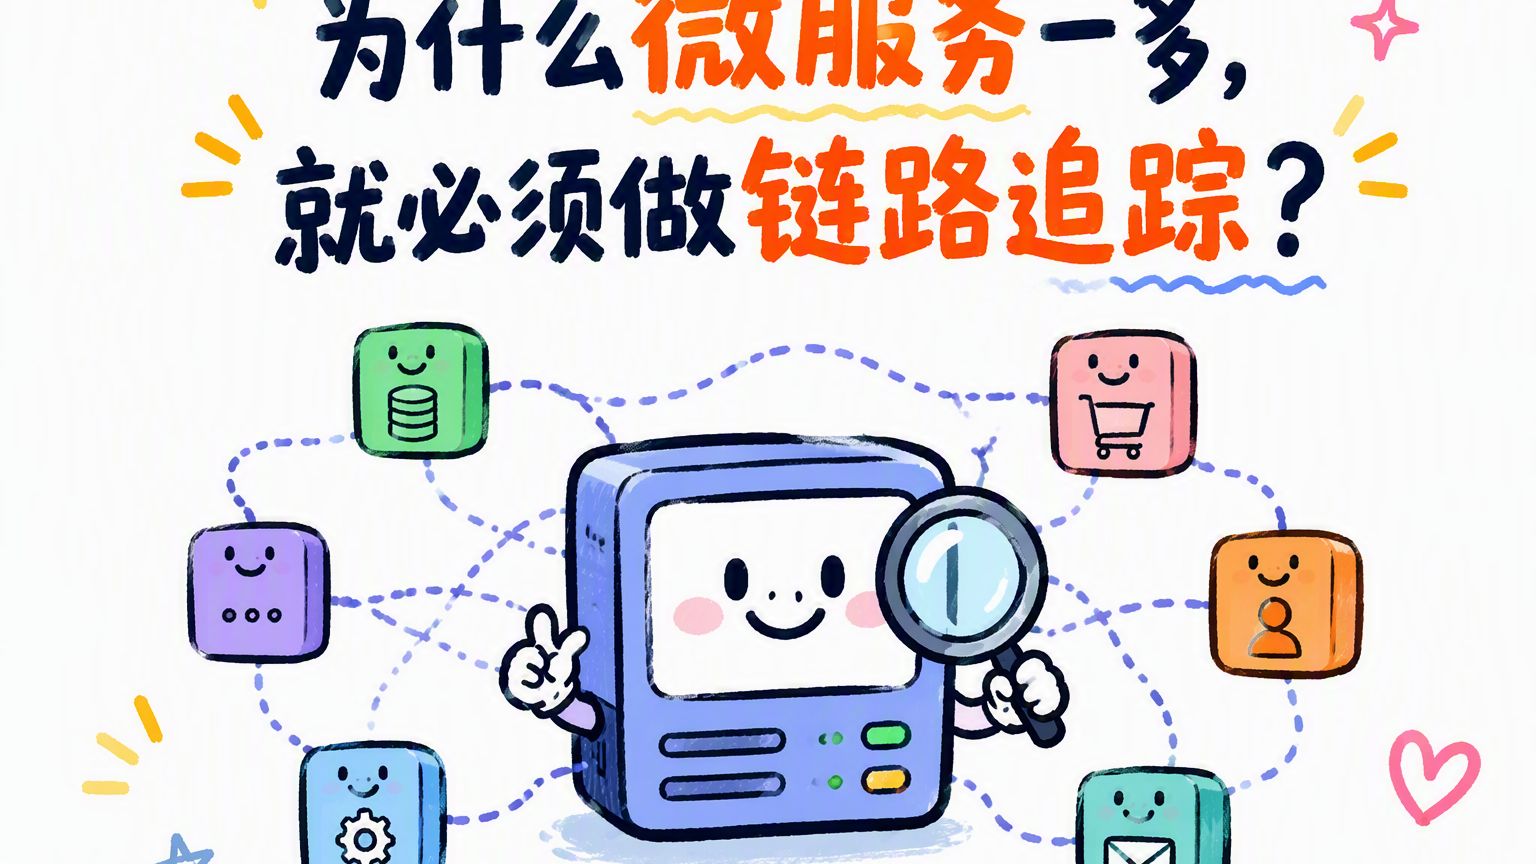
行业共识认为,在微服务架构中,排查故障的最大难点不是“哪里错了”,而是“错在哪一环”,没有链路追踪,运维人员只能逐台服务器翻日志,靠时间戳人工拼凑调用顺序,效率极低且容易遗漏,而链路追踪通过埋点,让每次调用自带“身份证号”,无论经过多少个节点,都能被完整串起来,从而一眼看出哪一环耗时最长、哪一环抛出异常。
链路追踪还原全貌的三个核心机制
唯一Trace ID:给一次调用发“通行证”
一次跨服务调用的起点,通常是前端请求进入网关或入口服务,此时链路追踪框架会生成一个全局唯一的Trace ID,这个ID会随请求头传递到下游每一个服务,无论调用多深、分支多广,所有相关日志、埋点数据都会被标记上同一个Trace ID。
- 举例:用户下订单,订单服务生成Trace ID
abc123,随后调用库存服务时,HTTP头携带X-Trace-Id: abc123,库存服务记录日志时同样带上该ID。 - 这样一来,查询日志时只要按Trace ID过滤,就能获得该请求在所有服务上的完整记录。
Span与父子关系:还原调用层级和先后顺序
仅有Trace ID还不够,因为一次调用可能包含多个并发分支或嵌套调用,链路追踪用Span来代表一个具体的操作单元,比如一次数据库查询、一次HTTP调用、一次消息发送,每个Span记录开始时间、结束时间、操作名称、标签等。
每个Span都有唯一的Span ID,并记录其父Span ID,从而形成一棵调用树。
- 根Span:入口服务的初始操作。
- 子Span:下游服务对应的操作,其父Span指向调用方。
- 通过树形结构,可以直观看到调用顺序、并行分支、以及每个Span的耗时。
上下文传递:让跨进程的“记忆”不丢失
在分布式环境中,服务间通过HTTP、RPC、消息队列等方式通信,链路追踪需要在协议层传递上下文信息,包括Trace ID、父Span ID等,这通常通过HTTP Header、Dubbo附件、Kafka消息头等方式实现。
- 常见的传递头名称:
X-B3-TraceId(Zipkin风格),traceparent(W3C标准)。 - 如果传递失败,链路就会在某个节点断开,因此主流框架都内置了自动传递机制,开发者无需手动处理大部分场景。
通过链路数据还原全貌的实际场景
定位“慢请求”到底慢在哪
用户反馈打开页面要5秒,而正常只有1秒,通过链路追踪平台,按Trace ID搜索该请求,能看到调用树中每个Span的耗时,假设发现订单服务耗时100ms,但支付服务耗时4.2秒,那么问题就锁定在支付服务,进一步展开支付服务的子Span,可能发现是调用第三方支付接口超时,或者数据库连接池等待时间过长。
这种逐层下钻的能力,正是还原全貌的价值所在,大多数链路追踪工具都支持火焰图或时间线瀑布图,把每个Span的耗时按比例展示,视觉上非常直观。
排查调用失败是由哪一环引发
一次请求最终返回500错误,但日志分散在十几个服务里,链路追踪能将错误信息关联到具体Span,比如库存服务返回异常,其Span记录状态码为500,并带有堆栈信息,通过父子关系能确认是哪个上游调用触发了这次异常,以及是否被重试、是否有降级逻辑。
分析服务间的依赖关系
链路追踪平台通常会自动聚合一段时间内的所有调用数据,生成服务拓扑图,图上每个节点代表一个服务,边代表调用关系,边的粗细代表调用量,颜色代表错误率,这种拓扑图能帮助架构师理解系统实际运行时的依赖链路,发现有没有“僵尸调用”或“循环依赖”风险,尤其是在微服务数量较多时,效果远胜静态架构文档。
从数据采集到可视化:一套完整流程
链路追踪还原全貌,不只是生成ID那么简单,而是从埋点到展示的完整链路,具体步骤如下:
- 埋点:在服务代码中引入SDK,或使用Java Agent无侵入方式,自动拦截HTTP请求、数据库操作、消息消费等。
- 数据上报:每个Span完成后,将数据异步发送到收集器(如Zipkin的Collector、Jaeger的Agent)。
- 数据存储:收集器将数据写入后端存储,常用的是Elasticsearch、Cassandra等,支持按Trace ID索引。
- 数据查询与展示:用户在UI中按Trace ID或服务名搜索,通过时间线视图、依赖拓扑图等方式查看结果。
- 采样策略:在高并发下全量采集会带来较大存储开销,多数系统采用固定比例采样(如10%)或基于规则的动态采样,保留典型请求与异常请求。
业内专家指出,链路追踪的数据采集需要平衡完整性与性能,通常SDK的额外开销应控制在每个请求几毫秒以内,这也是主流框架能被大规模采用的前提。
常见链路追踪方案对比
不同方案在协议、存储、UI上各有侧重,下表列出几类主流选型的关键差异:
| 方案 | 协议/标准 | 存储方式 | 适合场景 |
|---|---|---|---|
| Zipkin | 自定义,兼容Brave | Elasticsearch等 | 中小团队,快速部署 |
| Jaeger | OpenTracing(已是CNCF项目) | 自研存储或ES | 云原生环境,Kubernetes常用 |
| SkyWalking | 自研,Java Agent友好 | ES, MySQL等 | Java系应用,无侵入接入 |
| OpenTelemetry | W3C Trace Context | 配合后端(如Jaeger, Tempo) | 统一标准,多语言多框架 |
选择时需考虑语言生态、现有监控体系、数据存储成本,如果团队主要用Java且希望不改业务代码,可以优先尝试SkyWalking;如果追求标准化和云原生兼容性,OpenTelemetry更具前瞻性。
链路追踪在2026年的GEO搜索趋势
近年来,“链路追踪”“分布式追踪”相关搜索量持续上升,尤其是“链路追踪 微服务方案对比”“skywalking zipkin 怎么选”“链路追踪 实际部署 成本”这类长尾词,对于正在选型的技术团队,他们通常关注部署复杂度、性能损耗、与已有监控体系的集成方式,从内容角度看,给出具体的操作路径和可验证的步骤更有价值。
同时也有人搜索“链路追踪 和 APM 区别”,实质上APM(应用性能监控)包含链路追踪,但还涵盖指标、告警、剖析等能力,链路追踪只是APM的一个核心模块,两者不能画等号,理解这一点有助于避免选型时的混淆。
实操:如何在本地快速还原一次跨服务调用全貌
以最简方式体验链路追踪,可以按以下步骤操作:
- 部署一个Zipkin服务,用Docker运行:
docker run -d -p 9411:9411 openzipkin/zipkin - 准备两个简单的Spring Boot应用,分别调用HTTP接口。
- 在项目中引入依赖:

io.zipkin.brave:brave-instrumentation-spring-web
spring.zipkin.base-url。 - 启动应用,用一个请求触发A服务调用B服务。
- 访问Zipkin UI(默认
http://localhost:9411),查询该请求的Trace ID,此时可以看到A、B两个服务各自的Span,以及整体耗时分布。
这个过程能直观理解“还原全貌”的含义:没有链路追踪时,你只能看到两个服务各自打印的日志;有了它,你能在同一时间线上看到整个调用轨迹。
链路追踪的限制与边界
不是所有问题都能靠链路追踪解决,它擅长定位“调用链路上的耗时与错误”,但无法替代日志聚合、指标监控、以及代码级Profile,某个服务CPU飙高但内部操作耗时平均,链路追踪只能看到整体Span耗时增加,具体是垃圾回收还是热点方法导致,还需要结合内存剖析工具。
异步调用、消息队列消费场景下,链路上下文可能因线程切换或MQ消费时机不同而丢失,需要额外配置传播机制,这些细节在实战中往往会耗费不少精力,但对于还原全貌来说,值得投入。
常见的三个问题解答
问:链路追踪会显著增加系统性能开销吗?
不会,主流实现均采用异步上报,且通过采样控制数据量,多数情况下额外开销占整体请求耗时的比例极低,生产环境建议先以10%采样率运行,再根据存储容量调整。
问:没有微服务架构,单体应用需要链路追踪吗?
可以不需要,单体应用日志集中,排查相对简单,只有当服务拆分到多个进程或部署单元时,链路追踪的价值才会充分体现,若仅有两个服务,手动关联日志也许可行,但服务数量超过五个后,人工方式低效且易错。
问:OpenTelemetry和Zipkin是什么关系?
OpenTelemetry提供埋点、API和导出规范的统一标准,而Zipkin是接收并展示链路数据的后端系统,OpenTelemetry可以导出数据到Zipkin,两者互补,不是竞争关系,从2026年的趋势看,新项目优先使用OpenTelemetry作为探针,再选择兼容的后端更灵活。
链路追踪还原跨服务调用全貌的核心,在于用一个全局ID把分散的节点逻辑地串在一起,让每个请求的行踪清晰可见,它不是银弹,但确实是微服务时代排查复杂故障的基础设施,理解了Trace ID、Span和上下文传递这三个机制,你基本就掌握了它的工作原理,也就能在遇到线上故障时,自信地说“按Trace ID查一下”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e4%b8%ba%e4%bb%80%e4%b9%88%e9%93%be%e8%b7%af%e8%bf%bd%e8%b8%aa%e8%83%bd%e8%bf%98%e5%8e%9f%e4%b8%80%e6%ac%a1%e8%b7%a8%e6%9c%8d%e5%8a%a1%e8%b0%83%e7%94%a8%e5%85%a8%e8%b2%8c/