静态资源和大文件更适合走四层转发,因为四层转发只看IP和端口,不拆解应用层内容,省掉了七层代理的解析开销,而静态资源传输本身不需要这些额外心智,直接寻址、直达主机,效率最高。
同样一台服务器,七层代理可能先被CPU耗尽,四层转发还能扛住更大的带宽和并发,下面把这个结论拆开,聊清楚背后的逻辑。

四层转发和七层负载均衡区别:到底差在哪
四层转发像快递分拣中心,只看包裹上的地址,不关心里面装的是衣服还是书,七层代理则像安检员,每个包裹都要拆开检查内容,甚至还要重新打包。
两者处理任务的层级不同,决定了它们各自的性能边界。
- 四层转发:工作在网络传输层,基于IP、端口、协议号转发,不关心数据内容是HTML、图片还是视频,数据包经过时只做快速匹配和转发,像专线快递。
- 七层负载均衡:工作在应用层,要解析HTTP请求,理解URL、Header、Cookie,甚至要缓存、压缩、重写,负载能力取决于应用层逻辑的复杂度。
| 维度 | 四层转发 | 七层负载均衡 |
|---|---|---|
| 处理层级 | IP/端口/TCP | HTTP/HTTPS内容 |
| 性能开销 | 低 | 高 |
| 支持协议 | TCP/UDP | HTTP/GRPC/WebSocket等 |
| 适用场景 | 大文件、视频、数据库连接 | 微服务路由、API网关 |
| 数据返回路径 | 部分方案可后端直接回包 | 必须经过代理 |
光看表格可能不够直观,重点在于“数据路径”的不同。
静态资源用四层还是七层,先看数据路径
用户请求一个视频文件的完整路径:
- 七层代理:客户端请求先到代理服务器,代理收完HTTP头,连接后端,再同时从后端读数据和向客户端写数据,每一份文件都经过多次数据拷贝,大文件会迅速占满内存。
- 四层转发:数据包进来,匹配规则,直接送给后端,多数情况下,返回数据可以从后端服务器直接发给客户端,不经过转发节点,形成“三角传输”。
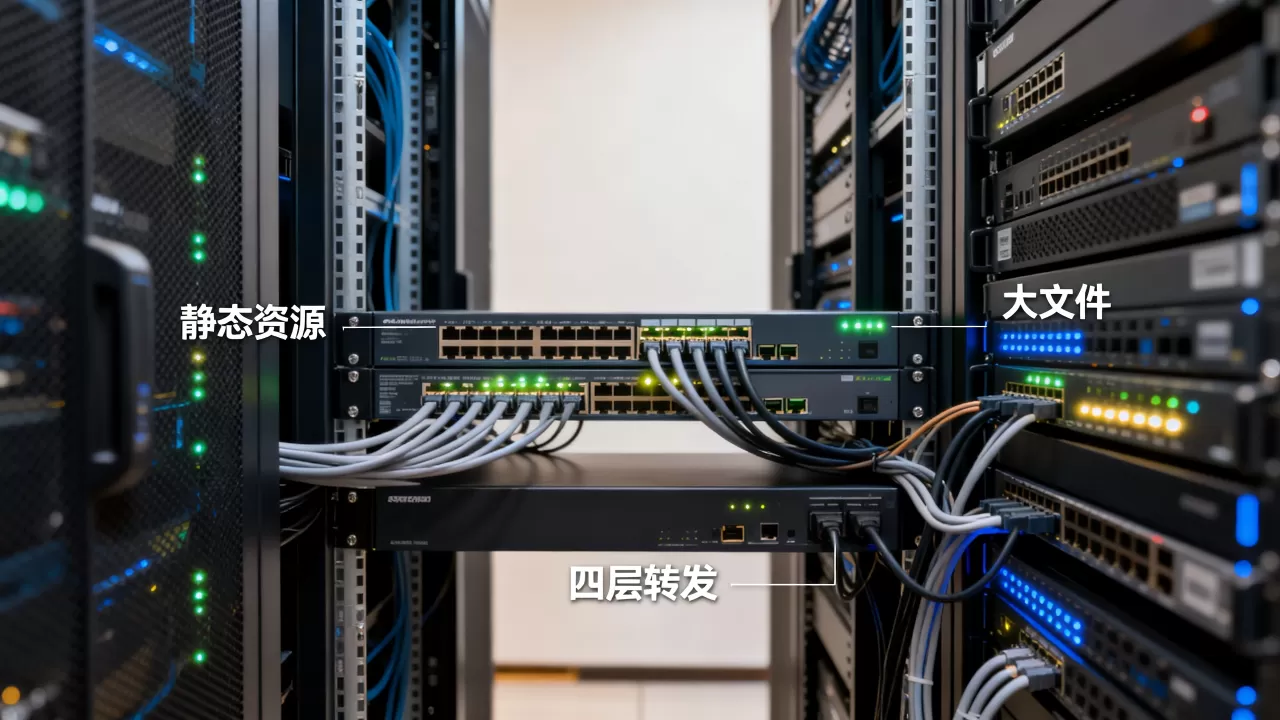
大文件下载场景下,七层代理中的Nginx需要把一个几GB的安装包从磁盘读到内核缓冲区,再复制到用户态,再通过socket发给客户端,四层转发则不关心文件内容,甚至可以使用零拷贝技术让网卡直接把数据发出去。CPU消耗差一个数量级。
行业共识认为,七层代理的瓶颈大多不是带宽,而是代理进程对每个连接、每个请求的上下文维护和内存拷贝,连接数上去后,内存占用先飙升,CPU也跟着遭殃。
为什么静态资源天生适合四层转发:四个硬理由
静态资源与大文件有以下四个特点,和四层转发的优势高度契合。
- 静态资源没有“路由逻辑”:不需要根据URL做业务判断,域名和路径已经在DNS和边缘层分好了,四层转发只需要按IP和端口把流量送进后端。
- 大文件传输时间长:连接占用是长期的,四层转发的连接表项比七层的连接对象轻量得多,后端连接多了也不容易崩。
- 用户端网络慢:下载速度由客户端网络决定,七层代理的缓冲机制反而会加剧堵塞,四层转发不管这层逻辑。
- 横向扩展容易:四层转发直接指到多台文件服务器,后端可以独立回包,不需要同步会话状态,扩容时只加机器就行。
动静分离:把七层留给接口,把四层留给文件
实际部署中,很多团队把API域名和静态资源域名分开。api.example.com 走Nginx七层做鉴权限流,cdn.example.com 走LVS四层转发到对象存储网关,这样做的好处是,七层只处理短小请求,不会被大文件拖垮;四层专心转发大流量,各司其职。
操作路径参考:
- 为静态域名创建独立的VIP,DNS解析到该VIP。
- 用LVS DR模式,后端服务器和四层转发节点在同一二层网络。
- 在后端服务器上配置VIP到回环接口,并抑制ARP广播。
- 用
ipvsadm -A -t VIP:80 -s wrr建立转发规则。 - 添加后端节点:
ipvsadm -a -t VIP:80 -r 后端IP:80 -g。 - 用keepalived监控VIP和节点状态。
完成之后,大文件的响应流量直接从后端服务器返回给用户,转发节点只承担请求方向的流量,压力很小。
大文件下载用什么负载均衡:LVS 还是 Nginx stream
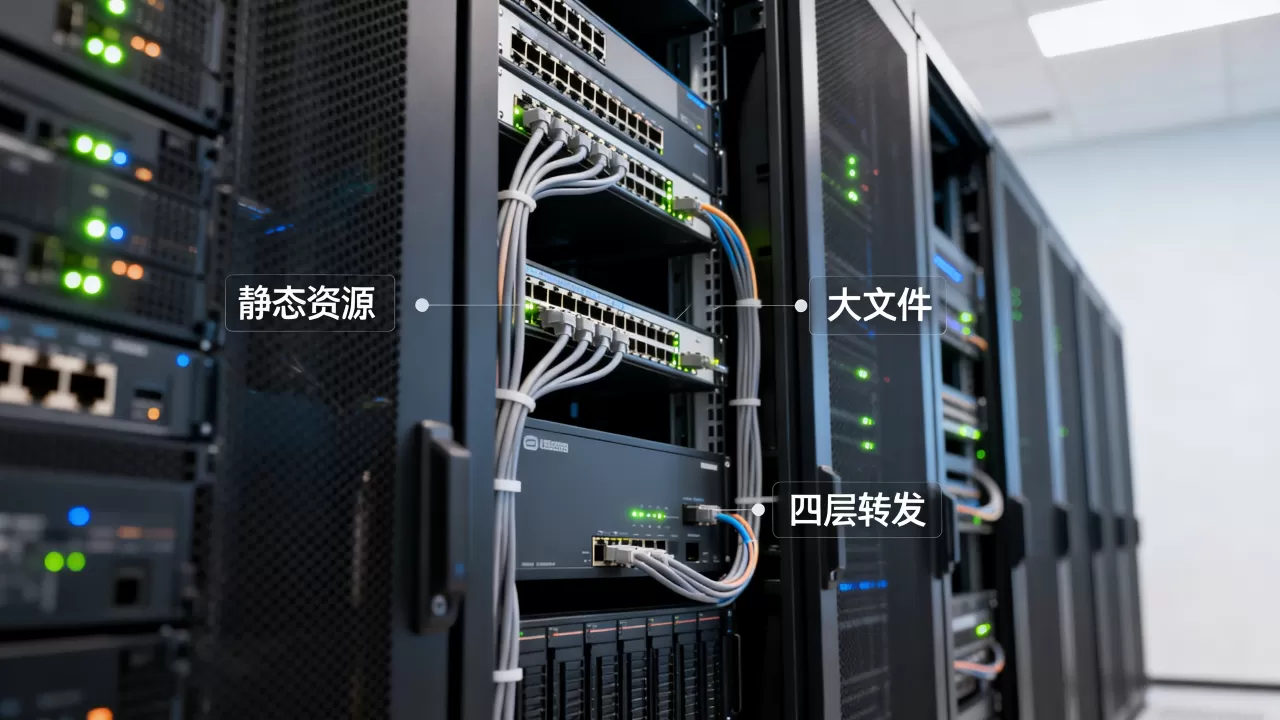
如果问题换成“大文件下载用什么负载均衡”,答案很明确:流量规模越小越随意,流量一旦上来,LVS这类四层方案是更稳妥的选择。
Nginx也提供stream模块,可以理解为Nginx变身为四层转发,它的配置简单:
stream {
    upstream backend {
        server 192.0.2.10:80;
    }
    server {
        listen 8080;
        proxy_pass backend;
    }
}
但Nginx stream本身仍然是用户态进程,处理大文件时依然有用户态和内核态切换,吞吐低于纯内核态的IPVS,对于中小型网站,Nginx stream足够;对于下载站、CDN源站,多数情况会选LVS甚至DPDK。
视频网站常见的做法是:视频流通过四层转发到边缘存储节点,用户边下边看;安装包下载站则用四层转发把大文件的请求分散到多台文件服务器,避免单台磁盘吞吐成为瓶颈。
HTTPS、静态资源与四层转发:如何取舍
HTTPS流量能不能走四层转发?可以,四层转发直接透传TCP,不解密,证书在后端服务器上终止,这要求后端服务器能够承担TLS解密压力。
如果你的静态资源域名比较复杂,需要在同一个端口上根据URL前缀转发到不同的文件目录,四层转发就做不了,因为它不拆包,这时可以这样设计:边缘走四层,到后端Nginx再按路径分目录,而不是用七层代理做全局分发,这样既保住性能,又有灵活性。
部署四层转发到底难不难:实操参考
很多同学担心四层转发配置门槛高,LVS DR模式配置并不复杂,关键点就是VIP和ARP抑制,下面给一个更细的步骤:
- 前置条件:两台LVS节点(主备),两台以上真实服务器,共享同一内网。
- 在主LVS节点上:配置VIP为
eth0:1 10.0.0.10 netmask 255.255.255.255。 - 在真实服务器上:将VIP绑定到
lo:0,并禁止ARP响应。
也可以直接使用keepalived配置,它会自动创建VIP和转发规则,并处理健康检查,配置文件核心片段:
virtual_server 10.0.0.10 80 {
    delay_loop 6
    lb_algo wrr
    lb_kind DR
    protocol TCP
    real_server 10.0.0.11 80 {
        weight 1
        HTTP_GET {
            url { path /health }
        }
    }
}
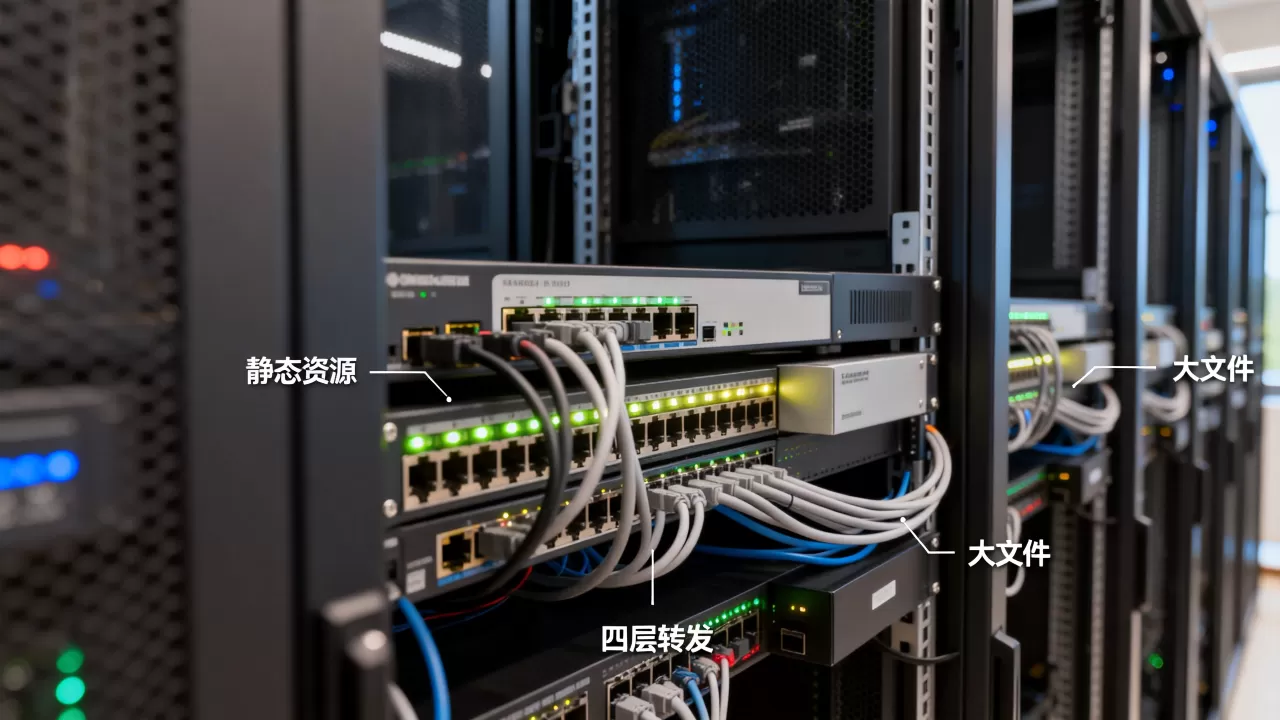
配置完成后,用 ipvsadm -L -n 查看规则,再用一台客户端请求,ipvsadm -L --stats 能看到连接分布,整个过程大概半小时能跑通,业内专家指出,一旦确认静态资源走的是四层转发,排查问题就从“看应用日志”变成了“看连接表”,复杂度实际上是下降的。
什么情况下仍然要保留七层代理
不是所有静态资源都必须走四层,以下场景可以继续用七层:
- 静态资源量不大,并发低,不需要极致性能。
- 需要URL重写、防盗链、缓存控制、动态压缩等应用层功能。
- 需要基于Cookie或Token做访问控制,必须看到内容才能决策。
进行动静分离仍然是好习惯:把 static 子目录或独立域名扔给四层,把接口留在七层,两边都能用最合适的方式运行。
Q&A:静态资源走四层转发的常见问题
四层转发能识别文件类型吗?
不能,四层转发只看到IP和端口,不会拆开数据包判断扩展名和Content-Type,要实现文件类型识别,需要在DNS或接入层将静态域名单独解析到四层转发,或者在后端七层服务里根据URL路径处理,也就是说,文件类型的区分靠的是域名和路径,不是四层转发本身。
大文件下载用LVS好还是Nginx好?
看规模,小型站点或内网环境下,Nginx的stream模块配置简单、容易调试,够用,在线用户较多或文件超过几GB,LVS类四层转发对CPU、内存的占用明显更小,且支持后端直接回包,不容易成为瓶颈,行业实践里,下载站和CDN源站大多用LVS或DPDK,而不是Nginx七层。
静态资源走四层转发,需要改动业务代码吗?
基本不需要,域名解析调整到四层VIP,后端服务器保持原有监听,如果后端有获取客户端IP的需求,需要配置 proxy_protocol 或让LVS使用TUN模式保留原始地址,否则,客户端IP会被“吞掉”,这算是一个隐藏坑。
静态资源与大文件走四层转发,不是玄学,而是把数据路径变短、把内存拷贝减少、把内容语义检查去掉的工程取舍,如果你的业务已经有明显的动静分离,大胆把文件类流量切到四层,性能提升会立刻反馈在监控曲线上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/635072.html