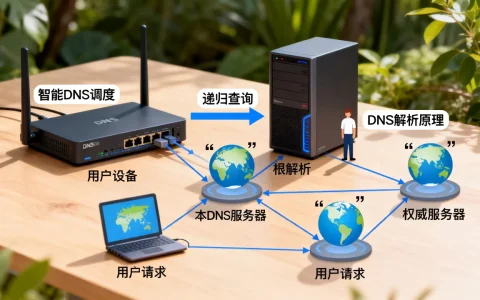
企业做智能DNS调度,核心要盯紧探测准确性、策略灵活性和容灾切换速度这三组参数,它们直接决定了业务可用性和用户体验。
很多团队把智能DNS调度想简单了,以为配个多线解析就算完事,实际落地时会发现,参数没调好,钱花了,效果反而更差,下面把关键参数掰开揉碎,用实际场景讲清楚。
智能DNS调度的“神经末梢”:探测参数决定判断力
DNS调度的第一步是判断用户从哪里来、目标服务器是否健康,这个环节的参数设置,决定了整个调度系统的“视力”好坏。
探测协议和端口匹配:别用错尺子量布
大多数智能DNS系统内置了HTTP、HTTPS、Ping、TCP等多种探测方式,选哪个不是看哪个快,而是看贴合你的业务类型。
- 纯静态资源站点,TCP或Ping探测基本够用
- Web应用必须用HTTP或HTTPS探测,否则你探测结果是“通”,实际业务可能已经500错误了
- 涉及文件上传下载业务的,最好探测特定URL路径,而非域名根路径
行业内不少资深运维踩过这个坑,某电商平台曾只做TCP 80端口探测,结果后端应用进程假死,端口仍能握手,用户端一片报错,调度系统纹丝不动。必须模拟真实用户访问路径,这是第一个铁律。
探测频率与超时阈值:快与稳的平衡木
探测频率过高,会对源站产生额外压力,尤其是不擅长抗高频健康检查的小型源站或高防IP;频率过低,故障发现会滞后。
- 一般场景建议探测间隔5-10秒一次,业内的互联网大厂多采用这一区间
- 超时阈值通常设为2-3秒,超过即认为单次探测失败
- 连续失败2-3次才判定节点宕机,避免因偶发抖动触发误切换
探测节点分布:别让监测员坐在同一间屋里
一个高频被忽略的参数是探测节点来源,如果所有探测请求来自同一运营商或同一地域,得出的结论会有严重倾向性。
某个智能DNS厂商的全国探测节点多为BGP线路机房,它们访问你在电信机房的源站效果很好,但南方某省电信的用户实际访问体验却很糟糕,调度系统判断“全绿”,用户端却是“红海”,尽量选择探测节点覆盖各运营商、各省市的DNS服务商,或自建分布式探测点,使用命令dig +trace配合指定探测节点,可以验证不同路径的解析结果是否合理。
智能DNS调度怎么做?策略参数才是核心的王牌
探测数据都拿回来了,按照什么规则调度,这是“大脑”的决策区域。策略参数决定了调度的倾向性、合规性及成本模型。
线路匹配与兜底逻辑:精准命中从下沉到兜底
智能DNS最常见的策略是“按运营商、按地域”解析,但这里有两个关键参数需要格外关注:默认线路和兜底生效时间。
- 默认线路:当没有匹配到任何自定义线路时,返回哪里的IP?不配置的话,默认返回默认线路地址,常常就是主IP,这就是很多人问“为什么我的智能DNS没生效”的常见原因非重点线路的访问被丢给了默认地址
- 兜底TTL:对于未命中的用户,返回的解析记录TTL应设得比精细匹配的更低,比如60秒,以便快速调整
权重比与灰度切换:让流量有序流动
当你有多个可用节点资源时,权重参数是个好工具,比如某个源站带宽成本更低、容量更大,可以设置7:3的权重,让大部分流量走主节点,少部分走备节点。
但要注意,DNS权重切换依赖TTL过期,并非即时生效。调整权重前,务必先缩短TTL至120秒以下,观察稳定后再调整,否则老节点压力没卸掉,新节点先被冲垮了,行业里有些团队喜欢用“先调10%流量试水”,这很适合用于验证新机房线路质量。
故障转移里的“冷静期”与回切参数
策略里还有一组易被忽略的参数:故障转移冷静期和回切延迟。
- 冷静期:节点从故障状态恢复后,不要立刻重新接管流量,建议观察15-30分钟,确认稳定后再兜底回流量
- 回切延迟:如果主节点恢复后立刻切回,会造成大量连接中断,设置延迟10-20分钟回切,能显著降低业务抖动
这里用到一个行业共识:DNS容灾相比LVS、SLB等四层手段,切换速度天然较慢,别强求秒级,合理设计才是关键。
解析收敛与缓存:用户端的“记忆”参数
这部分在事前常被忽略,其实这里是DNS调度延迟测试工具使用频率最高的测试项,DDI(DNS、DHCP、IPAM)设备业内有一个共识:解析收敛时间是智能DNS体验的核心。
TTL设置哲学:动态权衡的无字天书
TTL(DNS记录存活时间)可能是智能DNS里最被低估的参数。
- 期望快速容灾?TTL要小,比如30-60秒,但代价是各递归DNS频繁回源,增加源站QPS消耗
- 期望稳定高效?TTL要大,比如600秒,但故障时切换生效变慢
真实的业务场景是:核心入口域名用60-120秒的TTL,结合健康检查自动切换;活动页、临时跳转用更短的TTL;长期稳定的静态资源业务则放开到300秒以上,用dig命令观察解析返回的TTL值,可以直观看到缓存情况。
302重定向与CNAME链的长度控制
再提一个业务层面的调度参数CNAME链长,有些企业做多级调度会陷入CNAME嵌套过深的问题,每多一层CNAME,解析时间可能增加10-30毫秒,移动网络环境下感知更明显,建议核心业务全链路CNAME跳转不超过2层,超过的话直接用A记录或设置HTTP 302跳转来实现。
不可忽视的隐性参数:成本、安全与合规
前面聊的都是能调通的参数,下面这几个,属于“一旦出事就是大事”类型的隐性参数。
按量计费下的QPS阀值与突发流量保护
多数商业化智能DNS按解析量或探测节点数计费,如果源站遇到恶意解析放大攻击或流量突发,解析QPS会瞬间飙高。
- 提前在服务商控制台设置QPS阈值告警,例如平时峰值的80%
- 建议开启解析限流或DDoS高防联动,避免攻击流量穿透DNS层直接挤压正常查询
关于智能DNS价格,不同厂商差异较大,基础按量付费一般在几分钱/万次查询量级;包含健康检查、全球多节点探测、API管理等能力的商业套餐,企业年费多数在几千到数万元不等,选型时重点看“探测节点覆盖质量”而非单纯低价,这些服务通常不值得在“极低价”上赌稳定性。
日志留存与合规备份:审计链完整
现在等保2.0和《网络安全法》都要求DNS日志留存不少于6个月,这个参数虽然不是直接作用于调度逻辑,但它是日志审计的关键一环,确保你的智能DNS系统支持全量日志导出,并且具备实时查询明细能力,国内运营环境下,若服务商无法提供日志追溯功能,需要列入一票否决项。
企业DNS选型对比:自建还是用云服务
很多团队纠结于这个问题,这里的成本对比逻辑也存在一些典型的误区:
| 维度 | 自建智能DNS | 云服务商智能DNS |
|---|---|---|
| 初期投入 | 服务器、带宽、系统研发 | 无前置硬件成本 |
| 技术门槛 | 需懂BIND/开源方案和运维 | 控制台可视化操作 |
| 探测节点覆盖 | 建全国探测点成本极高 | 厂商自有骨干网资源 |
| 容灾能力 | 依赖自身机房稳定性 | 多可用区冗余 |
| 出问题责任边界 | 自行承担全部风险 | 有SLA保障 |
行业共识:不具备基础网络运维团队的企业,建议直接采购大厂DNS服务;拥有较多机房资源和网络技术的团队,可考虑对核心业务使用自建系统+专业服务商做“双跑”备份。
来源本身据中国信通院相关报告,越来越多的中大型企业倾向于混合DNS架构,在解析链路与调度策略上解耦。
调度效果验证的实操步骤
参数配置完成,不验证等于白做,给出第一组可直接执行的验证思路:
- 使用
dig @指定DNS服务器 domain.com,模拟不同运营商递归节点的解析结果,确认返回IP是否符合预期 - 抓包观察关键域名解析响应时间,若响应超过80ms,需要排查链路或递归节点调度策略
- 建立监控看板,抓取调度生效后,各源站带宽、连接数变化趋势,对比调度前后数据差异
结合第二组验证方式:使用在线拨测工具(如站长工具多地Ping、简米云拨测),定时获取全国各节点的HTTP状态码和响应耗时,观察自动切换触发后,业务是否在预期时限内完成故障转移。
第三组内部演练:每个月强制在低峰期执行一次模拟故障切换,验证从“探测失败”到“DNS记录更新”再到“用户缓存过期收敛”的全链路时长,业内普遍认为,真正发生故障时,切换时间往往是演练结果的1.5倍以上,演练价值即在于此。
Q&A:智能DNS调度的常见疑问解答
Q:智能DNS调度和负载均衡是一回事吗?
不是,负载均衡通常在IP层或应用层分发流量,作用于单次连接;智能DNS调度在DNS解析层面将用户引导至不同机房,两者能配合使用,但职责边界完全不同,灵活场景中,通常将智能DNS作为“第一跳”,入口网关或云负载均衡作为“第二跳”,配合实现全局与局部的双重高可用,业界主流架构中,这种“DNS+LVS/Nginx”组合模式应用最广。
Q:源站都在国内,有必要使用全球智能DNS调度吗?
这取决于你的用户分布,即使源站全在国内,如果你有海外用户访问的需求,全球调度网络仍然有价值它能把海外用户调度至国际专线接入点或边缘加速节点,改善跨境链路质量,反之,用户全部面向国内单一省份,那么只需要重视本地运营商线路覆盖即可,最终关键参数依然是“用户在哪里”。
Q:智能DNS的“智能”到底体现在哪里?
主要体现为三个方面:一是自动感知源站健康状态并调整解析结果,省去人工改DNS的等待;二是能根据用户发起请求的来源IP,分析网民所属运营商与省份,从而精准计算出就近或最优线路地址并返回;三是支持按权重、按比率、按时间段做策略调度,实现资源的可控分配,整套系统围绕“探测-策略-响应-收敛”四个环节运转,联动生效才称得上智能,如果只是按固定IP库硬匹配,那只是最基础的“多线解析”功能,距“智能”尚有不小距离。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640663.html