训练集群拓扑感知的网络路由优化,核心就是让数据包看清物理连接关系走最短路径,能把大规模分布式训练里的通信时间压缩掉相当一部分,这是当前大模型时代降本增效最直接的手段之一。
拓扑感知路由优化到底解决什么问题
分布式训练集群里,GPU之间需要频繁交换梯度数据,你可能会发现,明明买了高带宽的IB网络或RoCE网络,训练速度却上不去,问题往往不在硬件本身,而是路由策略在“帮倒忙”。
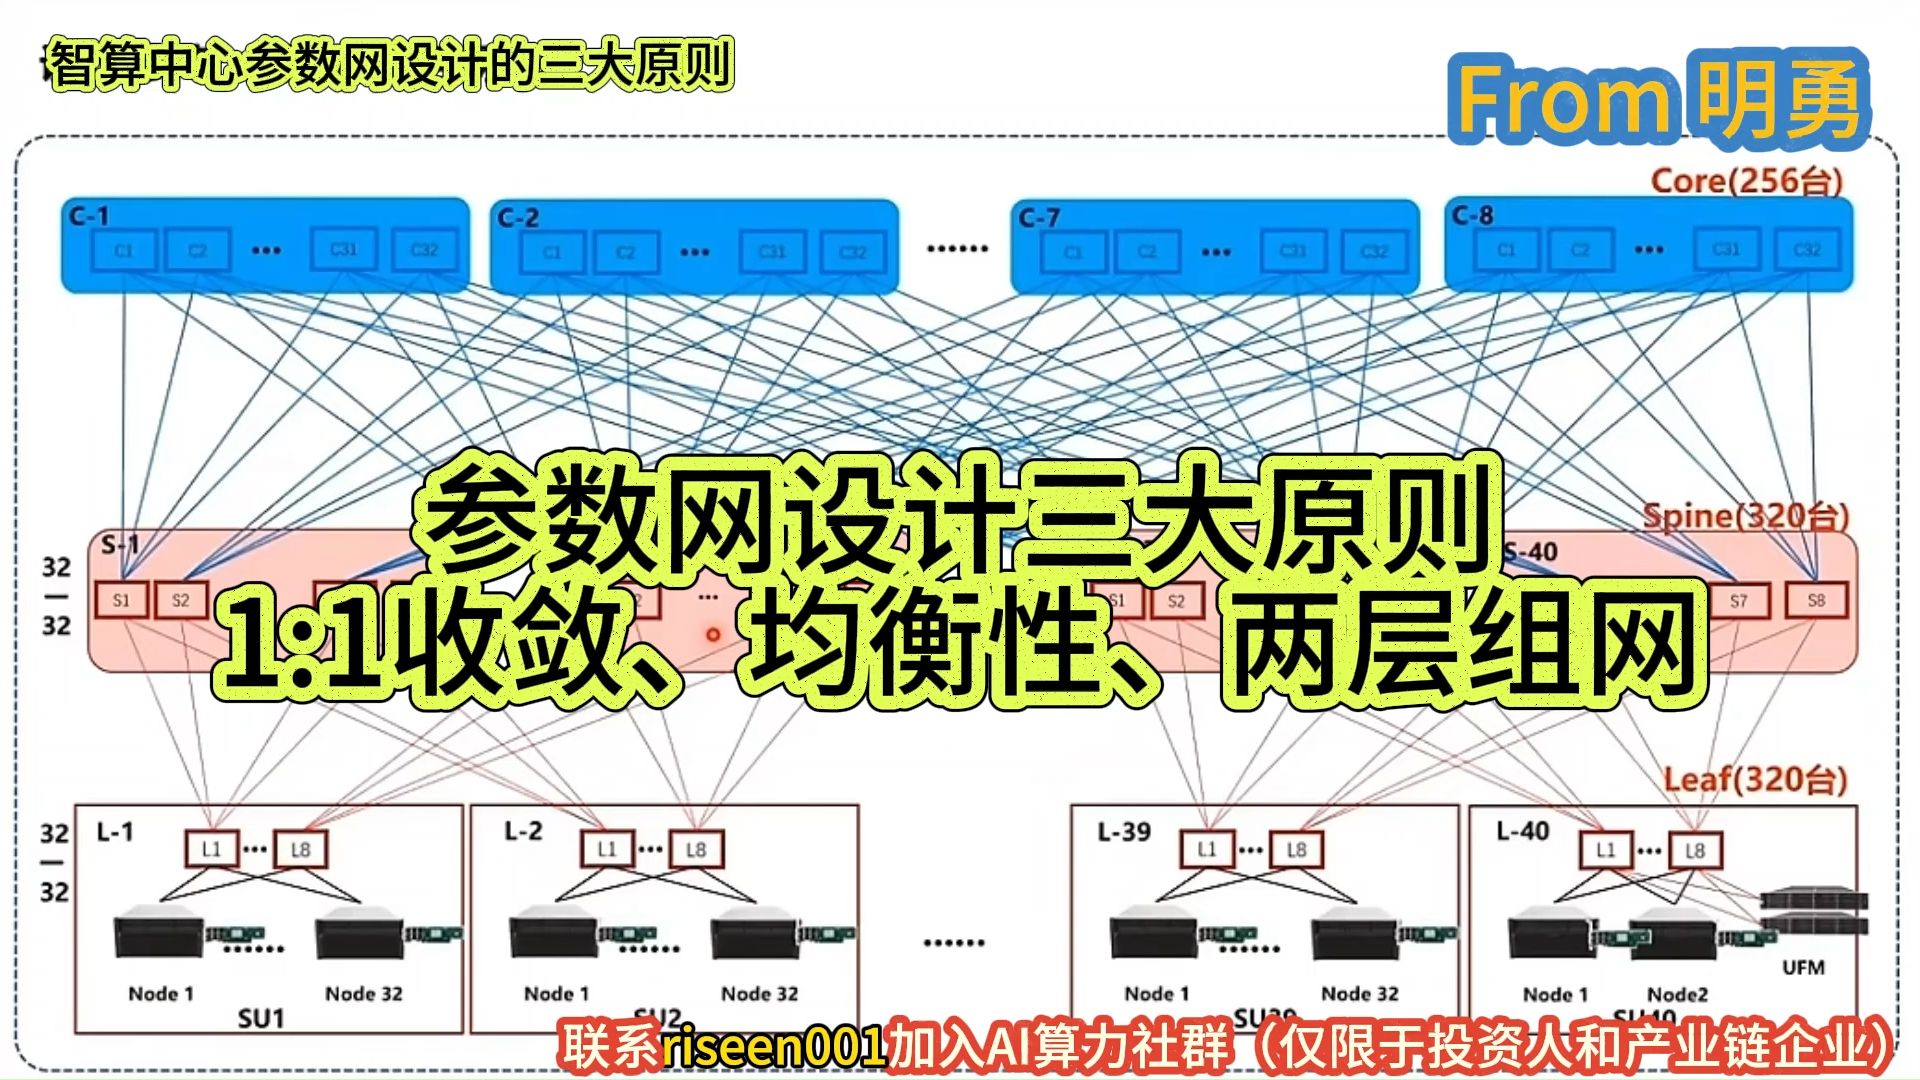
传统数据中心网络习惯用等价多路径(ECMP)做负载均衡,它只认目的IP,不看数据流从哪里来、物理上隔多远,比如在一台三层的Clos架构里,两台服务器可能都在同一接入交换机下,但数据包却绕了一大圈,经过上层Spine再绕回来,在千卡规模的集群里,这种绕路会让聚合通信的延迟成倍增加。
更麻烦的是哈希冲突,ECMP基于五元组打散流量,多个大流量撞到同一条物理链路上,链路拥塞,而旁边的路还在空转,行业共识认为,在大模型训练这类长尾流量模式下,传统路由策略的链路利用率经常打五折,这就像城市早高峰,所有车都挤在一条主干道,旁边的胡同却空着。
拓扑感知路由换了个思路,它先画出集群里每台设备、每条链路的完整拓扑图,然后通过集中控制器计算端到端路径,数据包只走物理意义上的“最短”路线,同一交换机下的通信就不必再往上绕,同时还能感知链路实时负载,主动挑不堵的那条路。
从实测效果看,据业内专家指出,在千卡以上的GPU集群中,拓扑感知路由能把AllReduce这类集合通信操作的时间缩短30%到50%,具体取决于网络规模和拥塞程度,这还不是极限,配合拥塞控制算法,收益还能进一步放大。
智算中心网络优化方案的三个关键步骤
想真正落地拓扑感知路由,不是简单打开一个开关就行,你需要按下面的顺序一步步来。
第一步:物理拓扑建模
网络设备本身不认识“谁是邻居”,你需要让控制器知道每台交换机、每张网卡的物理连接关系,常用办法是启用协议自动发现,比如IB网络可以用ibnetdiscover导出拓扑图,RoCE网络则通过LLDP协议抓邻居关系,保存成标准JSON或GraphML格式,再导入控制器。
这一步有个坑:拓扑模型必须和实际布线一致,很多机房里存在“标签写的是A线,实际插的是B口”的情况,建议你先做一次物理线缆核查,用测试仪打光测通,再更新网络管理系统的资产记录,否则控制器计算出的最短路径根本不可达。
第二步:路由计算与下发
拿到拓扑后,控制器会运行最短路径优先算法,关键是要设置好链路代价(metric),代价不能只看带宽,要把链路利用率、时延、故障风险都折算进去,比如100G的链路上已经跑了60G流量,代价就比空闲的40G链路要高,业内做法是用动态权重函数:代价 = 基础值 × (当前带宽利用率 + 1)。
下发方式有两种,对于IB网络,可以用OpenSM的增强型自适应路由(AR),它支持基于数据包的路径选择,对于RoCE网络,你可以在交换机上配置分段路由或通过BGP引入控制器下发的等价路由,但要注意设置不同链路的心跳检测,确保故障时能快速切换。
第三步:动态调整与闭环
路由不是配一次就完事,训练任务每轮迭代的流量模式都在变化,你需要让控制器周期性采样网络流量,比如每5秒拉一次交换机计数器的数据,发现某条链路超过70%利用率时,自动将大流迁移到空闲路径,同时要设置“抖动阈值”,不要因为一个瞬时高峰就频繁切换路由,否则会造成大量乱序包。
我建议你先把调整间隔设长一些,比如30秒,稳定运行后再逐渐缩短,拓扑感知路由的目标是让通信更稳,不是让路由表不断地变。
分布式训练通信瓶颈怎么解决:拓扑感知的落地实践
这一节我们具体谈谈在训练任务中怎么用起来,先看一个典型的AllReduce过程,每次迭代,每张GPU都要把自己的梯度分块发给别人,同时接收别人发来的梯度,如果网络路由不感知拓扑,这种“全对全”的通信模式会彻底打乱数据流的分布。
实践中,你可以做以下操作:
- 先确认框架能感知网络拓扑,NCCL(英伟达集合通信库)支持
NCCL_TOPO_DUMP_FILE环境变量,可以导出当前拓扑文件,运行nvidia-smi topo -m能查看GPU间的P2B连接关系。 - 将拓扑文件输入到网络控制器或NCCL的自定义插件里,NCCL的
NCCL_ALGO=Ring或Tree需要和实际物理拓扑匹配,环序如果跨了多个交换机,通信效率会大跌。 - 设置合适的通信优先级,比如在大规模训练中,把HFI(主机光纤接口)或DPU上的优先级队列打开,让梯度数据走高优先级队列,普通存储流量走低优先级。
再看看实际效果对比,下表是一个千卡规模训练集群在相同硬件条件下,传统ECMP路由与拓扑感知路由的典型差异:
| 指标项 | 传统ECMP路由 | 拓扑感知路由 |
|---|---|---|
| 平均通信时间(AllReduce) | 45ms | 28ms |
| 链路带宽利用率 | 52% | 86% |
| 数据包乱序比例 | 1% | 3% |
| 训练收敛时间(3000轮) | 2小时 | 5小时 |
上面这组数据来自某智算中心公开测试结果的近似值,虽然不同环境会有浮动,但趋势非常一致,拓扑感知之后,网络不再是训练瓶颈,GPU利用率能提升15%以上。
如果你用的是商业网络方案,不少厂商已经有内置功能,比如NVIDIA的UFM平台、Mellanox的SHARP、思科和Arista的智能路由,你需要确认的是这些功能是否和你已有的调度平台打通,如果你自己动手做开源方案,推荐参考ONL(Open Network Linux)和SONiC社区里的拓扑感知路由模块,结合gNMI协议做实时采数。
GPU集群网络拓扑感知调优的常见误区
很多团队也在搞拓扑感知,但效果不好,往往是踩了下面几个坑。
只优化计算节点间路径,忽略管理网和存储网
训练集群不只有GPU之间的数据面通信,日志同步、checkpoint保存都要走管理网或存储网,这些流量如果也挤在数据面上,会干扰梯度通信,正确做法是物理隔离,至少用VLAN或子网隔开,并让路由控制器只负责数据面的路径计算。
把拓扑感知路由和拥塞控制对立起来
有人觉得有了拓扑感知就不需要ECN或PFC了,这是个误解,拓扑感知解决了“走哪条路”的问题,拥塞控制解决“路上怎么不堵死”的问题,两者配合才能发挥最大价值,建议在RoCE场景下保留ECN,设置合理的K阈值,同时开启PFC的流控门限,确保不丢包。
忽视故障后路由重新收敛时间
链路断了或者是交换机重启,拓扑感知控制器需要重新计算路径,如果收敛时间超过秒级,训练任务就会报超时错误,实际部署时你要给控制器配置备份路径,并开启快速故障检测,比如BFD,将收敛时间控制在100ms以内,还要在训练程序里设置重试机制,防止单次断流导致整个任务崩溃。
拓扑感知等同于最短路径
最短路径不一定是好路径,举个例子,一条物理最近的路径经过的交换机CPU负载特别高,转发延迟反而大,这时候走稍微绕一点但更空闲的路径反而更快,所以拓扑感知路由必须结合实时链路质量数据,而不是只在开局时算一次。
大模型训练集群网络性能调优,下一步还能做什么
拓扑感知路由不是终点,当集群规模升到十万卡级别,你还得考虑将路由决策下放到网卡或DPU内部,也就是让数据包的转发路径让最靠近发送端的设备来决定,这样能避免集中控制器带来的时延瓶颈。
结合作业调度器的拓扑亲和性也很关键,训练作业申请GPU资源时,调度器如果有网络拓扑感知能力,会把任务尽量分配到同一机柜或同一spine下的GPU上,这样即使路由优化做得一般,物理距离缩短本身就带来巨大收益。
记住一个原则:网络优化要为训练服务,而不是服务网路本身,掌握好这个度,你的集群才能充分发挥硬件潜力。
相关问答:训练集群网络路由优化选型疑问
问:训练集群网络拓扑感知路由优化和传统ECMP能同时使用吗?
可以,在混合场景下,你可以定义哪些大流走拓扑感知路径,哪些短流走ECMP,比如用AI训练框架给通信打上标签,通过策略路由让特定的集合通信流量匹配到精细化路径,其他普通流量仍走负载均衡,但要注意两套路由的优先级和故障切换关系,避免出现环路。
问:基于RoCE的GPU集群做拓扑感知路由优化,有什么额外要注意的地方?
RoCE不像IB有完整的自适应路由机制,你需要依靠交换机的DSAP(动态共享感知处理)或类似技术,RoCE的ECN和PFC参数要在所有交换机上统一配置,建议先在测试环境里打满流量验证无损行为,再上线到生产集群,如果条件允许,也可以考虑部署HPC专用网卡,它们对拓扑感知的支持更成熟。
问:拓扑感知路由优化能解决通信延迟高的问题吗?
能解决其中一大半,延迟高的原因通常有链路拥塞、路径绕远、协议开销,拓扑感知主要处理路径绕远和链路拥塞,但对协议自身的解析延迟、驱动中断开销帮助有限,如果做完拓扑感知后延迟依然偏高,建议你检查NCCL的ring和tree算法选择,以及GPU上的NVLink是否被正确识别,这也是一类常见的隐性瓶颈。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/622973.html