定位异常请求来源的本质是串联一条完整的请求轨迹,从入口网关到下游数据库,每一跳的日志都必须带同一个traceId,然后按时间线把链路片段拼起来,就能锁定异常发生的节点和源头。
做了多年后端排查,我最深的感受是:日志不统一的系统,出问题时就像在黑暗里找一根针,还是掉在毛毯上的那种,今天这篇就聊聊我自己的“全链路日志排查步骤”实战积累,把那些能直接落地的操作路径写出来。

全链路日志排查的地基:traceId贯穿始终
没有traceId的日志排查,各打各的,根本没有“链路”可言,traceId本质就是一串全局唯一标识,在请求进入系统的第一个节点生成,然后通过HTTP Header(常见的是X-Request-Id)一路向后传递,每个服务的日志框架把它塞进MDC里,这样即使订单服务、支付服务、网关日志各自存在不同文件里,也能用同一个traceId捞出来。
埋点规范怎么做才不乱
规范不落地,等于没有,我的建议是三步走。
- 入口统一生成:API网关或最前端的Web层,在接收请求时判断Header里有没有traceId,没有就生成一个UUID,有就直接透传
- 日志格式统一:推荐用
[%X{traceId}]放到Pattern最前面,配合spanId记录层级关系,方便看到调用深度和耗时分布 - 跨线程传递不丢:用了异步线程池或者MQ的场景,必须手动把traceId传给新线程,这是排查中“日志突然断掉”最常见的原因
行业共识认为,traceId的透传规范在微服务架构中比日志框架本身更重要,因为所有下游能否关联上,全靠它。
时间同步和时区陷阱
排查过程中,日志时间戳错乱是大坑,服务器时钟没对齐,A服务记录的时间比B服务晚两秒,整个调用链就对不上,加个NTP自动同步,日志统一使用UTC或服务器本地时间并注明时区,这是最基础的门槛。
全链路日志排查步骤:从异常时间窗到根因定位
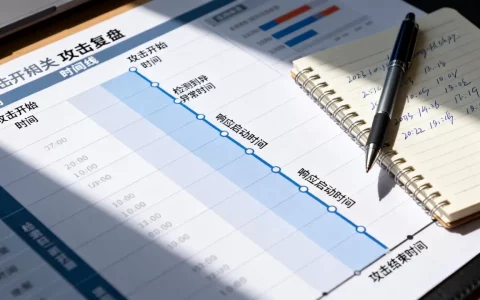
刚接手一个线上问题,别急着翻日志,先明确异常发生的精确时间范围(精确到秒),再把这段时间内涉及的服务、实例、接口路径和错误码列出来,这个时间窗就是你检索日志的边界条件,整套排查步骤我总结为六步,基本上覆盖80%以上的场景。
第一步:网关和入口层初筛
先查Nginx或Spring Cloud Gateway的access log,看异常是否集中在某个IP、某个User-Agent或某个URL模式,如果是特定IP频繁触发,直接封禁并拉黑,如果某个接口的错误率突增,那就圈定了业务范围,下一步就要往下游走了。
第二步:按traceId捞全链路日志
把网关日志里的traceId拿到,到日志平台搜索框里一贴,所有服务节点按时间轴展示,这里我会重点关注几个信息:
- 哪个节点耗时最长(CPU密集型?还是GC停顿?)
- 哪个节点抛了异常堆栈(SQL死锁?Redis超时?外部API返回5xx?)
- 哪两个节点之间存在时间断层(说明发生了网络重试或线程阻塞)
第三步:日志关联和上下文拼图
这一步很关键,单看一段日志不够,要结合业务日志中的入参出参、数据库慢查询日志、中间件监控指标做交叉验证,举个例子,有一次定位超时问题,发现业务日志耗时只有200ms,但数据库日志显示锁等待了3秒,最后定位是批量更新时gap锁互等,日志之间能对上,根因基本就跑不掉。
下面的表格是我常用的查看维度,可以直接对照排查:
| 数据来源 | 关注指标 | 常见根因 |
|---|---|---|
| Access Log | 状态码、响应时间、UA | CC攻击、慢查询 |
| 业务日志 | 入参、出参、业务异常 | 空指针、状态机冲突 |
| DB慢日志 | sql耗时、扫描行数 | 索引失效、锁竞争 |
| GC日志 | Full GC频率、暂停时间 | 内存泄漏、堆偏小 |
第四步:统计异常规律,逆向锁定来源
如果每次异常都集中在特定时间段(比如整点),大概率是定时任务或缓存的批量失效引起,如果集中在特定地域的IP段,就要排查CDN节点或异地多活配置,日志中加上地域、运营商、客户端版本这些维度,对定位来源有直接帮助。
第五步:基于来源特征做拦截验证
锁定IP段或客户端特征后,先在网关层做限流或模拟拦截,再观察异常量是否下降,这一步既验证了你的判断,也为后续加固争取了时间。
第六步:复盘出整改方案
根因找到不是终点,需要把traceId透传的完整性、日志开关的覆盖度、关键节点的告警阈值做一遍梳理,这一步属于长期建设,但每次实战排查后都有新东西可以补进去。
日志分析工具对比:ELK、Loki和SkyWalking怎么选
工欲善其事,必先利其器,日志排查速度的快慢,和工具链的完善程度强相关,不同的工具适合不同的场景。
ELK技术栈的优势与局限
Elasticsearch + Logstash + Kibana是我用得最顺手的方案,检索语法强大,支持全文索引,配合Kibana的Discover面板,可以快速按时间范围+字段筛选,但有一个痛点:日志量大了之后存储成本高,ES集群本身也需要额外运维,一个小团队如果没专职运维,ELK集群反而会变成新的故障点。
Grafana Loki更适合Kubernetes环境
Loki的设计理念是用标签索引代替全文内容索引,资源消耗低很多,和Prometheus配合得也很好,如果系统已经上了K8s且日志量不算特别大,Loki完全够用,它的日志查询语言LogQL上手有一定门槛,但熟练后非常好用。
下面是几个主流方案的核心差异:
| 方案 | 存储成本 | 查询体验 | 运维难度 | 适用规模 |
|---|---|---|---|---|
| ELK | 高 | 强(全文检索) | 中高 | 中大规模 |
| Loki | 低 | 中等(标签索引) | 低 | 中小规模 |
| SkyWalking | 中 | 强(链路可视化) | 中 | 微服务集中场景 |
| 云厂商产品 | 中 | 强(开箱即用) | 无 | 已有云上业务 |
链路追踪系统的核心价值
SkyWalking这类APM(应用性能管理)工具,侧重的是调用链拓扑展示和耗时分析,和服务日志互补,一个看“哪条路走得慢”,一个看“为什么慢”,大多数情况下,我会同时保留日志平台和链路追踪系统,配合使用。
日志查询慢和生产指标异常应该关注什么
日志平台用久了,查询慢是个大问题,索引太多、分片数设置不合理、查询范度过宽都会拖垮检索性能,这时候,控制时间范围是首选从七天缩短到两小时,速度直接翻倍。
生产环境排障,我通常按这个优先级来判断:
- 服务整体的错误率走势,看是持续波动还是突增尖峰
- 核心接口的P99耗时和可用率
- 上下游依赖(DB、Redis)的延迟和错误
- 系统资源的非正常波动(CPU、内存、磁盘IO)
- 网络层的丢包和重传情况
这些维度有异常就说明系统有隐患,及时介入能避免后续更大的故障。
总结一下我的个人痛点与几个Q&A
日志质量直接决定了你的排障效率,现在每次接手新项目,我第一件事就是看它的日志规范统一了没有、traceId链路通不通、核心链路有没有日志,这几件事做好,后续事故排查的“至暗时刻”会少很多。
Q:日志重复满天飞,一个请求打了几十条,怎么快速找到关键信息?
A:日志级别规范要明确,对外部依赖调用的入参出参打DEBUG,业务判断分支打INFO,异常分支用WARN或ERROR,生产环境日志级别设为INFO,收集时每个请求限制最多输出N条,关键节点加标记,比如[CORE-FLOW],作为排查时的第一个筛选项。
Q:日志分析工具对比后,小团队优先选哪个方案?
A:从头自建推荐Loki,配合Grafana,机器资源要求低,上手周期短,如果云厂商已有SLS或Cloud Log Service,直接用云产品最省心,按量付费,不存在运维成本。
Q:traceId在异步场景下丢失了怎么办?
A:封装一个线程池装饰器,提交任务前从主线程取出traceId放进去,子线程执行时再写入MDC,如果用Spring的@Async注解,就自定义一个TaskDecorator实现同样效果,处理好这个,异步链路的日志就能串起来了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/635096.html