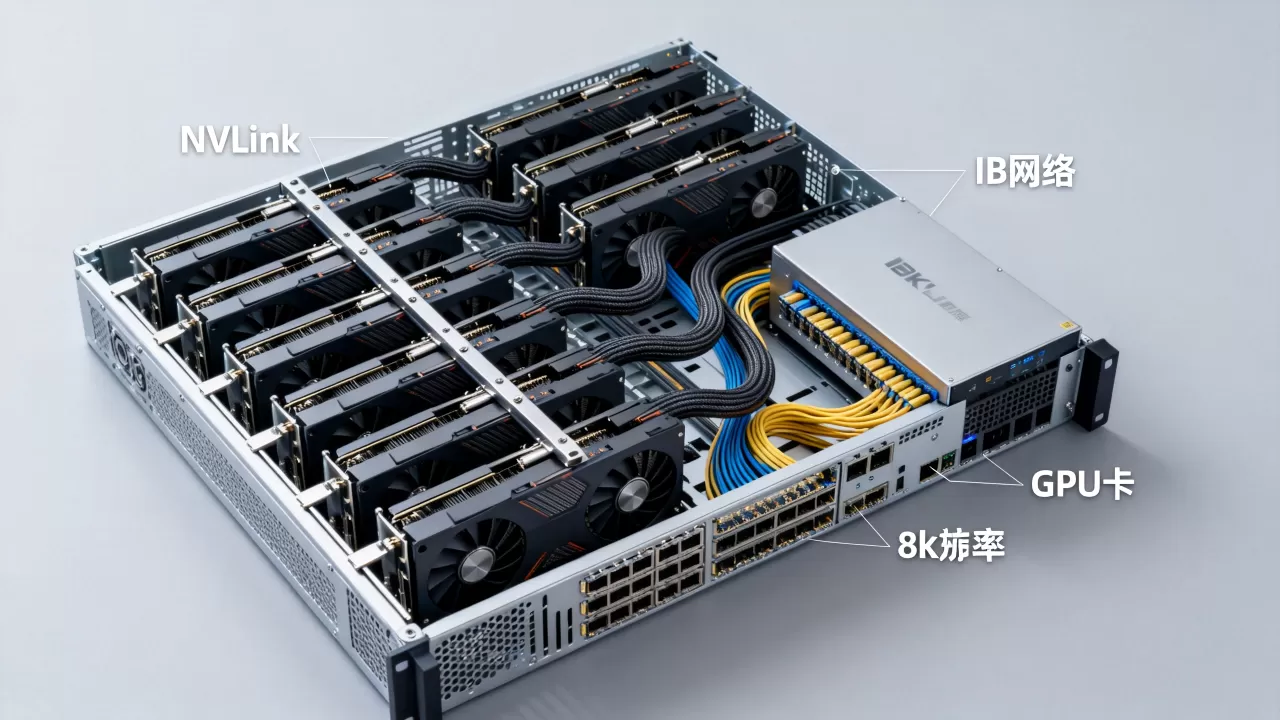
多卡服务器中NVLink负责GPU之间的高速数据直连,IB网络(InfiniBand)负责服务器节点之间的横向扩展通信,两者分工明确,共同搭建起大模型训练和科学计算的高速公路。
这句结论听起来简单,但实际落地时,很多用户在选购和配置多卡服务器时,经常会混淆这两者的职责,导致花了高价买设备,性能却卡在瓶颈上,这篇文章就掰开揉碎,聊聊NVLink和IB网络在多卡服务器里到底怎么分工,以及如何根据你的场景做选择。

NVLink和IB网络到底有什么不同:场景决定分工
要搞清楚分工,先得明确一个概念:NVLink是总线,IB网络是网络,它们的物理形态和数据传输逻辑完全不同,适用场景也因此有明显区分。
NVLink负责的是“内循环”:GPU集群内部的直连通道
NVLink是NVIDIA推出的高速GPU互连技术,它是一条直接焊在显卡或者主板上的物理通道,它的任务很纯粹:让同一个服务器节点内的多张GPU卡像“一个大脑的多个脑叶”一样协同工作。
- 典型场景:8卡A100/H800服务器内,GPU之间的数据交换全部走NVLink。
- 性能特征:NVLink的单通道双向带宽极高(A100时代约600GB/s,H100时代更是达到900GB/s),延迟极低,几乎可以忽略不计。
- 核心价值:它解决的是显存墙问题,当模型参数大到单卡显存放不下时,需要通过张量并行把模型切到多张卡上,每一层计算都需要GPU之间频繁同步数据,这种通信必须走NVLink才能保证计算效率。
IB网络负责的是“外循环”:服务器之间的互联动脉
IB网络(InfiniBand)则是一套完整的网络系统,包括交换机、网卡(HCA卡)和线缆,它解决的是多台服务器之间的数据交换问题。
- 典型场景:32台8卡服务器组成一个计算集群,服务器和服务器之间的数据交换走IB网络。
- 性能特征:当前主流的NVIDIA ConnectX-7网卡支持400Gb/s(约50GB/s)速率,虽然比NVLink低一个数量级,但胜在扩展性无上限。
- 核心价值:它解决的是规模墙问题,当单台8卡服务器装不下模型时,需要用数据并行或流水线并行把训练任务分布到多台机器上,此时梯度同步和参数传输就必须依赖IB网络。
一句话总结各自的核心职责
| 对比维度 | NVLink | IB网络 |
|---|---|---|
| 通信范围 | 单机内8卡(最多18卡) |
跨节点数千卡 |
| 物理形态 | 板载总线/线缆 | 网卡+交换机+线缆 |
| 延迟级别 | 纳秒级(约100ns) | 微秒级(约1μs) |
| 带宽参考 | 900GB/s(H100) | 400Gb/s=50GB/s |
| 主要用途 | 张量并行、显存池化 | 数据并行、分布式存储、多节点训练 |
槽位与拓扑:实际服务器里它们是怎么配合的
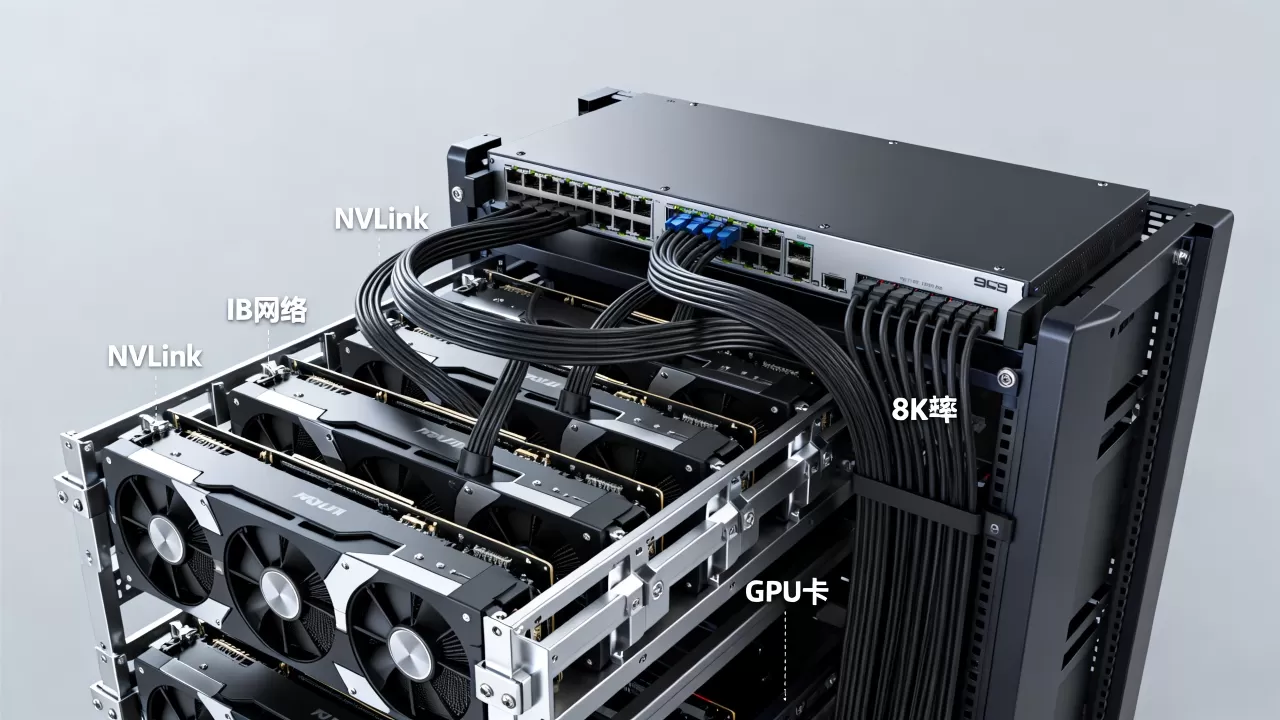
行业共识认为,在多卡服务器的实际硬件布局中,NVLink和IB的配合方式取决于主板的PCIe通道分配和GPU拓扑结构。
典型8卡服务器内部的通信路径
以一台标准的DGX A100或同类国产8卡服务器为例:
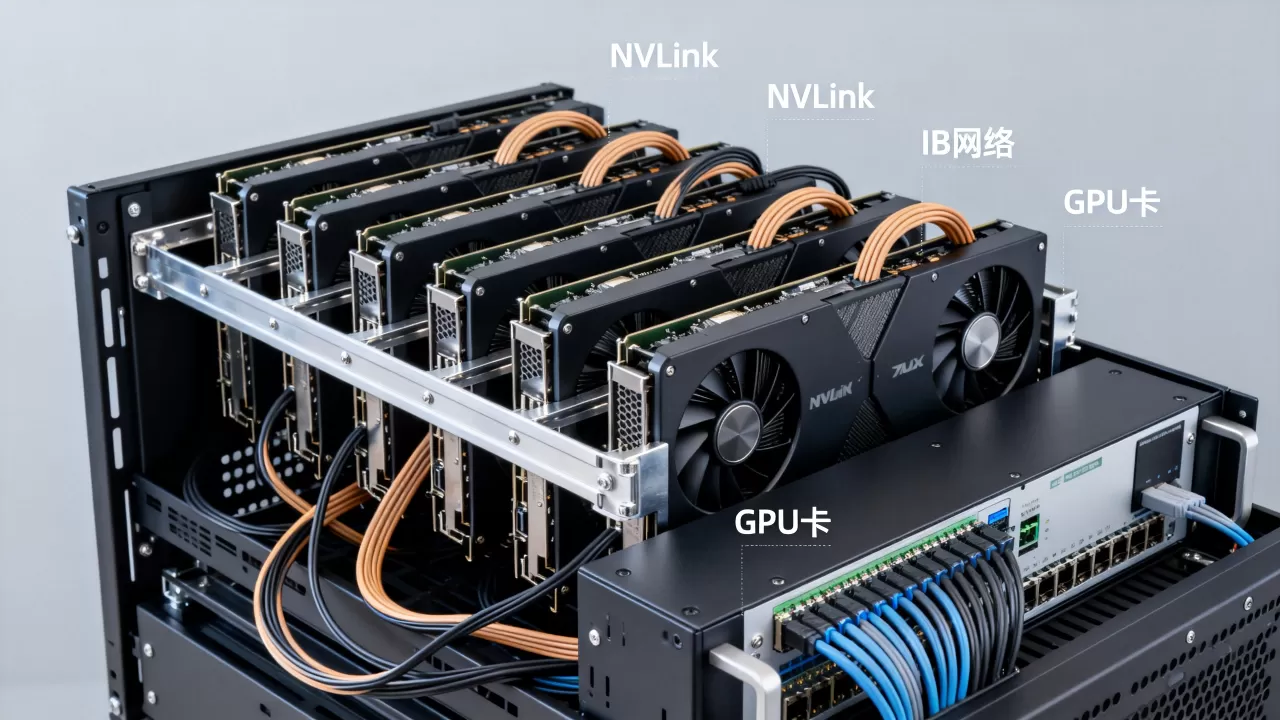
- 8张GPU通过NVLink全互联(NVSwitch),任意两张卡之间的通信带宽一致。
- 外部网络层面,服务器通常配置8张200Gb/s的IB网卡(或4张400Gb/s),每张网卡通过PCIe Switch连接到GPU。
- 当进行千亿参数模型训练时,卡内通信(Transformer层计算)走NVLink,卡间梯度同步(AllReduce)则通过IB网卡发送到交换机,再由交换机转发给其他节点。
实际操作:如何查看当前机器的NVLink和IB状态
如果你已经在使用多卡服务器,可以用以下命令验证两者是否正常工作:
# 查看NVLink连接状态和带宽
nvidia-smi nvlink -s
# 查看IB网卡状态(需要安装mlnx_ofed驱动)
ibstatus
# 检查IB网络连通性
ibping -S -C mlx5_0
如果nvidia-smi nvlink显示所有连接都是Active,说明卡间互联正常,如果ibstatus显示state: Active, physical state: LinkUp,说明IB网络链路通畅,这两条路缺一不可,任何一个断掉,分布式训练都会直接报错或陷入极慢的状态。
什么场景必须上NVLink,什么场景可以只靠IB
这可能是大家在实际选购中最关心的问题,多卡服务器怎么选NVLink配置,核心要看你跑什么任务。
必须上NVLink的场景:大模型训练与科学计算
- 大语言模型(LLM)训练:模型参数量超过单卡显存,必须用张量并行(TP),TP通信频率极高(每个Transformer层都要同步),如果不用NVLink,训练速度会慢到不可接受。
- 科学计算(分子动力学、CFD):这类应用往往需要GPU之间频繁交换边界数据,对延迟极其敏感。
- 显存池化需求:NVLink支持GPU显存统一寻址,比如Grace Hopper架构下CPU和GPU内存一致性,这是IB无法做到的。
可以不依赖NVLink的场景:部分推理与混合精度分布式
- 纯推理负载:如果只是部署已训练好的模型,且模型能塞进单张卡内,完全不需要NVLink,普通PCIe 4.0/5.0带宽就够用。
- 数据并行(DP)为主的训练:如果模型单卡能放下,只做数据并行,梯度同步周期性发生,对带宽要求相对宽松,这种情况下,如果预算有限,可以买不带NVLink的普通PCIe版GPU服务器,只配IB网卡做分布式,不过要注意,梯度的AllReduce通信量依然不小,IB网络必须配到位。
成本敏感的替代方案
很多用户问:NVLink与IB网络价格对比怎么样?这里直接说结论:
- NVLink成本:主要包含在GPU卡差价和服务器主板设计上,同型号GPU,带NVLink的版本比不带NVLink的版本贵约10%-15%(据市场公开报价规律),但NVLink不需要额外购买交换机。
- IB网络成本:包括HCA卡(单张约1万元左右)、IB交换机(36口400G交换机约10万元以上)、线缆(QSFP线缆数百到数千元每条),全栈IB网络的硬件成本,在8卡服务器中通常占整机成本的5%-10%。
如果是个人实验室或小团队,预算在10万以内配2-4卡服务器,建议优先保证NVLink(买带桥接器的RTX 4090或专业级GPU),IB网络可以先不配,后续要扩展多机时再补,如果是企业级集群,预算充足且未来一定会横向扩展,那么NVLink和IB都要一步到位。
如何规划一台多卡服务器的网络配置
在具体配置时,有几个实操步骤和避坑点值得收藏。
第一步:确认主板支持的NVLink通道数
不是所有多卡服务器都支持NVLink全互联,常见情况:
- 4卡服务器:部分主板支持2组NVLink Bridge桥接(每2卡一组),通信带宽是全互联的一半,适合小规模实验。
- 8卡服务器:必须配备NVSwitch芯片才能实现全互联,如果GPU是插在普通PCIe插槽上(无NVSwitch),那它们之间通信只能走PCIe Switch,带宽远低于NVLink,这种机器在跑大模型时会有明显瓶颈。
验证方法:用nvidia-smi topo -m查看GPU拓扑矩阵,如果显示NV#字样表示该链路走NVLink,显示PIX或PXB表示走PCIe。
第二步:根据节点数量选择合适的IB网络速率
- 2-4台服务器:建议每卡配200Gb/s HDR网卡即可,成本可控。
- 8台以上服务器:建议上400Gb/s NDR网络,或者使用无阻塞胖树拓扑,这里提醒一点:

IB交换机的端口数要预留30%的余量
,因为后期管理网络、存储网络也要占用端口。
第三步:区分网络用途
不少用户混淆IB和普通以太网,实际生产中,IB网络只走东西向流量(GPU之间的梯度同步和参数传输),而南北向流量(登录管理、数据上传下载)走千兆/万兆以太网,如果混在一个网络上,IB的流控机制会被以太网报文干扰,导致通信抖动,训练速度忽快忽慢。
多卡服务器的标准配置是双网络并行:IB网络负责计算通信,以太网负责管理,这也是为什么服务器上通常能看到两种网口的原因。
第四步:NVLink与PCIe的关系
无论是否启用NVLink,GPU都需要通过PCIe总线接入CPU才能执行内核启动和显存DMA操作,所以NVLink替代不了PCIe,它只是为GPU间通信开辟了一条专用通道,同理,IB网卡也必须挂在PCIe通道上,通常选用PCIe 5.0 x16插槽才能跑满400Gb/s带宽,如果主板只有PCIe 4.0,则实际带宽会打对折。
小节:任何场景下都不要把两者混为一谈
NVLink管的是卡间紧耦合通信,IB管的是机间松耦合通信,前者决定了单台机器能跑多大的模型,后者决定了整个集群能扩展到多大规模,在实际规划时,先确认你的模型尺寸和集群规模,再决定投入比例,对于绝大多数训练场景,二者缺一不可,但绝对不需要在单机内用IB连接GPU,那是对成本的浪费。
常见问题速答
问:如果服务器只有NVLink没有IB,能跑分布式训练吗?
可以,但仅限单机内通过环境变量NCCL_P2P_LEVEL=NV强制走NVLink进行多卡通信,一旦需要跨节点,没有IB网络就完全无法完成GPU间通信,只能用慢得多的TCP/IP,基本不具备实际训练可行性。
问:可以用以太网替代IB网络吗?
能用,但代价很大,主流以太网(RoCE)虽然能跑NCCL,但需要极精细的流控调优,且在拥塞场景下延迟陡增,在千卡集群规模下,IB的RDMA和自适应路由优势会更加明显,行业共识认为,追求稳定的生产环境优先选择IB,追求低成本的小规模实验可以考虑RoCE。
问:NVLink和IB网卡都需要独立供电吗?
NVLink桥接器不需要独立供电,但NVLink Switch(如NXSwitch)需要供电,IB网卡(HCA卡)功耗通常在15瓦左右,直接从PCIe插槽取电即可,不需要外接供电,但是高功率的OSFP光模块可能会额外增加功耗,整机功耗设计时需要把这部分算进去。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625675.html