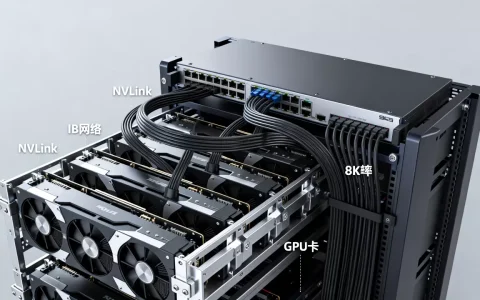
容器化训练任务的计算资源调度,核心是三层协同:Kubernetes原生调度器管基础调度,设备插件管GPU分配,作业级调度器管排队与优先级,只靠默认调度器跑大模型训练,一定会撞墙。
容器化训练任务资源怎么调度:先把调度器逻辑讲透
很多团队把训练任务塞进容器,以为配上 nvidia.com/gpu: 8 就完事,结果集群利用率低得吓人,行业共识认为,训练任务和普通Web服务在调度模型上存在根本差异:Web服务是长驻实例,启动一个算一个;训练任务是all-or-nothing的gang调度范式,要么全部Pod就绪一起跑,要么一个都别启动。


原生调度器为什么搞不定训练任务
Kubernetes默认调度器是逐个Pod调度的,一个分布式训练任务需要同时拉起几十个Worker和PS,每个Pod单独通过调度后,任务才能开始,如果集群资源只够其中30个Pod通过,剩下10个卡在Pending,那30个已经启动的Pod只能干等占用资源,训练不会推进,显存、CPU和网络带宽全部浪费,这就是资源碎片化的典型场景。
业内常用的解法是引入作业级调度器,把”调度单元”从Pod提升到整个Job,Volcano、Kueue、Koordinator是三种主流选择:
- Volcano:主打gang调度和队列管理,适配TensorFlow、PyTorch的PS架构和AllReduce架构,老牌方案,稳定性高
- Kueue:云原生计算基金会(CNCF)孵化的项目,主打队列和配额管理,与Kubernetes原生API集成更自然
- Koordinator:阿里开源的混部调度方案,擅长将离线训练和在线服务混合部署,资源超卖能力强
调度链路的三层模型
完整调度链路分三层:
- 第一层:Kubernetes原生调度器,负责将Pod分配到具体节点,处理亲和性、污点和容忍
- 第二层:设备插件(Device Plugin),负责GPU资源的发现、上报和分配,决定Pod能拿到哪块卡
- 第三层:作业级调度器,统一管理任务队列、优先级和资源配额,决定哪个训练任务先跑
三层缺一不可,只改第三层不动设备插件,显存分配可能出问题;只优化设备插件不管队列,多任务互相争抢资源的情况依然存在。
Kubernetes调度GPU训练任务:从配置到分配的完整路径
Kubernetes调度GPU训练任务配置,核心是两件事:请求量的声明和显存隔离策略,前者决定了调度器如何判断节点是否满足条件,后者决定了单卡上能否跑多个进程。
requests和limits的写法决定成败
先看一个标准的Pod声明:
resources:
  requests:
    nvidia.com/gpu: 1
    cpu: 8
    memory: 32Gi
  limits:
    nvidia.com/gpu: 1
    cpu: 8
    memory: 32Gi
requests告诉调度器”我需要这么多资源才能跑”,limits告诉kubelet”最多给我这么多”,对GPU而言,requests和limits必须一致,不能像CPU那样设置弹性配额,因为GPU硬件绑定无法超卖。
常见的坑有两个:
- 只写limits不写requests:在较老版本的调度逻辑中,Pod可以调度到GPU数量不足或显存已碎片化的节点
- CPU和内存的requests设置的过小:GPU分配成功后,CPU和内存资源不足导致Pod一直处于ContainerCreating状态
建议直接使用Kubernetes官方文档推荐的Extended Resource模式,同时把CPU、内存和GPU写入同一个QoS Class为Guaranteed的Pod中。
显存切分:一张卡能不能多人共用
默认情况下,一个GPU设备只能分配给一个Pod,显存只有16GB的卡,训练一个batch就占满显存,其他Pod只能干等,如果团队只有少量GPU卡,这种独占模式会让闲置算力白白浪费。
三种常见切分方式:
| 方案 | 切分粒度 | 隔离强度 | 适用场景 |
|---|---|---|---|
| NVIDIA MPS(多进程服务) | 进程级并发 | 弱隔离,显存不隔离 | 多个小模型推理任务 |
| NVIDIA MIG(多实例GPU) | 物理切分 | 强隔离,显存和算力均隔离 | A100/H100等专业卡 |
| 容器级显存虚拟化 | 显存虚拟切分 | 中等隔离,需额外插件 | 混合负载的日常开发测试环境 |
MIG是近些年最受推荐的方案,业内专家指出,MIG可以把一张A100 80GB切分成最多7个独立实例,每个实例具备独立的显存带宽和L2缓存,近乎物理隔离,缺点也明显:只有安培架构之后的专业卡支持,消费级RTX系列用不了。
容器化训练和裸机训练性能对比:损耗能接受吗
很多团队纠结要不要把已有训练任务容器化,担心容器化训练和裸机训练性能对比存在明显差距,容器本身不是性能瓶颈,瓶颈出在网络和存储。
容器化训练比裸机训练多出来的性能开销集中在:
- 网络层:Calico/Flannel等CNI插件会引入额外转发延迟,启用IPVS模式比iptables模式更能减少延迟损耗
- 存储层:如果数据集放在分布式文件系统中,首次读取的数据会被缓存,缓存命中后性能与本地盘接近
- 内核层:容器共享宿主机内核,GPU驱动和CUDA库版本如果与宿主机不一致,会出现兼容性故障,但不影响算力
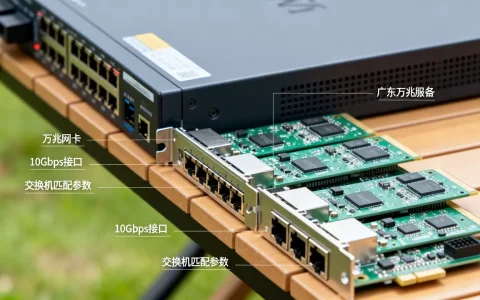
对于PyTorch DDP这类同步训练模式,网络延迟直接决定加速比,建议在多节点训练时开启RDMA或使用支持GPU Direct的网卡,否则千兆网卡会成为明显的瓶颈。
算力成本:一台GPU裸金属和容器云训练平台多少钱
算力成本是团队决策时绕不开的问题,容器化改造的ROI,需要对比裸金属方案和托管容器云方案。
自建机房的成本构成
自购GPU服务器的支出大约由四块构成:
- 硬件成本:一台8卡A100服务器大约几十万到上百万元
- 机房托管:电费和机柜费用按年支付,8卡满载功耗约6.5kW
- 运维人力:GPU驱动、CUDA环境、调度系统的维护至少需要1-2名专职人员
- 资源利用率:裸金属方案GPU平均利用率通常在30%-40%左右,大量算力碎片化闲置
北京容器云训练平台多少钱:按需计费是主流
北京容器云训练平台多少钱是团队咨询最多的问题,目前主流云厂商的训练平台大多按GPU卡时计费,即一张卡使用一小时的费用,以主流云厂商公开报价为例,T4级别单卡时价十几元,A100级别几十元,相比自建,云平台的优势在于:
- 资源秒级弹性扩缩容
- 不训练时不产生费用
- 免运维GPU驱动和调度系统
如果训练任务持续稳定且频率高,包年包月或预留实例价格更低,建议根据实际训练时长和频率测算,按需购买比盲目包月更适合间歇性训练场景。
多团队共享GPU集群:桶、配额和优先级怎么定
集群规模稍大,就会出现多团队资源争抢的情况,算法团队要跑实验,训练团队要排产任务,数据团队要做预处理,这个问题靠Kubernetes原生Namespace配额解决不了,需要作业级调度器的队列能力支撑。
Kueue的队列分层设计
以Kueue为例,资源管理分为三层:
- ClusterQueue(集群队列):定义整个集群的资源总量
- Cohort(资源池):多个ClusterQueue共享资源的池子,支持弹性借用
- LocalQueue(本地队列):对应用户或团队的入口
团队A请求资源时,LocalQueue会把请求提交给ClusterQueue,如果ClusterQueue内部资源不足,可以通过Cohort借用其他队列的空闲资源,任务结束后,借用的资源自动归还,通过这种方式,可以把整体利用率从40%左右提升至70%以上,避免了资源闲置和忙闲不均。
优先级抢占策略
线上服务保障性任务、训练任务、开发调试任务,三类任务的优先级显然不能相同,作业级调度器一般支持三种策略:
- 优先级队列:高优先级任务始终先调度
- 抢占:低优先级任务运行中可以被高优先级任务挤掉
- 装箱(Binpacking):优先将任务调度到已占用资源较多的节点,减少碎片
建议将训练任务的优先级设为中等级别,开发测试任务设为低优先级,这样可以避免大任务阻塞小实验,也能让小型任务利用碎片化空闲时间。
GPU碎片化:8卡机器只用了4卡怎么办
8卡GPU机器上跑一个4卡训练任务,剩下的4张卡可能因为显存版本、驱动版本或调度器策略无法分配给其他任务,解决思路是调度器的碎片整理机制。
最简单的方式是开启节点级Binpacking策略,让调度器倾向于把新任务放在已有任务运行的节点上,而不是分散到新节点,更彻底的方式是在调度器中实现任务编排:将多个小任务组合分配,或预留大任务运行时段,将小任务集中安排在非高峰时段,把整机资源留给大任务。
常见问题与排查思路
容器化训练任务资源怎么调度最省心?
直接使用Kubernetes原生调度器配合Kueue,再加上NVIDIA Device Plugin是最稳妥的组合,如果训练任务规模较大(超过16卡),优先配置gang scheduling能力,否则分布式训练任务在资源不足时容易造成死锁:部分Pod在跑,部分Pod等资源,谁也推进不了。
Kubernetes调度GPU训练任务时为什么卡在Pending?
优先检查四类情况,第一,节点GPU数量是否足够,kubectl describe node 查看Allocatable资源;第二,是否设置了显存隔离而插件未开启对应功能;第三,调度器是否有自定义过滤条件,查看调度器日志确认是否有节点亲和性冲突;第四,队列配额是否超出限制,作业级调度器会拒绝超出配额的请求,这些信息通常能在事件日志中看到具体原因。
容器化训练和裸机训练性能差异大不大?
单机单卡场景下,性能差异可以忽略不计,多机多卡训练场景,性能差异主要取决于网络和存储方案,使用RDMA网络、共享存储采用并行文件系统(如Lustre、GPFS)的情况下,性能损耗可控制在5%以内,可以放心容器化,若使用普通TCP网络和NFS存储,通信开销可能拉低整体吞吐,需要优先优化基础设施,而不是纠结容器本身。
容器化训练的资源调度不是单一工具能解决的问题,而是要打通Kubernetes原生调度、GPU设备管理、作业队列三层链路,结合优先级、抢占和装箱策略,才能把集群算力真正压榨出来,先把基础设施管明白,再谈训得快不快,这是调度问题的核心逻辑。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625679.html