大促期间日志采集对IO的占用,关键不是把日志关掉,而是把“同步写、全量收、慢消费”改成“异步批量、分级采样、削峰填谷”,让采集IO给订单和支付链路让路。 大促时真正拖慢系统的,往往不是日志量本身,而是采集器、本地缓冲和后端写入叠在一起形成的写放大。
大促期间日志采集为什么会拖慢磁盘IO
日志从产生到落盘,IO被放大了几次
你可以把日志采集想成一条水管:应用先往本地文件写,采集器再从头读到尾,中间可能还要落本地队列,最后发往后端存储,每一段都在消耗磁盘IO。
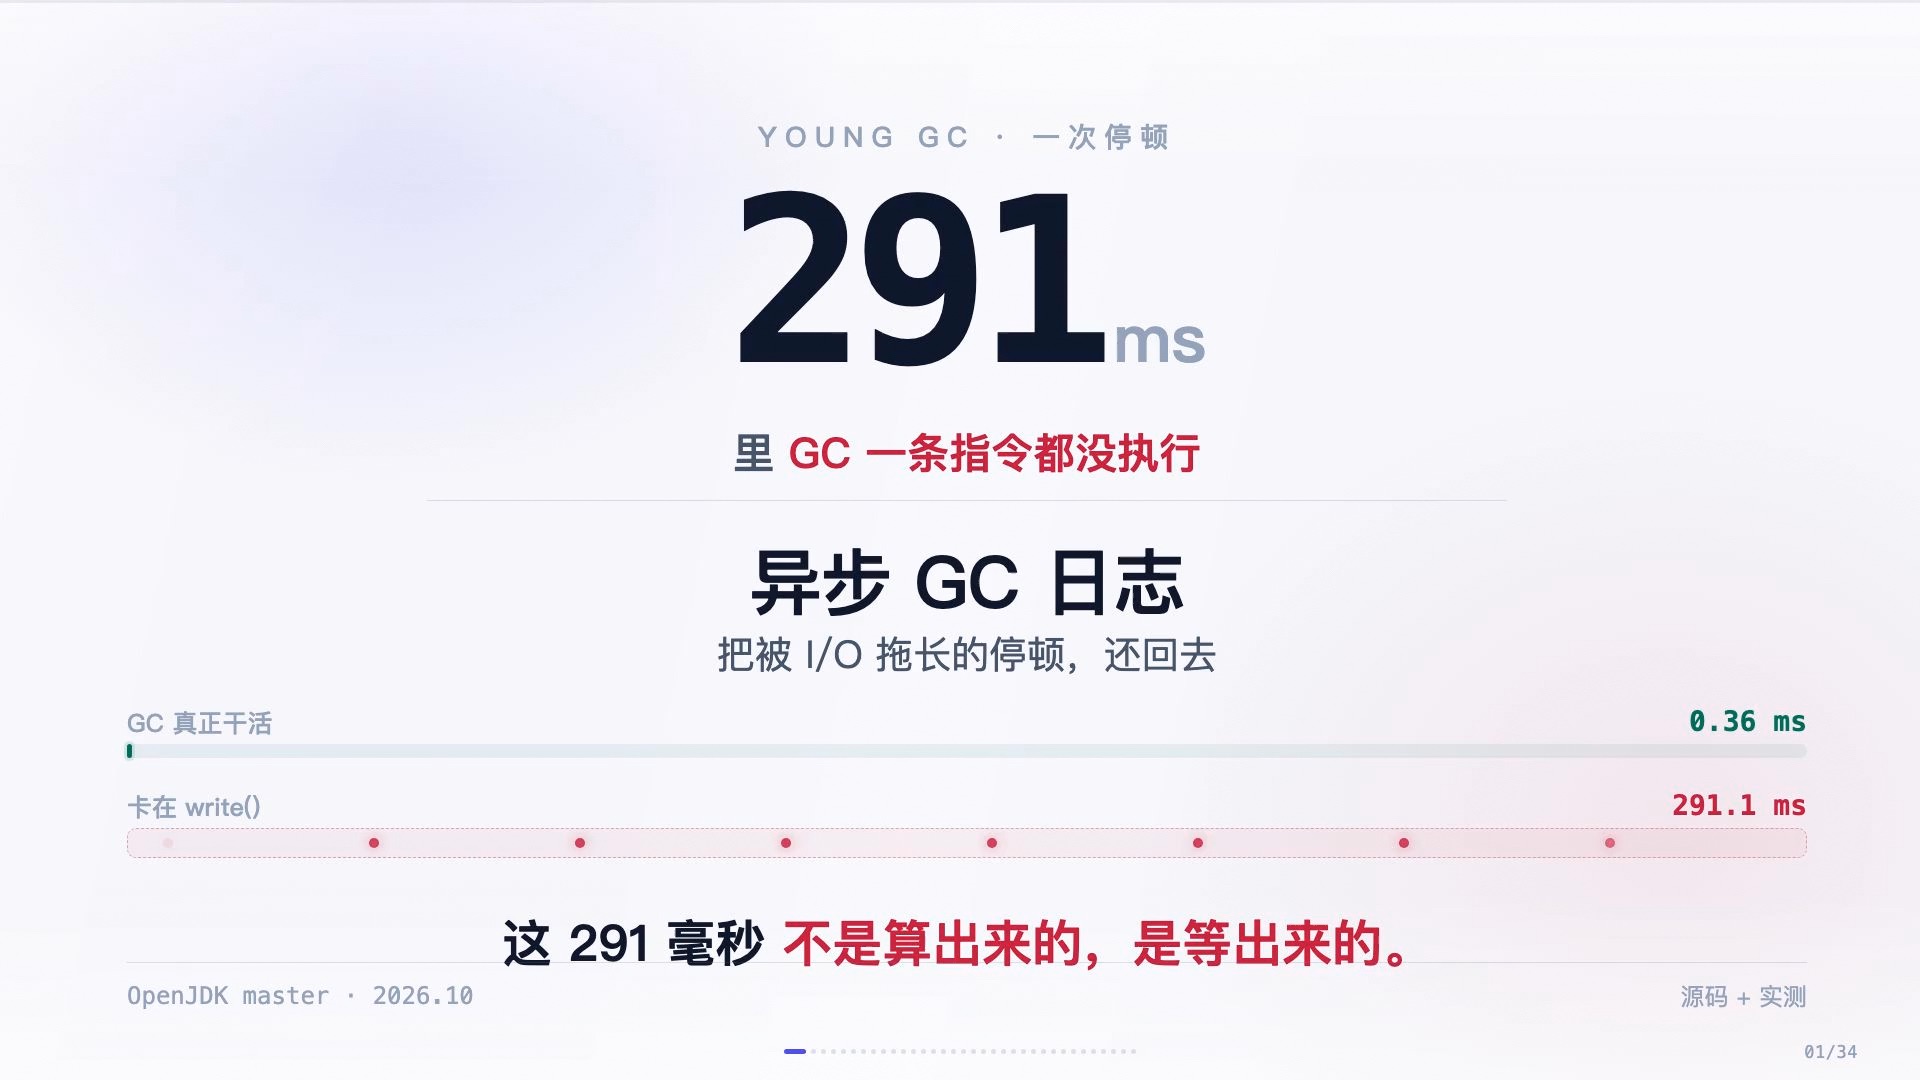
- 应用写日志:业务线程调用日志框架,同步Appender会直接触发文件写入,严重时参与刷盘。
- 采集器读文件:Filebeat、Fluent Bit等通过tail方式跟踪文件增长,文件越大、轮转越频繁,读放大越明显。
- 本地缓冲落盘:网络抖动或后端变慢时,采集器把数据写本地队列,磁盘从“读日志”变成“读日志+写队列”。
- 后端写入放大:Elasticsearch写入时产生translog和段合并,冷热不均时合并压力会反压到采集端。
- 重试风暴:Kafka或ES短暂不可用,采集端批量重试,重复数据再次落盘,IO被二次放大。
大促流量把三个短板同时放大
日常采集跑得稳,不代表大促稳,大促会把三个短板同时拉爆。
- 日志量突增:峰值日志量达到日常的数倍到十几倍,INFO日志和访问日志是主要增量。
- 错误日志暴涨:超时、重试、降级会打印大量堆栈,单条日志体积明显变大。
- 采集端背压:后端写入变慢,采集器队列积压,本地缓冲盘持续写满,业务盘和采集盘互相争抢。
定位时别只看磁盘使用率,先跑几条命令:
iostat -x 1 5
pidstat -d 1
iotop -o
cat /proc/$(pgrep filebeat)/io
重点看%util、await、w/s,再看采集进程的读写的kB_w/s,如果采集进程写本地队列的速率持续高于后端消费速率,说明问题在削峰,不在换盘。
日志采集对IO资源占用与CPU占用对比
不同采集策略的IO与CPU账本
| 策略 | 磁盘IO占用 | CPU占用 | 排障延迟 | 适用场景 |
|---|---|---|---|---|
| 同步写日志+实时全量采集 | 高 | 中 | 低 | 核心交易错误日志 |
| 异步Appender+批量发送 | 中 | 中 | 中 | 大多数业务服务 |
| 采样采集+压缩传输 | 较低 | 较高 | 中高 | 访问日志、调试日志 |
| 本地队列+Kafka削峰 | 中高 | 低 | 中 | 大促峰值削峰 |
| 直接写远端不落本地 | 低 | 中 | 高 | 网络稳定且可容忍丢失 |
IO占用高不等于CPU高。 压缩、结构化解析会吃CPU,但能减少网络和落盘量;采样能省IO,但会丢细节,行业共识认为,大促保障要先保交易链路,再保可观测链路,所以采集策略要分级,不要一刀切。
采集器参数怎么选才不挤占业务盘
先做三件事,再谈调参。
- 采集盘和业务数据盘分开,至少不要和数据库redo、binlog共用一块高负载盘。
- 给采集进程降IO权重:
ionice -c2 -n7 -p $(pgrep filebeat)。 - 文件系统挂载加
noatime,减少元数据写入:mount -o remount,noatime /data。
Filebeat可参考这组方向,重点是批量、压缩、队列上限和重试次数:
filebeat.inputs:
  - type: filestream
    paths:
      - /data/logs/.log
    prospector.scanner.check_interval: 10s
    close.on_state_change.inactive: 5m
output.kafka:
  hosts: ["kafka1:9092"]
  topic: "app-logs"
  bulk_max_size: 2048
  compression: gzip
  required_acks: 1
  max_retries: 3
queue.mem:
  events: 4096
  flush.min_events: 512
  flush.timeout: 5s
Fluent Bit更轻量,但本地缓冲要设上限,避免无限落盘:
[INPUT]
  Name tail
  Path /data/logs/.log
  Read_from_head false
  Buffer_Chunk_Size 256k
  Buffer_Max_Size 2M
[OUTPUT]
  Name es
  Match
  Host es.internal
  Index app-logs
  Retry_Limit 3
[OUTPUT]
  Name kafka
  Match
  brokers kafka1:9092
  topics app-logs
电商大促日志采集IO优化方案
采集层:先限流再批量
大促前把“全量实时”改成“分级实时”,ERROR、WARN全量,INFO按比例采样,DEBUG默认关闭,采集器设置单文件harvester上限,避免一次打开过多文件;输出端优先走Kafka削峰,不要让采集器直接扛ES写入压力。
- 给采集器单独的用户和cgroup,限制写带宽,防止它把业务盘打满。
- 文件轮转用按大小切分,单文件不要过大,减少tail扫描和重读。
- 网络失败重试设置上限,超过阈值进入退避,避免重试风暴。
日志层:异步Appender和分级采样
Java服务可把控制台和文件输出分离,业务日志走异步队列,Logback可参考:
<appender name="ASYNC" class="ch.qos.logback.classic.AsyncAppender">
  <queueSize>8192</queueSize>
  <discardingThreshold>0</discardingThreshold>
  <neverBlock>true</neverBlock>
  <appender-ref ref="FILE"/>
</appender>
neverBlock=true能避免业务线程被日志拖死,但要有丢弃策略,更稳妥的做法是核心错误日志保留同步落盘,普通INFO走异步和采样。
存储层:削峰、调刷新、冷热分层
后端别按日常峰值设计,Kafka做缓冲,ES索引调大刷新间隔,translog用异步,历史索引走冷热分层和ILM。
PUT /app-logs-2026.06/_settings
{
  "index.refresh_interval": "30s",
  "index.translog.durability": "async",
  "index.translog.sync_interval": "5s"
}
刷新间隔调大能减少段合并频率,但会牺牲一点实时性,大促期间排障更看重错误日志,访问日志可以接受分钟级延迟。
上海电商大促日志采集IO调优实践
某上海电商平台在双11前做过一轮调优:采集盘独立挂载,Filebeat写Kafka,ES只做消费;采集进程加ionice低权重,磁盘调度器改为mq-deadline,日志目录挂载noatime,操作路径不复杂:
echo mq-deadline > /sys/block/sdb/queue/scheduler
systemctl set-property filebeat.service IOWeight=100
调优后,业务盘的await波动明显收窄,采集端积压靠Kafka吸收,这类实践说明,采集IO治理要先做隔离,再做限流,最后才考虑扩容。
大促日志采集服务器IO成本大概多少钱
问成本,不能只看云盘单价,普通云盘、SSD云盘、ESSD的IOPS和吞吐上限不同,单价通常差出一个档位到数个档位,大促临时升配按小时计费,看似贵,但相比订单失败和支付超时,往往是更便宜的选择。
| 存储类型 | IOPS能力 | 成本量级 | 适合放什么 |
|---|---|---|---|
| 普通云盘 | 较低 | 低 | 冷日志、归档 |
| SSD云盘 | 中等 | 中 | 采集缓冲、普通日志 |
| ESSD类云盘 | 较高 | 高 | 核心ES热节点、数据库 |
据工信部公开的算力基础设施相关信息,企业日志与监控数据是增长较快的非结构化数据之一,真正要算的账是:采集IO挤占业务盘导致P99上升,带来的订单损失和扩容成本,预算有限时,优先把采集盘独立、把Kafka缓冲加上、把INFO日志采样掉,比直接堆高性能盘更划算。
Q&A:大促期间日志采集对IO资源的占用
大促期间日志采集IO占用多少算正常?
没有统一阈值,要看磁盘await、%util和业务P99,采集盘%util短时冲高可以接受,但await持续上升并传导到业务盘,就说明采集在抢IO,此时先限流采样,再查后端消费能力。
日志采集用Filebeat还是Fluent Bit更省IO?
两者IO开销主要来自读文件和本地缓冲落盘,采集器本身差异不是决定性的,Filebeat生态成熟、Kafka输出配置直观;Fluent Bit内存占用低、适合边缘和容器场景,大促时更关键的是批量大小、压缩、队列上限和重试策略。
大促期间能不能直接停掉日志采集?
不建议全停,全量停采会同时失去故障定位和审计依据,风险高于短期限流采样,可以关闭DEBUG、对INFO采样、保留ERROR和WARN全量、把传输错峰到低峰期,事实上有相当一部分团队就是这么撑过峰值的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773146.html