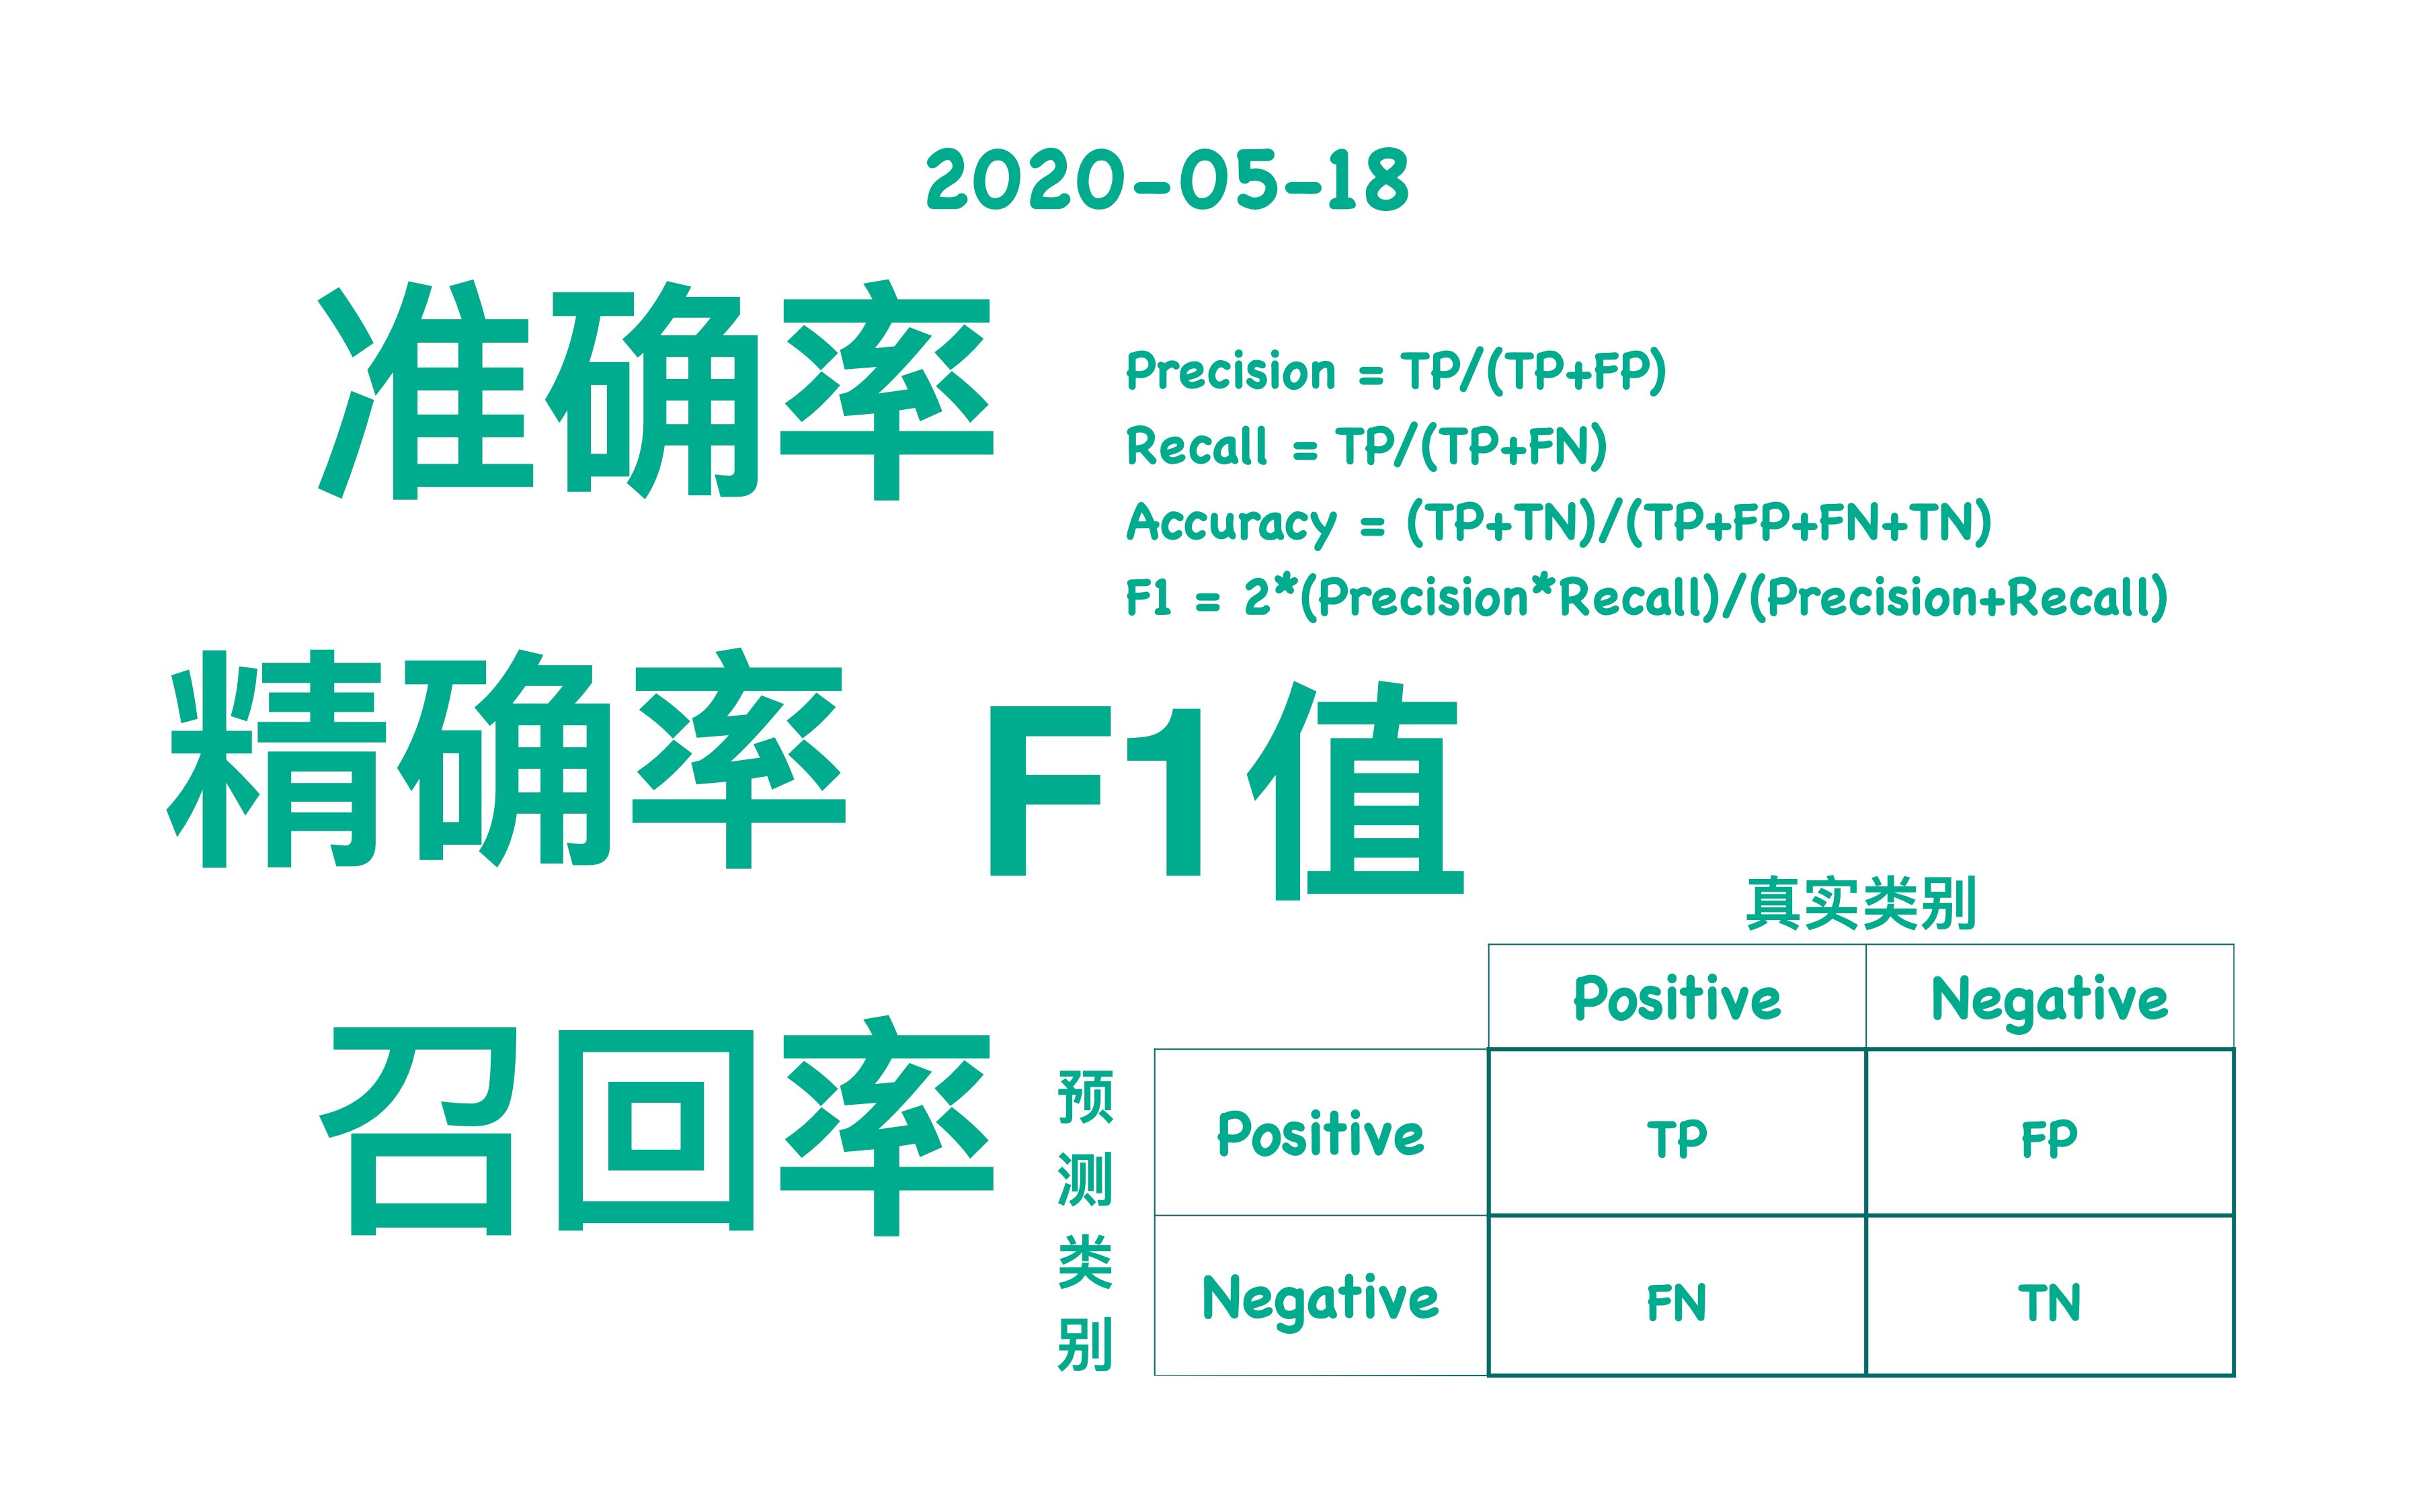
大模型的准确率(Accuracy)是通过计算模型预测正确的样本数占总样本数的比例来得出的,其核心公式为:准确率 = (预测正确的样本数 / 总样本数) × 100%。
在评估大语言模型(LLM)时,单纯看准确率往往会产生误导,因为大模型处理的是非结构化文本,而非简单的分类标签,业内专家指出,理解准确率背后的计算逻辑,必须结合具体的任务场景,如问答、翻译或代码生成,因为不同任务对“正确”的定义截然不同。

基础计算逻辑与核心公式拆解
要理解大模型的准确率,首先得回归到最基础的统计学定义,在传统的机器学习分类任务中,准确率是一个非常直观且易于理解的指标,它衡量的是模型在所有测试案例中,给出正确答案的比例。
什么是总样本数与预测正确数
假设你有一个包含100道选择题的测试集,大模型回答了所有题目,如果其中有85道题的答案与标准答案完全一致,那么准确率就是85%,这里的“总样本数”就是100,“预测正确数”就是85。
在大语言模型的语境下,情况变得复杂得多,因为LLM生成的通常是连续文本,而不是单一的选项,这就引入了一个关键问题:如何定义“完全一致”?
严格匹配与模糊匹配的差异
在简单的分类任务中,匹配是二元的:要么对,要么错,但在文本生成任务中,我们通常采用两种匹配方式:
- 严格匹配(Exact Match):模型生成的文本必须与参考答案逐字逐句完全相同,这种方式在大模型评估中过于严苛,因为即使意思完全正确,只要标点符号或同义词不同,就会被判定为错误。
- 模糊匹配(Fuzzy Match):通过语义相似度算法(如BLEU、ROUGE或基于嵌入模型的余弦相似度)来判断生成内容与参考答案的接近程度,这种方式更符合人类对“准确”的直觉认知。
大模型准确率评估的特殊挑战
与传统的图像识别或垃圾邮件分类不同,大模型的输出具有高度的开放性和多样性,直接使用Accuracy这一指标存在明显的局限性,行业共识认为,对于生成式任务,准确率往往不是唯一的衡量标准,甚至不是最重要的指标。

为什么准确率会失效?
当大模型用于创意写作、代码生成或复杂推理时,同一个问题可能有多种正确的回答方式,如果只用准确率来衡量,模型可能会因为生成了一种“非标准但正确”的答案而被错误地扣分。
大模型还存在“幻觉”问题,模型可能自信地生成一个看似合理但事实错误的答案,在这种情况下,准确率无法反映模型的可信度,只能反映它是否在“瞎编”的范围内保持一致。
场景化评估的重要性
为了更准确地评估大模型,我们需要将准确率拆解到具体的应用场景中,在医疗问答场景中,准确率要求极高,任何细微的错误都可能导致严重后果;而在创意写作场景中,准确率则更多体现在逻辑连贯性和风格一致性上,而非事实的绝对正确。
如何科学计算大模型的准确率
鉴于上述挑战,直接计算Accuracy往往不够全面,目前业界更倾向于使用组合指标,或者在特定子任务中应用准确率,以下是几种常见的实操方法。
基于自动化评估的准确率计算
对于结构化数据或标准化测试集(如MMLU、GSM8K),我们可以使用自动化脚本来计算准确率。
- 数据准备:构建包含输入(Prompt)和标准答案(Ground Truth)的测试集。
- 模型推理:将输入输入到大模型中,获取生成结果。
- 结果比对:
- 对于选择题:直接比对选项标签(A/B/C/D)。
- 对于数学题:使用代码解释器执行模型生成的代码,比对最终数值结果。
- 对于文本生成:使用NLP评估库(如Hugging Face的Evaluate库)计算BLEU或ROUGE分数,并设定阈值(如0.8以上视为正确)。
人工评估中的准确率应用
在涉及主观判断的任务中,自动化评估往往失效,此时需要引入人工评估,人工评估虽然成本高,但能更准确地反映模型的真实水平。

- 双盲测试:由两名独立专家对模型回答进行评分,计算评分者间的一致性。
- 偏好排序:让专家在多个模型的回答中选择最优者,通过胜率来间接反映准确率。
准确率与其他关键指标的关系
在评估大模型时,不能孤立地看待准确率,准确率、精确率(Precision)、召回率(Recall)和F1分数共同构成了一个完整的评估体系。
精确率与召回率的平衡
准确率只关心“猜对了多少”,而不关心“猜错了多少”以及“漏掉了多少”,在某些场景下,高准确率可能伴随着低召回率,一个模型只回答它非常有把握的问题,从而获得高准确率,但它可能拒绝回答大部分问题,导致召回率极低。
大模型评估中的F1分数
F1分数是精确率和召回率的调和平均数,能够更好地平衡两者的关系,在信息抽取、实体识别等任务中,F1分数比准确率更具参考价值。
不同场景下的准确率解读
理解准确率的含义,必须结合具体的应用场景,不同的任务类型对准确率的要求和计算方式各不相同。
问答与知识检索场景
在基于大模型的问答系统中,准确率通常指答案的事实正确性,近年来,随着RAG(检索增强生成)技术的普及,准确率更多取决于检索内容的准确性,而非模型本身的生成能力,据统计,采用RAG架构的系统在事实性问答中的准确率显著高于纯生成式模型。
代码生成场景
在代码生成任务中,准确率通常通过“通过测试用例的比例”来衡量,如果模型生成的代码能够100%通过预定义的单元测试,则视为正确,这种方式比文本比对更加客观和实用。
提升大模型准确率的实操建议
既然准确率的计算如此复杂,我们该如何在实际应用中提升大模型的准确率表现?以下是几条经过验证的实操路径。

优化提示词工程
清晰的提示词(Prompt)是提升准确率的第一步,通过提供详细的上下文、明确的指令和示例(Few-shot Learning),可以显著减少模型的歧义性,从而提高回答的准确性。
引入思维链(Chain of Thought)
对于复杂推理任务,要求模型在给出最终答案之前,先输出推理步骤,这种方法被称为思维链(CoT),研究表明,CoT能显著提升大模型在数学、逻辑推理等任务上的准确率,因为它迫使模型逐步验证其逻辑。
使用检索增强生成(RAG)
对于需要实时信息或特定领域知识的任务,结合外部知识库的RAG架构能有效降低幻觉,提升事实性准确率,通过限制模型仅基于检索到的相关文档生成答案,可以大幅减少错误信息的产生。
大模型的准确率计算并非简单的除法运算,而是一个涉及任务定义、匹配标准和评估方法的复杂过程,在2026年的今天,我们更应关注模型在特定场景下的综合表现,而非单一的准确率数字。
Q&A模块:大模型准确率常见疑问解答
大模型的准确率 Accuracy 怎么算才算科学?
科学计算大模型准确率需结合任务类型:分类任务采用严格匹配,文本生成任务采用语义相似度或人工评估,代码任务采用测试用例通过率,单一指标无法全面反映模型能力,建议结合F1分数、BLEU分数等综合评估。
为什么大模型的准确率有时比传统AI低?
因为大模型处理的是开放域文本,答案具有多样性,传统基于精确匹配的准确率指标无法有效衡量其语义正确性,大模型存在幻觉问题,可能在自信状态下生成错误信息,导致在严格标准下准确率偏低。
如何在不进行人工评估的情况下提高准确率可信度?
可以使用自动化评估框架如MMLU、HELM等基准测试集,结合基于嵌入模型的语义相似度计算和代码执行验证,这些方法能在一定程度上模拟人工判断,提供相对客观的准确率参考数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/406517.html