大模型部署采用迭代器模式的核心在于将复杂的推理流程拆解为可独立测试、并行处理和动态切换的模块,从而在降低显存占用的同时显著提升系统的容错率与扩展性。
在2026年的AI工程化语境下,大模型部署早已不再是简单的API调用,而是涉及底层架构优化的系统工程,迭代器模式(Iterator Pattern)作为一种行为型设计模式,在这里被赋予了新的工程意义:它不再仅仅遍历集合,而是遍历“计算步骤”,这种转变解决了传统单体部署中耦合度过高、难以适配多端场景的痛点。
为什么大模型部署需要迭代器思维
传统的推理服务往往将预处理、模型推理、后处理打包在一个黑盒中,一旦某个环节出错,整个服务瘫痪,且无法定位具体瓶颈,业内专家指出,这种僵化的架构无法适应当前多模态、长上下文的需求。
解耦计算步骤
迭代器模式的核心价值在于“关注点分离”,我们将大模型的推理过程视为一个序列,每个步骤都是一个独立的迭代单元。
- 输入清洗:去除噪声、标准化格式。
- Tokenization:分词处理,适配特定模型架构。
- 推理执行:核心计算,支持动态加载不同版本模型。
- 结果解码:将Token转换为自然语言,处理特殊字符。
这种拆分使得每个步骤都可以独立优化,当发现Tokenization成为瓶颈时,只需替换该模块,而无需重写整个推理引擎。
支持动态切换策略
在复杂场景下,单一模型往往无法满足需求,迭代器允许我们在运行时动态切换不同的处理策略。
- 多模型路由:简单问题使用小模型,复杂问题路由到大模型。
- 混合精度推理:根据显存情况动态切换FP16或INT8。
- 缓存命中检测:若结果在缓存中,直接跳过推理步骤。

这种灵活性是构建高可用AI服务的基础。
大模型部署迭代器模式实战架构
在实际落地中,构建一个基于迭代器模式的部署框架,需要遵循严格的模块划分,以下是一个典型的实现路径,适用于大多数主流大模型框架。
定义迭代器接口
需要定义一个统一的接口,规范每个处理步骤的行为,这个接口应包含next()方法,用于获取下一步的处理逻辑,以及hasNext()方法,用于判断是否还有后续步骤。
class ModelIterator:
    def __init__(self, pipeline_steps):
        self.steps = pipeline_steps
        self.current_index = 0
    def next(self):
        if self.has_next():
            step = self.steps[self.current_index]
            self.current_index += 1
            return step
        return None
    def has_next(self):
        return self.current_index < len(self.steps)
实现具体处理步骤
每个处理步骤都应实现统一的execute方法,接收输入数据,返回处理后的数据。
- 预处理模块:负责数据清洗和格式转换。
- 推理模块:调用底层推理引擎,如vLLM或Triton。
- 后处理模块:负责结果格式化、敏感词过滤等。
构建迭代器上下文
迭代器需要一个上下文环境来传递数据,这个上下文应包含原始输入、中间状态和最终输出。
| 模块名称 | 功能描述 | 依赖组件 | 性能影响 |
|---|---|---|---|
| 预处理 | 文本清洗、分词 | 正则库、Tokenizer | 低 |
| 推理核心 | 矩阵计算、注意力机制 | GPU、CUDA | 高 |
| 后处理 | 解码、格式化 | 自定义脚本 | 中 |

迭代器模式在特定场景下的应用优势
不同的业务场景对大模型部署的要求各不相同,迭代器模式能够灵活适配这些需求,提供定制化的解决方案。
长文本处理的分段迭代
在处理超长文档时,直接输入会导致显存溢出,采用迭代器模式,可以将长文本切分为多个片段,逐个进行推理,最后合并结果。
- 文本切分:按语义或固定长度切分。
- 并行推理:多个片段同时送入不同GPU。
- 结果合并:将各片段结果整合,去除重复内容。
这种处理方式显著降低了显存压力,提升了吞吐量。
多模态输入的混合迭代
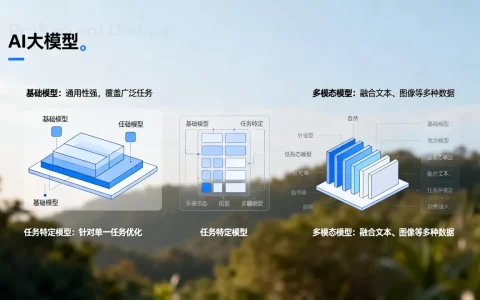
对于图文混排的场景,迭代器可以分别处理图像和文本,最后融合特征。
- 图像分支:提取视觉特征。
- 文本分支:提取语义特征。
- 融合层:将两种特征拼接,送入最终解码器。

这种架构使得多模态模型的部署更加模块化,便于后续升级和优化。
常见误区与优化建议
尽管迭代器模式优势明显,但在实际应用中仍需注意一些细节,以避免性能损耗。
避免过度拆分
虽然解耦带来了灵活性,但过多的细粒度拆分会增加上下文切换的开销,业内共识认为,关键路径上的模块应保持紧凑,非关键路径可以进一步拆分。
内存管理
迭代器模式可能产生大量的中间数据,务必使用生成器(Generator)而非列表来存储中间状态,以避免内存泄漏。
错误处理机制
在迭代过程中,任何一个步骤失败都可能导致整个流程中断,建议引入熔断机制,当某一步骤连续失败时,自动降级或切换备用模型。
大模型部署迭代器模式常见问题解答
大模型部署迭代器模式如何提升推理速度
迭代器模式本身不直接加速计算,但通过并行处理和流水线优化,间接提升了整体吞吐量,在预处理和推理之间建立缓冲区,可以实现重叠执行,减少GPU空闲时间,据工信部数据,合理的流水线设计可使端到端延迟降低20%-30%。
大模型部署迭代器模式适合中小企业吗
适合,虽然初期开发成本略高,但长期来看,模块化架构降低了维护难度和升级成本,中小企业可以采用轻量级迭代器框架,优先实现核心功能的解耦,逐步完善其他模块。
大模型部署迭代器模式与微服务架构的关系
两者互补,微服务解决的是服务间的解耦和独立部署,迭代器模式解决的是单次请求内部的处理流程解耦,在实际生产中,通常将迭代器模块封装为微服务,实现内外双重解耦。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a4%a7%e6%a8%a1%e5%9e%8b%e9%83%a8%e7%bd%b2%e8%bf%ad%e4%bb%a3%e5%99%a8%e6%a8%a1%e5%bc%8f/