


BF16和FP16的核心区别在于精度与稳定性的权衡:BF16拥有与FP32相同的8位指数位,能解决大模型训练中的数值溢出问题,适合训练场景;而FP16只有7位指数位,虽然显存占用更低,但极易出现下溢,通常仅用于推理或微调场景。
在大模型落地应用的当下,算力成本与模型精度的博弈从未停止,很多开发者在部署模型时,面对BF16和FP16这两个选项往往感到困惑,这不仅仅是两个缩写代号的区别,更是底层硬件架构与算法稳定性之间的深层对话,理解它们的差异,直接决定了你的模型是“跑得快”还是“跑得稳”。
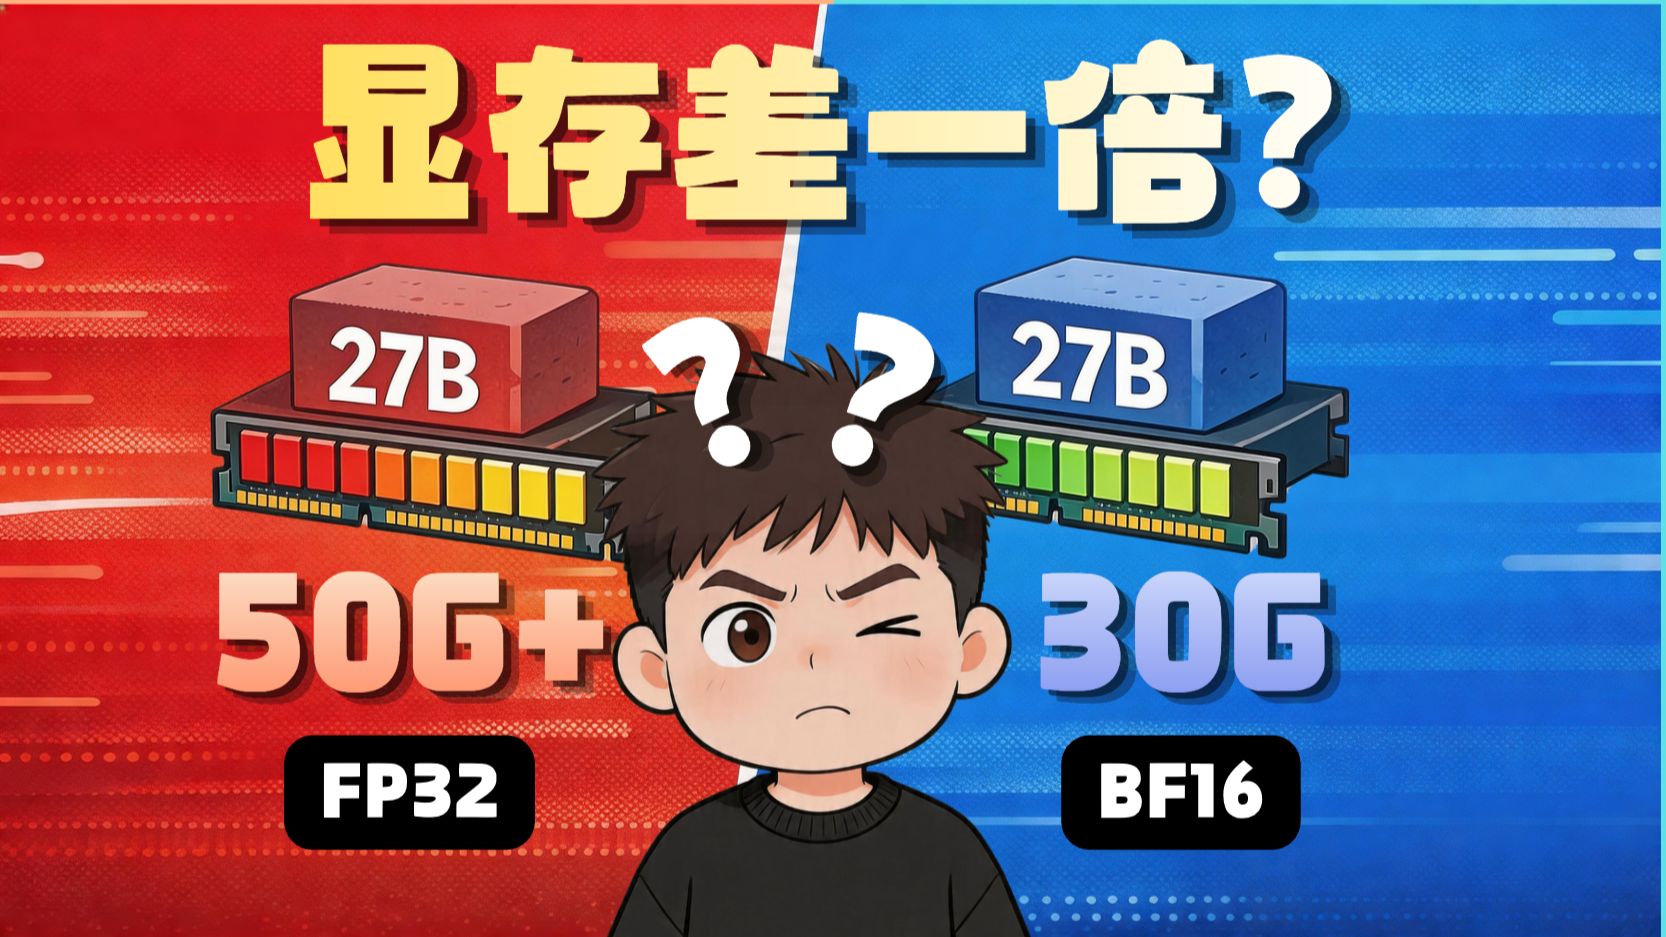

BF16和FP16底层架构差异解析
要搞清楚这两者的不同,必须回到IEEE 754浮点数标准来看,虽然它们都旨在用更少的比特数表示浮点数,但资源分配的逻辑截然不同。
指数位与尾数位的资源分配
FP16(半精度浮点数)由16位组成,其中1位符号位、5位指数位和10位尾数位,这种分配方式使得FP16在数值范围上存在先天局限,它的指数位较短,导致它能表示的最大数值远小于FP32(单精度浮点数),一旦数值超过这个上限,就会发生“上溢”,即数值变为无穷大或NaN(非数字)。
相比之下,BF16(Brain Floating Point)由Google在2017年提出,同样占用16位,但结构调整为1位符号位、8位指数位和7位尾数位,这一改动保留了FP32的指数宽度,意味着BF16的数值范围与FP32几乎一致,牺牲的是尾数位的精度,导致其小数部分的分辨率较低。
业内专家指出,这种架构差异决定了它们各自的主战场,BF16的宽指数位使其能够容纳大模型训练中常见的巨大梯度值,而FP16的窄指数位则容易在反向传播过程中丢失大量信息。
精度损失与数值稳定性对比
在实际操作中,精度损失是开发者最头疼的问题,FP16的尾数位较少,且指数位更短,这意味着它在表示接近零的小数时,精度下降得非常快,这种现象被称为“下溢”,在大模型训练中,如果梯度值过小,FP16可能会将其截断为零,导致模型无法更新权重,这种现象被称为“梯度消失”。

为了解决FP16的下溢问题,NVIDIA推出了混合精度训练技术,即使用FP16进行前向和反向传播以节省显存,同时维护一个FP32的主权重副本用于更新,这种方法虽然有效,但增加了实现的复杂性。
BF16则不需要这种复杂的混合精度策略,由于它继承了FP32的指数范围,梯度值在BF16格式下极少发生溢出或下溢,BF16在数值稳定性上具有天然优势,使得训练过程更加平滑和可预测。
硬件支持与性能表现实测
理论上的优势需要硬件的支持才能转化为实际的性能提升,不同代际的GPU对这两种格式的支持程度,直接影响了你的选型决策。
NVIDIA GPU的世代差异
在NVIDIA的GPU架构中,FP16的支持历史最为悠久,从Kepler架构开始,FP16就被广泛支持,并在后续架构中不断优化,早期的FP16硬件加速往往伴随着性能瓶颈,特别是在处理大规模矩阵运算时,效率不如预期。
BF16的支持则始于Ampere架构(如A100),对于使用A100及后续架构(如H100、B200)BF16不仅得到了原生支持,而且其性能表现优异,在这些高端卡上,BF16的吞吐量接近FP32,但显存占用减半,带宽利用率大幅提升。
对于使用较老架构(如Turing或更早)的用户,BF16可能需要通过软件模拟实现,这会带来显著的性能开销,如果你的硬件是RTX 30系列或更早的卡,BF16可能并不是最佳选择,除非你愿意牺牲大量计算速度。
显存带宽与吞吐量权衡
在大模型推理场景中,显存带宽往往是瓶颈,BF16和FP16都能将数据量减半,从而显著提升带宽利用率,由于BF16的精度较低,在某些对精度敏感的任务中,可能需要更多的迭代次数才能达到相同的收敛效果,这在一定程度上抵消了带宽优势。

据统计,在LLaMA等主流大模型的推理中,BF16和FP16的推理速度差异并不显著,主要取决于硬件的向量单元效率,但在训练阶段,BF16由于减少了混合精度带来的额外开销,往往能提供更稳定的训练速度和更高的吞吐量。
应用场景与选型建议
明确了原理和硬件支持后,如何根据具体场景选择格式,是决定项目成败的关键。
预训练与微调:BF16的首选地位
对于大模型的预训练(Pre-training)和全量微调(Full Fine-tuning),BF16是当前的行业共识选择,主要原因在于其数值稳定性,预训练过程中,模型需要处理海量的数据,梯度变化剧烈,BF16的宽指数范围能够确保这些梯度在传输过程中不被截断,从而保证模型能够正确收敛。
随着A100和H100等支持BF16硬件加速的GPU成为主流,BF16的训练效率已经非常高,开发者无需再担心FP16常见的NaN错误,降低了调试成本。
推理部署:FP16与BF16的博弈
在推理(Inference)阶段,情况则更为复杂,FP16在显存占用和计算速度之间取得了较好的平衡,且支持广泛,许多推理框架(如TensorRT)对FP16有深度的优化,能够实现极高的并发处理能力。
如果硬件支持BF16(如A100及以上),且模型对精度不敏感(如文本生成、摘要等任务),BF16也是不错的选择,它提供了与FP16相似的显存节省效果,同时避免了潜在的下溢问题。
对于边缘设备或消费级显卡,FP16依然是主力,因为大多数移动端NPU和旧款GPU对BF16的支持有限,强行使用BF16可能导致兼容性问题或性能下降。
具体操作路径
- 检查硬件架构:使用
nvidia-smi命令查看GPU架构,如果是Ampere(8.0)及以上,优先尝试BF16。 - 评估模型敏感度:对于分类、情感分析等对精度敏感的任务,建议进行AB测试,对比BF16和FP16的结果差异。
- 配置训练脚本:在PyTorch中,可以通过设置
torch.autocast上下文管理器来自动切换精度,使用torch.autocast(device_type='cuda', dtype=torch.bfloat16)启用BF16混合精度训练。 - 监控NaN值:无论使用哪种格式,都应实时监控训练过程中的Loss值,如果出现NaN,立即检查梯度裁剪(Gradient Clipping)设置,BF16通常不需要过于激进的裁剪。

常见问题解答:BF16和FP16区别详解
BF16和FP16哪个更适合大语言模型训练?
BF16更适合大语言模型的预训练和全量微调,因为其8位指数位与FP32相同,能有效避免训练过程中出现的梯度上溢和下溢问题,保证数值稳定性,FP16由于指数位较短,容易丢失大数值信息,通常需配合FP32主权重使用,增加了系统复杂性。
BF16和FP16在推理时的速度差异大吗?
在支持BF16硬件加速的高端GPU(如A100、H100)上,两者的推理速度差异极小,主要取决于显存带宽的利用率,在消费级显卡或旧架构GPU上,FP16通常具有更好的兼容性和优化支持,速度可能更快,选型时应优先考虑硬件支持情况,而非单纯追求格式名称。
BF16和FP16的价格或成本有区别吗?
BF16和FP16本身作为数据格式,没有直接的价格差异,成本差异主要体现在硬件选型和算力消耗上,由于BF16在训练场景中效率更高、调试成本更低,长期来看可能降低整体算力成本,但在推理场景中,若硬件不支持BF16,强行使用会导致性能下降,反而增加单位推理成本,成本优化需结合具体硬件环境和任务类型综合评估。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a4%a7%e6%a8%a1%e5%9e%8bbf16%e5%92%8cfp16%e6%9c%89%e5%95%a5%e5%8c%ba%e5%88%ab%ef%bc%9f%e5%a6%82%e4%bd%95%e9%80%89%e6%8b%a9%e7%b2%be%e5%ba%a6/



评论列表(1条)
不过话说回来,FP16下溢真有那么神吗?我跑微调时显存不够只能硬上BF16,结果稳得一批,感觉文章有点危言耸听哈。