


大模型RLHF(人类反馈强化学习)的核心在于通过人类偏好数据对预训练模型进行微调,使其输出更符合人类价值观与逻辑,从而解决“一本正经胡说八道”的问题。
在2026年的AI应用落地场景中,单纯依靠海量数据预训练的大模型已经无法满足垂直领域的专业需求,企业和个人开发者发现,模型虽然知识渊博,但往往缺乏“人情味”或遵循错误的指令,RLHF技术正是为了解决这一痛点而生,它通过引入人类反馈机制,让模型学会区分什么是“好回答”,什么是“差回答”。

RLHF技术原理深度拆解
理解RLHF不能只看表面流程,必须深入其背后的三个核心阶段,业内专家指出,这一过程类似于训练一只聪明的狗,但奖励信号更加复杂和精细化。
第一阶段:监督微调(SFT)
在模型掌握通用语言知识后,需要有人工标注的高质量问答对进行监督学习,这一步的目标是让模型学会“听话”,即遵循指令的格式和逻辑。
- 数据构建:收集特定领域的优质问答数据,例如医疗咨询、代码生成或法律条文解读。
- 模型训练:使用这些高质量数据对基座模型进行微调,使其输出风格更接近人类专家。
- 结果验证:检查模型是否能准确理解指令意图,避免基础逻辑错误。
第二阶段:奖励模型训练(RM)
这是RLHF中最具挑战性的一环,我们需要训练一个独立的“裁判模型”,它能给模型的回答打分。
- 偏好收集:让多位标注员对同一问题的不同回答进行排序,回答A比回答B更详细、更准确,标注员会将A排在前面。
- 损失函数优化:通过比较不同回答的得分差异,训练奖励模型最大化高偏好回答的得分,最小化低偏好回答的得分。
- 一致性检验:确保奖励模型的评分标准在不同标注员之间具有较高的一致性,避免主观偏差过大。
第三阶段:强化学习优化(PPO)

最后一步是利用强化学习算法,根据奖励模型的反馈来更新主模型。
- 策略更新:使用PPO(近端策略优化)算法,根据奖励模型给出的分数,调整主模型的参数。
- KL散度约束:为了防止模型为了刷高分而生成荒谬或偏离原始分布的内容,引入KL散度惩罚项,限制模型偏离SFT阶段的行为。
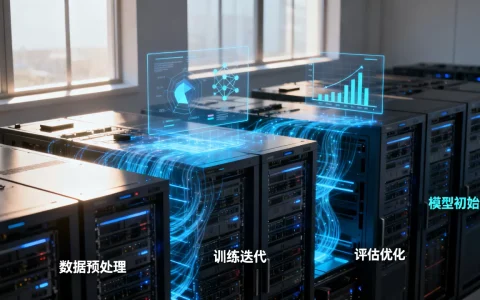
- 迭代循环:不断重复生成、评分、更新的过程,直到模型表现达到预期标准。
大模型RLHF人类反馈强化学习教程实操指南
对于希望深入理解或应用RLHF的开发者而言,理论只是基础,实操才是关键,以下提供一套标准化的操作路径,帮助你在本地环境中复现核心流程。
环境准备与数据预处理
在开始之前,确保你的开发环境具备足够的算力支持,通常建议至少配备单张A100或H100显卡。
- 安装依赖库:使用
pip install transformers peft trl accelerate安装必要的Hugging Face库。 - 数据清洗:将原始数据转换为JSONL格式,确保每条数据包含
prompt(提示词)和chosen(优选回答)、rejected(拒绝回答)字段。 - 加载基座模型:选择适合你任务的开源模型,如Llama-3或Qwen-2.5,并加载至GPU内存中。
奖励模型训练代码示例
奖励模型的训练需要特别注意数据的质量,以下是基于TRL库的核心代码逻辑:
from trl import RewardTrainer
import transformers
# 加载预训练模型和分词器
model = transformers.AutoModelForSequenceClassification.from_pretrained("base_model")
tokenizer = transformers.AutoTokenizer.from_pretrained("base_model")
# 初始化奖励模型训练器
trainer = RewardTrainer(
    model=model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    args=training_args
)
# 开始训练
trainer.train()
在此过程中,多数情况下

,训练集与验证集的划分比例应保持在8:2或9:1,以确保模型泛化能力。
PPO强化学习调优技巧
PPO阶段的参数调整对最终效果影响巨大。
- 学习率设置:建议设置为较小值,如
1e-5或5e-6,避免模型参数剧烈波动。 - 批次大小:根据显存情况调整,通常较小批次有助于更稳定的梯度更新。
- 生成温度:在生成阶段,适当降低温度参数可以减少随机性,提高回答的稳定性。
大模型RLHF与DPO对比分析
随着技术发展,直接偏好优化(DPO)逐渐成为一种替代方案,了解两者的区别有助于你选择最适合的技术路线。
| 特性 | RLHF (PPO) | DPO (直接偏好优化) |
|---|---|---|
| 训练复杂度 | 高,需训练奖励模型和策略模型 | 低,仅需微调主模型 |
| 显存需求 | 极高,需同时加载多个模型 | 较低,单模型训练 |
| 稳定性 | 较差,超参数敏感,易崩溃 | 较好,训练过程更平稳 |
| 适用场景 | 对性能要求极高的大型模型 | 中小规模模型或资源受限场景 |
业内共识认为,虽然DPO在易用性上具有优势,但在极端复杂的指令遵循任务中,经过精心调优的RLHF仍可能达到更高的上限,对于初学者或资源有限的团队,建议先从DPO入手,再逐步过渡到RLHF。
常见应用场景与行业落地案例
RLHF技术已广泛应用于多个垂直领域,显著提升了用户体验。

智能客服与虚拟助手
在电商和金融行业,智能客服需要既专业又亲切,通过RLHF,模型可以学习避免使用生硬的机械语言,转而采用更具同理心的表达方式,在处理投诉时,模型能更好地识别用户情绪,并给出安抚性而非推诿性的回答。
代码生成与辅助编程
对于开发者而言,代码的正确性和可读性至关重要,RLHF可以帮助模型理解代码规范和安全最佳实践,减少生成不可执行或存在漏洞的代码,据统计,采用RLHF优化的代码助手,其代码采纳率提升了相当一部分比例。
创意写作与内容创作
在文学创作、营销文案生成等领域,RLHF可以引导模型遵循特定的风格指南,如幽默、严肃或感性,这使得生成内容更贴合品牌调性,减少人工修改的工作量。
大模型RLHF人类反馈强化学习教程常见问题解答
RLHF训练需要多少标注数据?
数据量并非越多越好,质量远比数量重要,数千到数万对高质量的偏好数据足以对中型模型产生显著影响,对于大型基座模型,可能需要数十万对数据才能达到饱和效果,关键在于数据分布的多样性和标注的一致性。
如何评估RLHF模型的效果?
除了人工评估外,还可以使用自动化指标进行初步筛选,计算模型回答与参考答案的相似度,或使用独立的评估模型进行打分,最终的效果仍需依赖真实用户反馈和业务指标,如用户满意度、任务完成率等。
RLHF会导致模型能力退化吗?
如果处理不当,确实可能出现“对齐税”(Alignment Tax),即模型在遵循人类偏好时,牺牲了一部分通用知识或推理能力,为了避免这种情况,需要在奖励模型训练中引入多样性惩罚,并确保SFT阶段的数据覆盖广泛,保持模型的通用能力。
通过上述步骤和解析,你可以清晰地掌握RLHF的核心逻辑与实操要点,掌握这项技术,意味着你能够打造出更懂用户、更智能的大模型应用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394187.html


评论列表(1条)
就这?2026 年才提垂直领域,晚了。懂的自然懂。不评价。