大规模join查询的性能瓶颈,通常不是集群总算力不足,而是少数节点被倾斜数据压垮,导致整个作业在最后一个task上长时间卡死。
大数据join数据倾斜怎么解决:先把节点间数据分布看清楚
数据倾斜不是玄学,是分布式计算里最典型的“木桶效应”,某个join键在数据源中占比一旦明显高于其他键,相同键的记录就会被shuffle到同一个reduce或executor节点,别的节点几分钟跑完,这个节点要跑几十分钟甚至溢出到磁盘,作业进度条停在99%,其实是那一个task还在硬扛。

倾斜发生的典型信号
- Spark UI的Stage详情里,max task duration和median task duration差距达到数倍甚至一个量级。
- Shuffle Read Size分布出现部分task读入量远高于平均值,说明shuffle键分布不均。
- Hive任务里reducer执行时间出现明显长尾,
show tasks或YARN日志能看到某些task迟迟不结束。 - 直接统计join键频次,
SELECT join_key, COUNT() FROM table GROUP BY join_key ORDER BY COUNT() DESC LIMIT 100,问题键会自己浮出来。
为什么调大内存没用
很多团队一上来就加executor内存、调并行度,结果发现任务还是卡死,因为倾斜节点的数据量没有变,内存再大也会被单点数据撑爆,真正要动的是数据分布和join策略,而不是资源上限,把数据打散到多个节点,比让一个节点吃下全部热点记录可靠得多。
电商大促实时join查询数据倾斜为何总在关键时刻爆发
以电商大促为例,订单表order_detail和用户表user_info做join,join键是user_id,正常情况下用户分布比较均匀,但大促期间部分头部用户、刷单账号或黑产账号会产生远超普通用户的操作记录,订单表里某个user_id可能出现了几万条,而普通用户只有几条,shuffle把这部分记录全推到同一个reduce节点,实时数仓里Flink或Spark Streaming任务也会因为热点用户导致某个并行度被撑爆。
热点用户如何击穿单节点
订单表里一个异常活跃的user_id,会让单节点同时处理几万次join操作,该节点不仅要读取大量输入,还要维护哈希表、执行匹配、输出结果,CPU和内存同时吃紧,其他并行度几分钟完成,这个节点可能跑几十分钟,最后触发超时或者OOM,整个消费进度被拖慢,实时链路出现延迟堆积。
流式join的临时止血配置
事前预防常用两级聚合:给热点key加随机前缀打散,做局部聚合,再去掉前缀做全局聚合,事中止血更依赖运维侧参数调整,Flink里可以设置table.exec.mini-batch.enabled=true和table.exec.mini-batch.allow-latency=5s,让热点key在算子内部先合并,减少外部shuffle压力,这种方案会牺牲一点时效性,大促高峰时通常可以接受,同时可以把出现倾斜的并行度临时调高,但要注意别把压力转移给下游。
Spark join和MapReduce join数据倾斜对比:执行计划差异在哪
很多开发者会把Spark和MapReduce的join优化混为一谈,其实两者处理倾斜的思路并不一样。
| 维度 | Spark join优化 | MapReduce join优化 |
|---|---|---|
| 倾斜检测 | 依赖AQE动态调整,可自动切换join策略 | 主要靠参数hive.optimize.skewjoin和手动指定倾斜key |
| 处理方式 | 广播小表、加盐打散、自定义分区器 | 单独把倾斜key写进临时目录,启动独立job处理 |
| 执行计划灵活性 | spark.sql.adaptive.enabled=true会优化shuffle分区数 |
执行计划固定,需要改写SQL或预分区 |
| 实时场景适配 | 能配合Structured Streaming使用 | 基本只适合批处理 |
| 调优难度 | 中等,需理解AQE行为 | 偏高,需手动维护倾斜key列表 |
Spark AQE自动拆分的边界
Spark 3.x打开AQE后,spark.sql.adaptive.skewJoin.enabled=true会自动将倾斜分区拆分成多个子分区,让更多task并行处理,这个能力在RDD时代要自己写代码实现,但它不是万能的,自动拆分依赖shuffle写出后的统计信息,如果倾斜key在shuffle前就已经造成上游task严重不均衡,AQE能做的仍然有限,Hive侧则依赖hive.optimize.skewjoin=true配合hive.skewjoin.key指定阈值,一旦热点key不在列表里,长尾依旧存在。
北京地区数据团队处理join数据倾斜的实操路径
北京地区互联网公司密集,数据团队面试和实际工作中经常被问到“join数据倾斜怎么处理”,这里给出一条可复用的路径,不依赖特定云厂商,适合大多数使用Spark或Hive的批处理场景。
定位热点key的具体命令
第一步是确认倾斜发生在哪个join阶段,打开Spark UI,找到耗时最长的Stage,点击查看Summary Metrics,对比不同task的Duration和Shuffle Read Size,记录下对应的partition id。
然后定位热点key,在Spark SQL里执行:
SELECT join_key, COUNT() AS cnt
FROM large_table
GROUP BY join_key
ORDER BY cnt DESC
LIMIT 50
这个查询用于诊断,不是生产作业,更好的方式是用Spark DataFrame的groupBy("join_key").count().orderBy(desc("count")).show(50),它不会强制单分区,也不会占用过多driver资源。
加盐拆分的执行细节
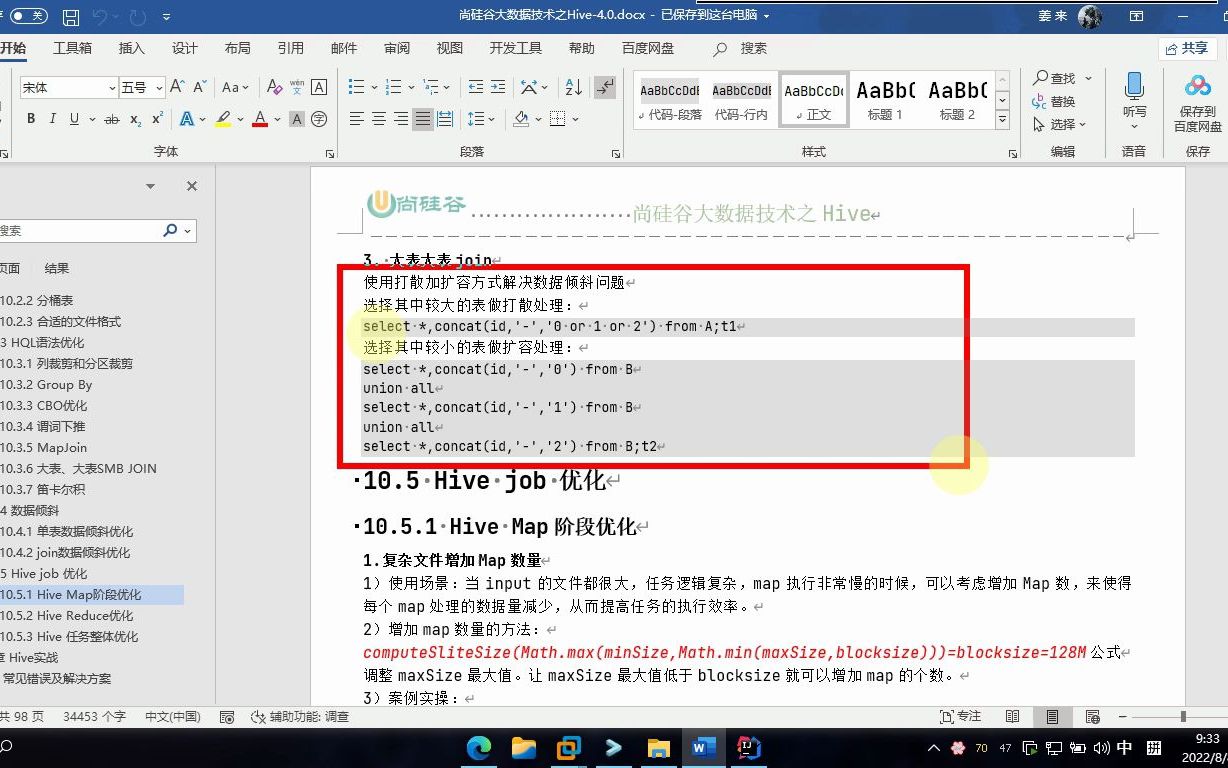
如果小表体积在几GB以内,直接广播join,例如Spark SQL提示/+ BROADCAST(small_table) /,如果小表太大无法广播,就用加盐打散,做法是给热点key加上随机后缀,join后恢复原始key,恢复逻辑要写对,否则结果会多出重复行或丢失匹配关系,Hive里可以设置set hive.optimize.skewjoin=true;和set hive.skewjoin.key=100000;,让超过阈值的key单独处理。
加盐会增加shuffle数据量和作业阶段,不能盲目使用,先观察shuffle分区数,如果分区数从200提到2000,倾斜程度会被稀释,但会带来更多小文件和小task,行业共识认为,合理的shuffle分区数应该让每个task处理的数据量控制在几百MB级别,而不是单纯把数字调大。
大规模join查询数据倾斜的预防策略
除了事后处理,日常建模和建表阶段就能降低倾斜概率。
- 维度表设计时,对可能成为热点的属性建立分桶表,让join在分桶上进行,减少全量shuffle。
- 事实表和维度表join时,优先使用主键或高基数字段,避免用低基数枚举值做join键。
- 对历史数据做周期扫描,监控join键的top值占比和分布极差,业内专家指出,多数生产事故都源自缺少对关键字段分布变化的监控。
- 在Flink实时任务中配置合理的并行度和
table.exec.source.idle-timeout,防止大促流量瞬间涌入造成局部热点。
这些预防工作不能保证完全杜绝倾斜,但能把故障发生频率压低,倾斜本质上是数据分布问题,不是纯代码问题,它和业务活动、季节因素、地域分布都有关系。
大规模join查询的优化,从来不该只盯着资源参数,真正要解决的是让数据在各个节点上大致均匀地流动,能把倾斜key找出来、拆开、聚合回去,比单纯加内存、加并行度可靠得多。
Q&A:大规模join查询数据倾斜常见疑问
为什么大规模join查询数据倾斜经常被误判为资源不足?
任务变慢或失败时,第一反应往往是加内存、加CPU,数据倾斜的表现是少数task耗时远超其他task,资源利用曲线通常显示大部分节点空闲,少数节点满载,如果只看整体资源使用率,会误以为资源不够,真正应该看的是task粒度的耗时分布和shuffle数据量分布,而不是整体负载。
大规模join查询数据倾斜在Spark里能自动处理吗?
Spark 3.x的AQE可以自动处理部分倾斜,但前提是倾斜发生在shuffle之后,且统计信息足够准确,打开spark.sql.adaptive.skewJoin.enabled=true后,倾斜分区会被自动拆分成多个子分区,但如果倾斜key在shuffle前已经造成上游task严重不均衡,或者key分布在join两侧不一致,自动处理仍然可能失效,需要人工介入。
大规模join查询数据倾斜用加盐会不会导致结果错误?
不会,加盐只改变shuffle时的key分布,不会改变最终结果,做法是给join键拼上随机数,让倾斜key分散到不同分区,完成预计算后再把随机数去掉做最终计算,只要恢复逻辑写对,数据不会重复也不会丢失,加盐的代价是shuffle数据量上升和作业阶段增多,但相比单个task超时失败,通常更划算,数据倾斜问题的最终判断标准永远是task级别的耗时差异是否被有效缩小。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639727.html