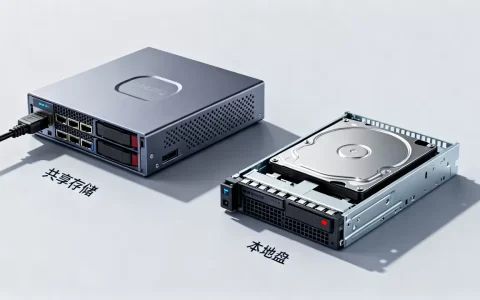
内存计算型实例的核心价值就是把热点数据集全部驻留内存,让读请求绕开磁盘与网络存储,直接在内存里完成命中,如果你的业务存在高频访问、低延迟要求的少量热数据,选它基本不会错。
内存计算型实例适合哪些场景?先看懂热点数据驻留内存的逻辑
很多人一听到内存计算型实例,第一反应是“贵”,但贵有贵的道理,它把内存当成主存储,而不是缓存,常规云服务器里,内存只是CPU和磁盘之间的中转站,内存计算型实例直接让数据长期“住”在内存里,省掉每次访问都要去磁盘捞数据的动作。

- 内存随机访问延迟大约在几十到一百纳秒级别
- 普通SSD随机读延迟在几十到一百微秒级别
- 两者相差近三个数量级
这个差距放到单次请求里可能不明显,但热点数据集每秒被访问几万次、几十万次时,累计延迟会直接影响用户体验和转化率。
为什么要把热点数据集全部驻留内存
热点数据有典型的“二八特征”,少数key承担了绝大多数读流量,比如电商大促时的商品库存、用户会话、购物车信息、优惠券余量,这些数据体积可能只占全量数据的很小一部分,但访问频率极高。
把这类数据全部驻留内存,意味着:
- 读路径缩短为“业务进程直接访问内存地址”
- 不再依赖缓存命中率,避免缓存穿透、击穿、雪崩
- 写入可以直接在内存中完成,异步刷盘即可
热点数据全部驻留内存方案的前提是:你得先识别出哪些数据真“热”,不能把几百GB冷数据也塞进去,那样成本会失控。
实时推荐与风控:最典型的全内存场景
实时推荐引擎通常需要毫秒级返回结果,用户浏览行为、商品特征、相似度矩阵这类数据,如果放在磁盘数据库里,join和聚合会把延迟拖到几百毫秒,内存计算型实例可以直接把特征向量和召回索引放进内存,配合向量检索,单次推荐延迟能压到个位数毫秒。
实时风控也一样,每一笔交易都要在几十毫秒内跑完规则和模型,规则库、黑名单、设备指纹库这类数据天然适合全部驻留内存,多数情况下,风控规则库的体积并不大,几十MB到几GB级别,但要求极快读取。
内存型服务器和计算型服务器区别,别只看CPU主频
很多人在选型时会纠结:同样是云服务器,为什么内存型比计算型贵?内存型服务器和计算型服务器区别主要不在CPU主频,而在于内存与CPU的配比、内存带宽、以及是否针对大内存寻址做了优化。
两者硬件与性能侧重
| 对比项 | 内存型实例 | 计算型实例 |
|---|---|---|
| 内存/CPU配比 | 通常每vCPU配8GB以上内存 | 通常每vCPU配2GB到4GB内存 |
| CPU主频 | 主流或略低,少部分高频 | 通常更高,强调单核性能 |
| 内存带宽 | 高,支持多通道大容量 | 一般,满足常规计算即可 |
| 适用场景 | Redis、SAP HANA、Spark、实时分析 | 高并发Web、批处理、视频转码 |
| 价格趋势 | 同等CPU规格下更贵 | 相对便宜,内存较少 |
可以看出,内存型实例贵在内存密度和带宽,不是单纯给CPU加钱,如果你跑的是Redis Cluster、Memcached、或者需要把整个特征库加载到内存的服务,选计算型会很快碰到内存瓶颈,频繁触发OOM或者swap。
选型时的关键指标
- 内存容量:先估算热点数据集大小,再预留足够余量
- 内存带宽:高并发读写下,带宽比容量更容易成为瓶颈
- NUMA架构:大内存实例通常是多NUMA节点,跨节点访问会变慢
- 持久化能力:是否支持本地NVMe临时盘做AOF或快照
业内专家指出,内存带宽不足会直接拖垮高并发读写性能,比CPU主频的影响更直接。
实操时,登录实例后可以用 free -h 查看内存总量和已用情况,再用 redis-cli info memory 查看Redis的峰值内存和碎片率,如果碎片率持续高于1.5,就要考虑重启或调整内存分配策略。
热点数据集全部驻留内存,容量怎么规划
容量规划不是拍脑袋,建议按以下步骤走:
- 用
redis-cli --bigkeys找出大key和热点key的分布 - 统计最近7天的访问日志,按key聚合请求次数
-

计算少数高频热key占用的内存容量
- 乘以一个安全系数作为实例内存下限
- 如果数据有季节性峰值,按峰值规划
很多团队犯的错误是:拿全量数据大小去选内存型实例,那样会得出一个天价配置,你只需要把热点数据集全部驻留内存,冷数据可以留在磁盘或者对象存储里。
内存计算型实例价格一般多少?省预算的三种方式
这是很多人最关心的问题,内存计算型实例没有统一标价,不同云厂商、不同地域、不同计费方式差异很大,内存型实例通常比同CPU核心数的计算型实例贵出一截。
省预算不是选小规格,而是:
- 用上一代实例:上一代内存型实例价格通常更低,性能足够多数场景
- 包年包月代替按量付费:长期运行的成本差距非常明显
- 冷热分离:只有热点数据进内存,全量数据放磁盘或对象存储,实例规格可以小很多
举例,北京地区某主流云厂商的内存型实例,包年价格通常比按量付费低一大截,不过具体折扣会随活动变化,不能拿某个固定数字当参考。
北京地区内存计算型实例选择,关注这几点
如果你在北京部署,北京地区内存计算型实例选择建议优先看:
- 可用区之间的网络延迟:同城不同可用区之间一般1ms左右,跨可用区部署Redis集群没问题
- 专线接入:如果公司机房在北京,需要拉专线到云VPC,注意专线带宽和成本
- 数据合规:北京地区对金融、政务类业务有明确的数据驻留要求,选本地Region即可
- 现货与抢占式实例:北京作为一线地域,资源紧张时部分规格可能缺货,建议提前锁单
很多用户会对比北京、上海、广州三个Region的价格,同一实例规格在一线城市Region价差很小,主要区别在于资源库存和网络互联。
把数据驻留内存后,持久化与容灾怎么做
内存有个天然短板:断电丢数据,所以不能只把数据丢进内存就完事,持久化策略必须跟上。
RDB/AOF与快照策略
- RDB快照:定期把内存数据写成二进制文件,适合全量备份
- AOF日志:每次写操作追加到日志,数据更完整,但文件会变大
- 混合持久化:Redis 4.0后支持RDB+AOF混合,恢复速度与数据完整性兼顾
如果你的内存计算型实例跑Redis,建议同时开启AOF和RDB,AOF策略用 everysec,这样可以保证最多丢失1秒数据,再用另一台低配实例做从库,实时同步。
混合存储折中方案
有些场景热点数据虽然需要全部驻留内存,但全量数据也很大,这时可以:
- 热点数据放内存型实例
- 冷数据放云数据库或对象存储
- 中间用缓存策略保证热数据优先加载
行业共识认为,热点数据集驻留内存后,持久化策略必须重新设计,不能沿用之前“磁盘数据库”那套容灾逻辑,内存实例的持久化更依赖网络复制和快速快照,而不是本地磁盘冗余。
内存计算型实例不是万能的,它只适合那些热点数据体积可控、访问频率极高、对延迟敏感的负载,把热点数据集全部驻留内存,等于把最常用的工具全部摆在工作台上,伸手就能用,但工作台面积有限,你得先搞清楚哪些工具真用得着,容量规划、持久化、成本控制,这三件事做扎实了,内存型实例的性价比才会真正体现出来。
内存计算型实例热点数据驻留内存常见问题
内存计算型实例适合哪些场景?
内存计算型实例适合实时推荐、实时风控、Redis缓存、SAP HANA分析、Spark内存计算、高频交易撮合等场景,只要热点数据集可以全部驻留内存,且单次访问延迟要求毫秒级,这类实例就比普通计算型实例更合适。
热点数据集全部驻留内存会不会成本很高?
短期看确实比普通云服务器贵,但多数情况下,热点数据集只占全量数据的一小部分,通过冷热分离,只用一台中等规格的内存型实例就能扛住核心读流量,综合运维成本和性能损失,多数团队认为值得投入。
内存计算型实例和普通云服务器在持久化上有什么不同?
普通云服务器依赖本地SSD或云盘保证数据持久性,掉电后数据仍在,内存计算型实例的数据本身在内存中,掉电即失,因此必须依赖RDB、AOF、主从复制或外部持久化存储来兜底,多数生产环境会同时开启RDB和AOF,并配置从库实时同步。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639720.html