训练数据预处理流水线的吞吐优化,核心思路是让每个环节都能并行跑起来,而不是排队等下一个环节,先把最慢的瓶颈点找出来,再对症下药。
做深度学习训练的人,几乎都遇到过GPU空转、显存吃不满、训练进度条半天不走的情况,模型代码没问题,网络结构也正常,问题往往就出在数据预处理这条流水线上,流水线堵住了,GPU再强也白搭。

数据预处理流水线吞吐量怎么优化
先给流水线做个“体检”:瓶颈到底在哪
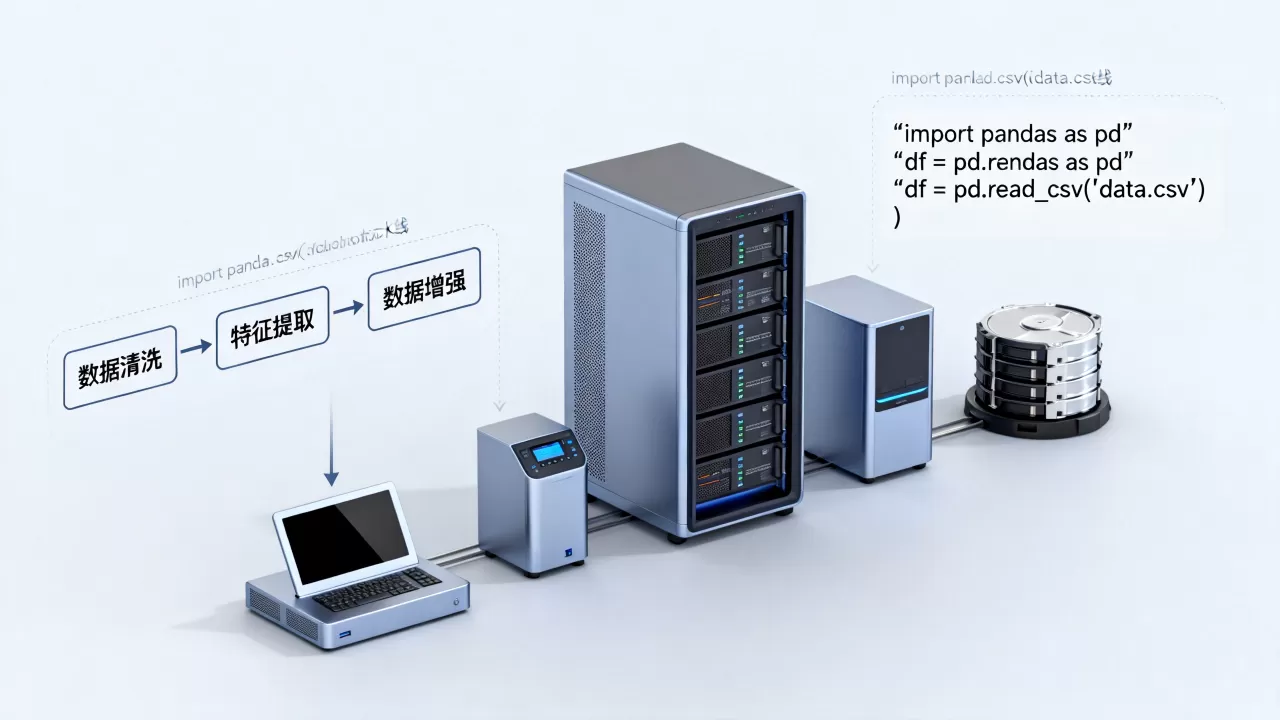
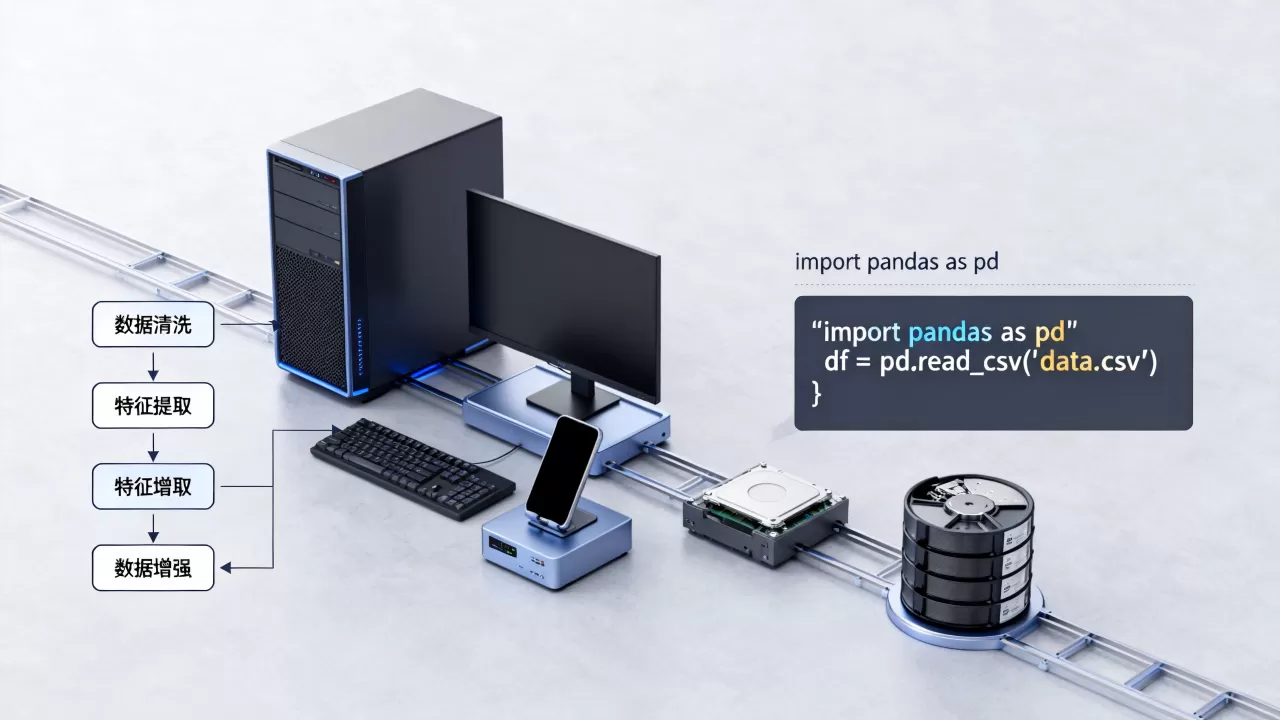
数据从磁盘到GPU显存,中间要经历好几道工序,业界常把它拆成四个阶段:
- 数据读取:从SSD、HDD或网络存储把原始文件读进内存
- 解码与预处理:图片解码、缩放、归一化,文本的tokenize,音频的fbank提取
- 数据增强:随机裁剪、翻转、色彩抖动等在线增强操作
- 批处理与传输:把单个样本拼成batch,拷贝到GPU显存
多数情况下,训练速度上不去,不是GPU不行,而是CPU在解码、增强、搬运数据这块忙不过来,业内专家指出,在常规的图片分类任务里,CPU预处理耗时经常占到一次迭代总耗时的30%以上,复杂增强策略下这个比例只会更高。
一个实用的排查方法:用nvidia-smi监控GPU利用率,如果利用率长期低于80%,同时CPU跑满、磁盘队列深度打满,基本可以断定瓶颈在前端。
核心优化思路:把流水线从“排队”改成“并行”
流水线的本质是“产销配合”,串行模式下,GPU每算完一个batch,CPU才开始准备下一个,等待时间成倍放大,并行化的思路是让读取、预处理、传输三个环节各干各的,用队列把数据囤起来。
具体操作路径,以PyTorch为例:
- 把
DataLoader的num_workers调高,让多个子进程同时干活 - 设置
prefetch_factor,让每个worker多预取几批数据 - 打开
pin_memory=True,加速CPU到GPU的数据拷贝
这套组合拳打下来,吞吐量通常会有数倍提升,但要注意,num_workers不是越大越好,开太多会导致进程频繁切换,反而拖慢速度,一般从
4开始测,逐步加到8、16,观察训练速度的边际收益。
深度学习训练数据加载太慢怎么办:框架级调优实操
PyTorch DataLoader参数调优细节
先说说num_workers,这个参数代表子进程数量,理论上越多越好,但受限于CPU核心数和内存带宽,如果你的机器是8核,开到8到16之间比较合理;如果跑在共享服务器上,还得考虑同机其他任务的干扰。
prefetch_factor是个容易被忽略的参数,默认值只有2,把它调大到4或8,可以让每个worker多干点“预读”的活,对于读取慢的机械硬盘场景尤其有效。
pin_memory=True配合GPU训练,相当于给数据传输修了一条高速路,主机内存到显存的拷贝效率能提高一大截。
TensorFlow tf.data管道性能优化
TensorFlow生态推荐用tf.data构建数据管道,几个关键优化项:
map(num_parallel_calls=tf.data.AUTOTUNE):让map操作里的解码、增强并行执行cache():把经过预处理的数据缓存到内存或磁盘,减少重复计算prefetch(tf.data.AUTOTUNE):和PyTorch的prefetch_factor思路一致interleave配合num_parallel_calls:并行读取多个文件,适合TFRecord这种分片数据
tf.data还有个常用手法是把batch放在map后面,先做逐样本增强,再批处理,能减少batch拼接时的张量碎片化问题。
数据增强CPU瓶颈怎么解决:从架构上做减法
数据增强是预处理流水线里最吃CPU的环节之一,在线增强虽然灵活,但代价是每个epoch都得重新算一遍,如果增强策略太复杂,可以考虑两个方向:
- 增强写入缓存:把增强后的结果缓存下来,下一次sample直接读缓存
- 离线增强外置:把增强好的数据提前存成TFRecord或LMDB格式,训练时只做读取和供给
这两种方案都能让CPU从繁重的计算中解放出来,牺牲一些实时性,换来的是更高的吞吐上限。
从磁盘到内存:存储层与数据格式的优化
小文件读写的性能陷阱
训练数据是几万张几十KB的图片时,每步都在做随机小文件读取,磁盘IO会成为一个隐形瓶颈,SSD还能勉强支撑,机械硬盘基本会拖垮整个流水线。
解决办法之一是合并文件:把大量小图片打包成一个TFRecord或一个大容量LMDB文件,顺序读取的效率远高于随机读取,打包后的文件在分布式训练场景下也更友好,拷贝到各个worker节点更省时间。
行业共识认为,文件数量能减少一个数量级,读取性能就能提升一个数量级,这在对象存储场景尤为明显。
内存文件系统与预加载机制
数据量不大(比如几GB级别)的情况下,直接把数据加载进内存文件系统是个简单粗暴但有效的方案,Linux下的/dev/shm就是这样一个目录,把数据集放进去,读取速度能逼近内存带宽。
另一种思路是预加载到内存再启动训练:先把数据一次性读进Python内存或NumPy数组,训练时直接从内存切片,完全绕过磁盘IO,这个方案尤其适合小数据集上的原型验证。
端到端吞吐优化的完整策略与验证方法
从单点到全局:给流水线做系统性升级
单单调几个参数还不够,完整的吞吐优化方案更像一个系统工程的组合拳,推荐的一套组合策略:
- 存储层:用NVMe SSD和提升内存容量,减少磁盘交换
- 格式层:优先使用TFRecord或LMDB,避免海量小文件读取
- 框架层:合理设置DataLoader或tf.data的并行参数
- 架构层:必要时采用DGX等整体式架构,或使用缓存服务
- 监控层:用Profiler工具(如PyTorch Profiler、TensorFlow Profiler)定期分析各阶段耗时占比
- 数据供给与GPU算力匹配:以GPU实际利用率而非单环节速度为准绳
如何用量化指标验证优化效果
用什么指标判断优化成功?不只看预处理时间,更关键的是端到端的训练吞吐量,即每秒处理的样本数。
一个可行的验证路径:
- 先记录当前iteration耗时和GPU利用率
- 逐步调整参数,观察GPU利用率和训练吞吐量的变化
- 用
torch.profiler或tf.profiler生成各阶段耗时占比报告 - 对比优化前后的统计数据,找到“CPU等待GPU”还是“GPU等待CPU”的转变点
优化目标不是让某个环节跑得最快,而是让整个流水线稳定满负荷运转。
常见问题与调优误区
prefetch_factor设置过大会有什么副作用
可能拖慢速度,因为每个worker都要额外占用内存存储预取数据,内存吃紧时反而触发交换到磁盘的操作,得不偿失,推荐在内存充裕的情况下适当调大,观察内存占用和训练速度的平衡点。
多人共用服务器的预处理参数怎么设置
这属于典型的并发场景问题,多个训练任务抢CPU资源时,我们可以显式设置taskset或容器CPU limit限制任务绑核,避免进程频繁迁移,配合降频运行,整体任务的总吞吐反而更高。
PyTorch DataLoader num_workers设置多少合适
有经验的工程师会告诉你,没有固定答案,常规做法是先用CPU核心数的一半起步,逐步翻倍,同时监控训练速度和内存占用,如果你的CPU核心数是12,建议从6开始,最高不要超过12,多数情况下,num_workers为4到8就能把GPU喂饱,再往上加的收益越来越小,内存开销却直线上升。
数据预处理流水线吞吐优化常见问答
数据预处理慢会影响模型最终精度吗
不会,预处理速度只影响训练迭代速度,不改变数据的分布和内容,但要注意,如果在优化过程中改了预处理逻辑(比如把增强顺序颠倒、换了解码库),结果可能略有差异,优化后最好用同样配置跑几个epoch,对比loss曲线的变化趋势是否一致。
为什么调高num_workers后GPU利用率反而下降了
两种情况比较常见,一是数据量太小,worker进程启动和通信的开销超过了并行读取的收益;二是内存带宽饱和,多个worker同时读写内存,反而造成了资源争抢,遇到这种情况,把worker数降下来,或者换用更轻量级的数据格式(比如TFRecord),通常就能恢复。
训练数据预处理流水线的吞吐优化,核心落在“并行”和“减负”两个词上,先用监控工具定位瓶颈,再根据瓶颈类型选择对应的并行策略和缓存方案,最后用端到端吞吐量来验证效果,数据管线顺畅了,GPU才能把每一分算力都花在刀刃上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625088.html